- 09.04.2024
- 30.10.2026
- выступления
- #NLP
На канале DS Talks разбирали статью BLADE: Enhancing Black-box Large Language Models with Small Domain-Specific Models.
Слайды: blade.pdf
Текстовая расшифровка доклада (автоматическая, еще не вычитана):
Из зала: Ага, и можно начинать.
Дмитрий: Ага. Я сегодня хотел рассказать про статью BLADE: Enhancing Black-box Language Large Language Models with Small Domain-Specific Models, то есть идея о том, что мы можем не доучивать большую языковую модель под нашу доменную область, а подсунуть маленькую языковую модель, которую доучили, и она большую сама всему, чего надо, научит.
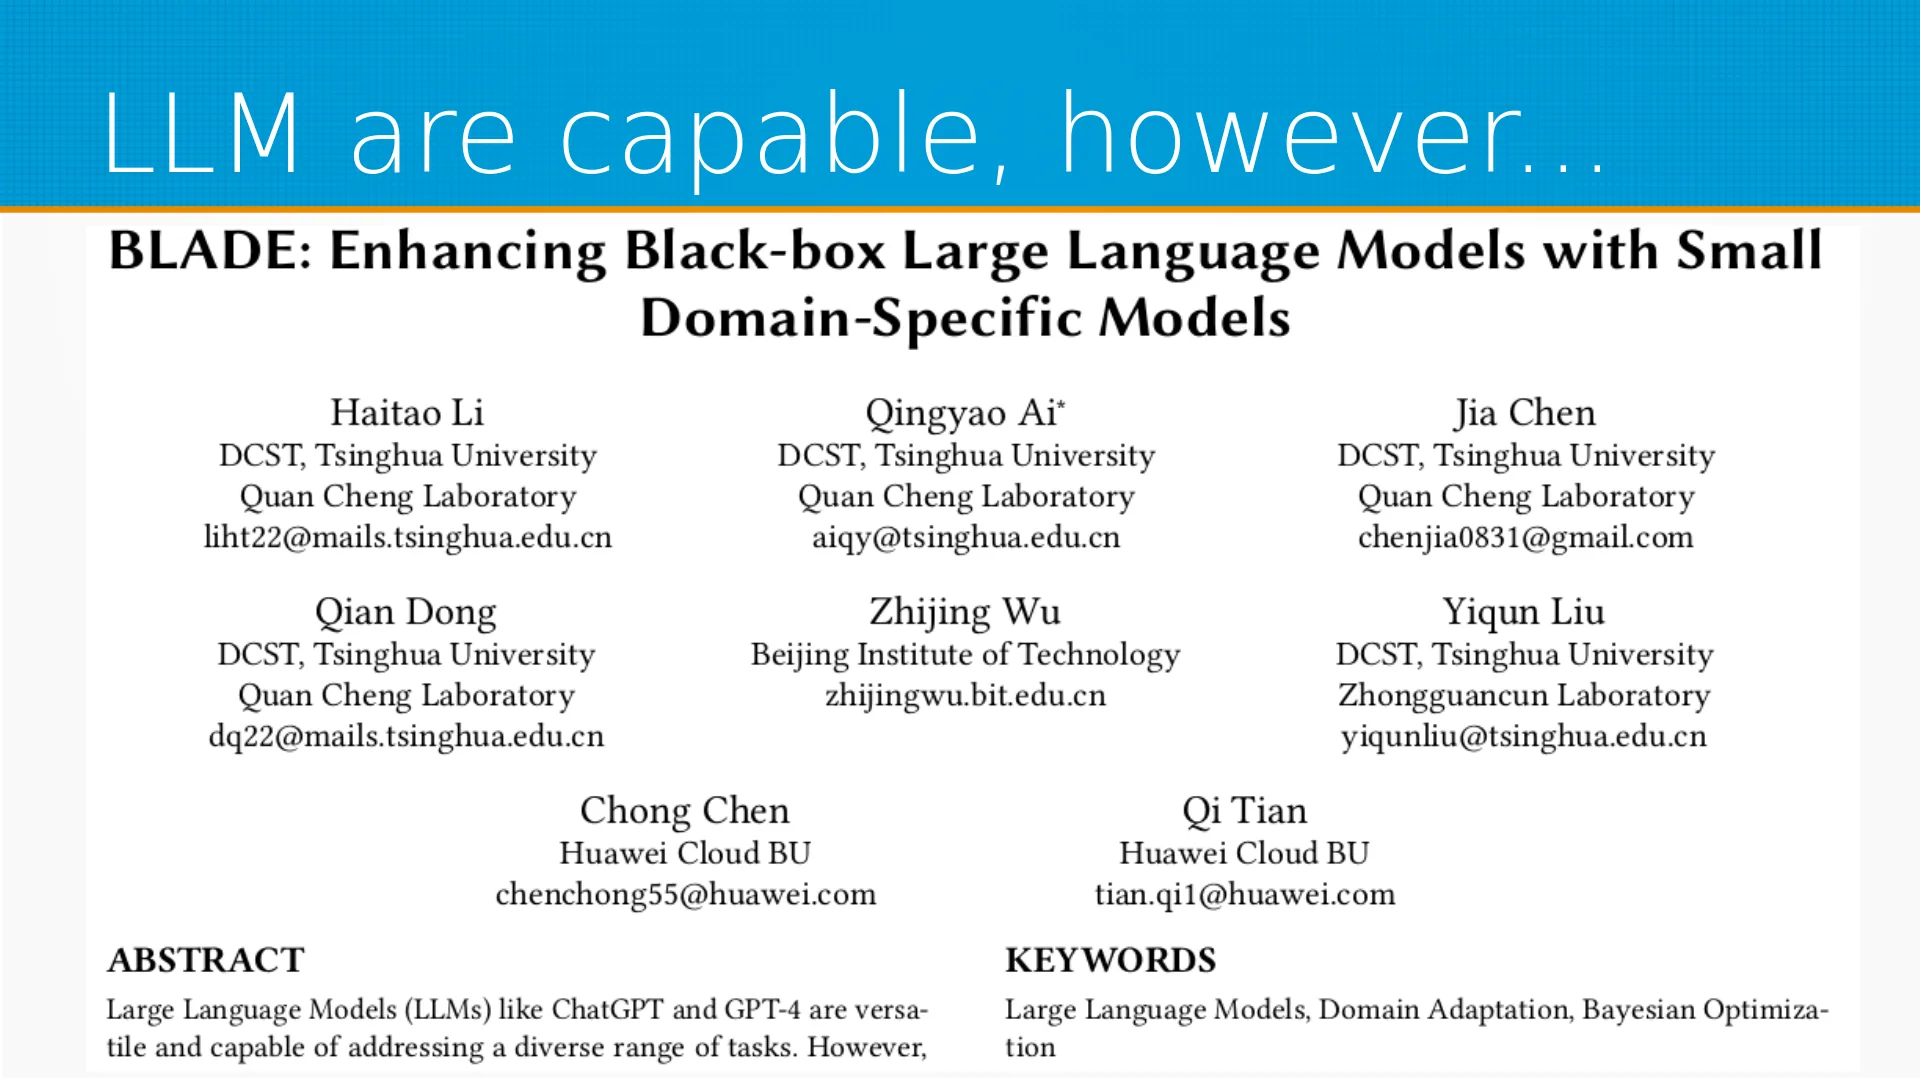
И основная мысль статьи этой, что языковые модели много чего могут, научить их больно хлопотно под каждую задачу, под каждый чих. И статья как раз претендует на то, что они упрощают процедуру адаптации большой языковой модели под задачу. Статью написала группа товарищей из Китая, и про них сказать только можно, что все они хорошо уже процитированы. И там от у первого Хайтао Ли у него в марте вышло три хороших статьи. Непонятно, откуда они все берутся. Китайцы вообще много публикуются.
И в частности, эта группа исследователей, она ассоциирована с Huawei, то есть часть из них с Huawei Cloud Business Unit. Часть из них Beijing Institute технологический. Вот, но основная часть - это Tsinghua University. Это вроде МГУ китайского. Один из его выпускников сейчас руководит Китаем. Например. И в 2021 году Tsinghua University открыли Quancheng Laboratory. Она не совсем в Пекине, она ближе к побережью, там, где как раз промышленный кластер, занимается она кибербезопасностью, что интересно. И вот эта лаборатория кибербезопасности выпустила ряд статей про, хмм то, как языковыми моделями работать с юридическими документами. Буквально через несколько дней после того, как вышла вот эта статья, вышла статья DELTA Legal Case Retrieval, тоже очень интересная.
Там те же самые авторы, те же самые данные, ну и у меня параноидальное предположение, что они сидят и пилят киберсудью китайского. В чём, собственно, идея состоит?
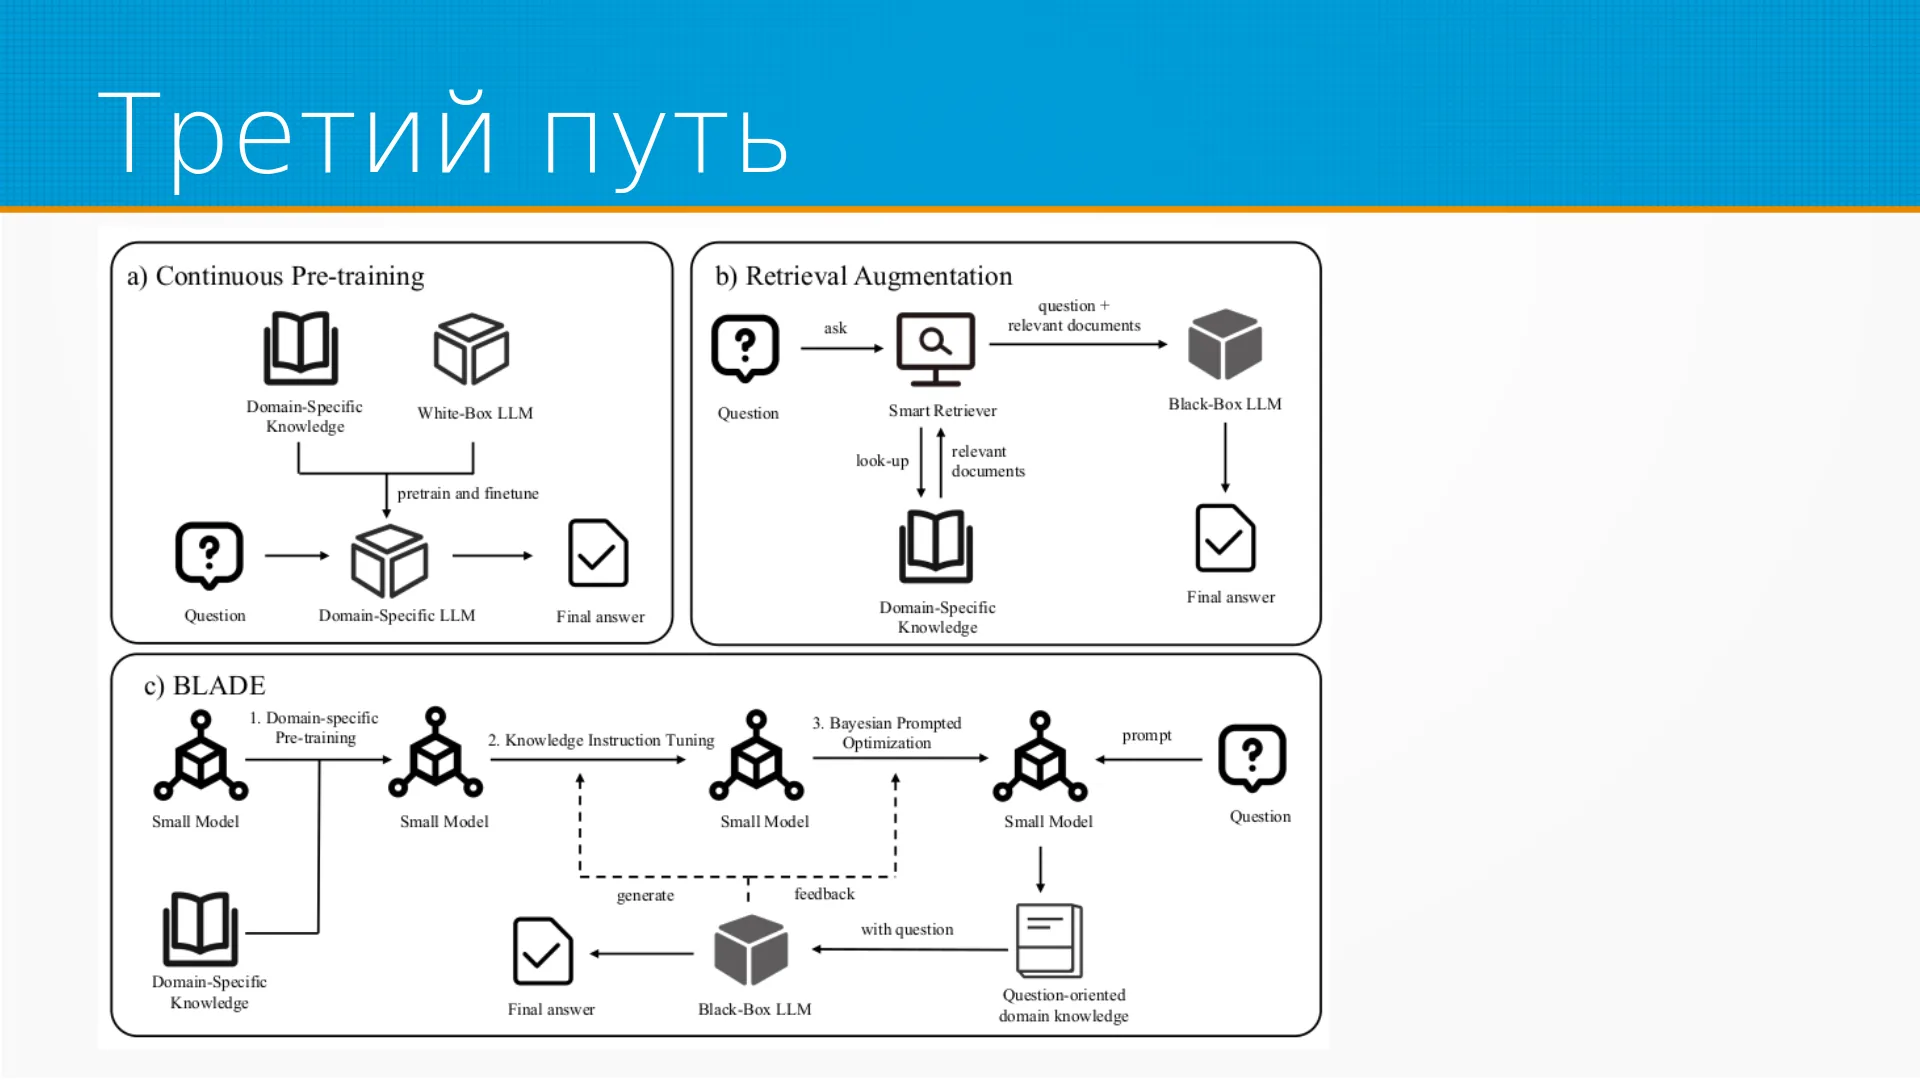
Если нам нужно подтянуть доменные знания в языковую модель, мы можем, конечно, просто её доучить. Тут вот на картинке А у нас есть White-box LLM, то есть модель, которую мы можем доучивать. Мы дообучили её знания и получили Domain-Specific LLM, и, в общем, как бы всё хорошо, кроме того, что она неконтролируемо глючит, то есть вообще плохо управляема. Вариант борьбы с этим - это RAG, и мы берём, собственно, делаем ретривер, который берёт наши Domain-Specific Knowledge. Лезит туда в базу готовит промпт, складывает его в Black-box LLM и получает финальный ответ. Авторы статьи говорят, что вот этот вариант глючит больше, чем если просто претрейнить.
Мне кажется, они RAGи просто не умеют готовить, или у них какой-то странный опыт. И вот они предлагают третий вариант. Третий вариант, он многоходовочка. Мы берём маленькую модель и доучиваем её на текстах доменной области. Затем мы специальным образом доучиваем её на instruct instruct tuning, чтобы она умела выполнять команды специальные. После этого мы её ещё раз доучиваем, чтобы она умела выдавать такие тексты, с которыми удобно в промпте работать большой языковой модели. И потом мы получаем вопрос, генерируем этой маленькой моделью доменное какое-то знание, добавляем его в промпт большой языковой модели, которую мы вообще не доучиваем. И вот получаем ответ, получается вроде бы как хорошо.
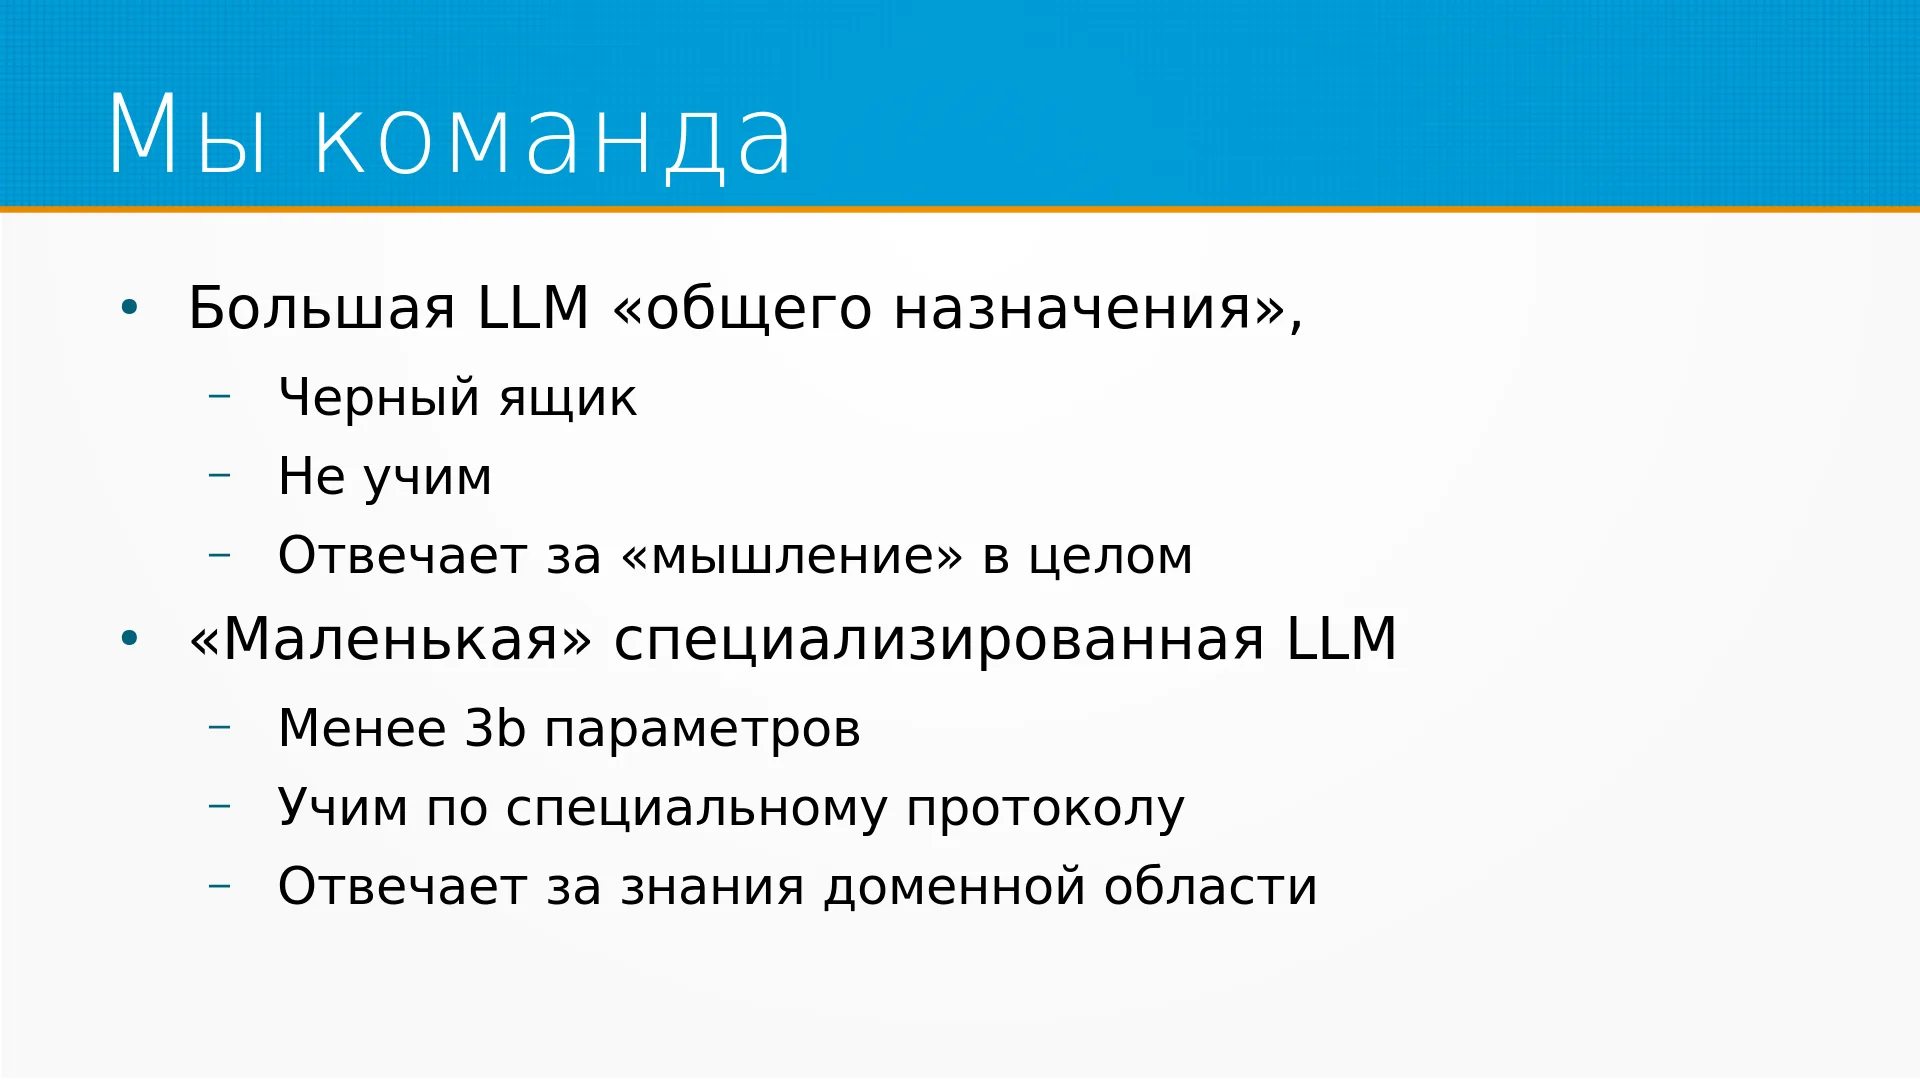
Вот то есть там в этом комбайне участвует большая LLM общего назначения. Они её не учат совсем, и она у них отвечает за как бы мышление. И маленькая специализированная LLM. Маленькая она по-китайски маленькая, то есть они говорят менее 3 млрд параметров, не такая уж и маленькая. Они её учат по специальному протоколу, и она отвечает за знания доменной области.
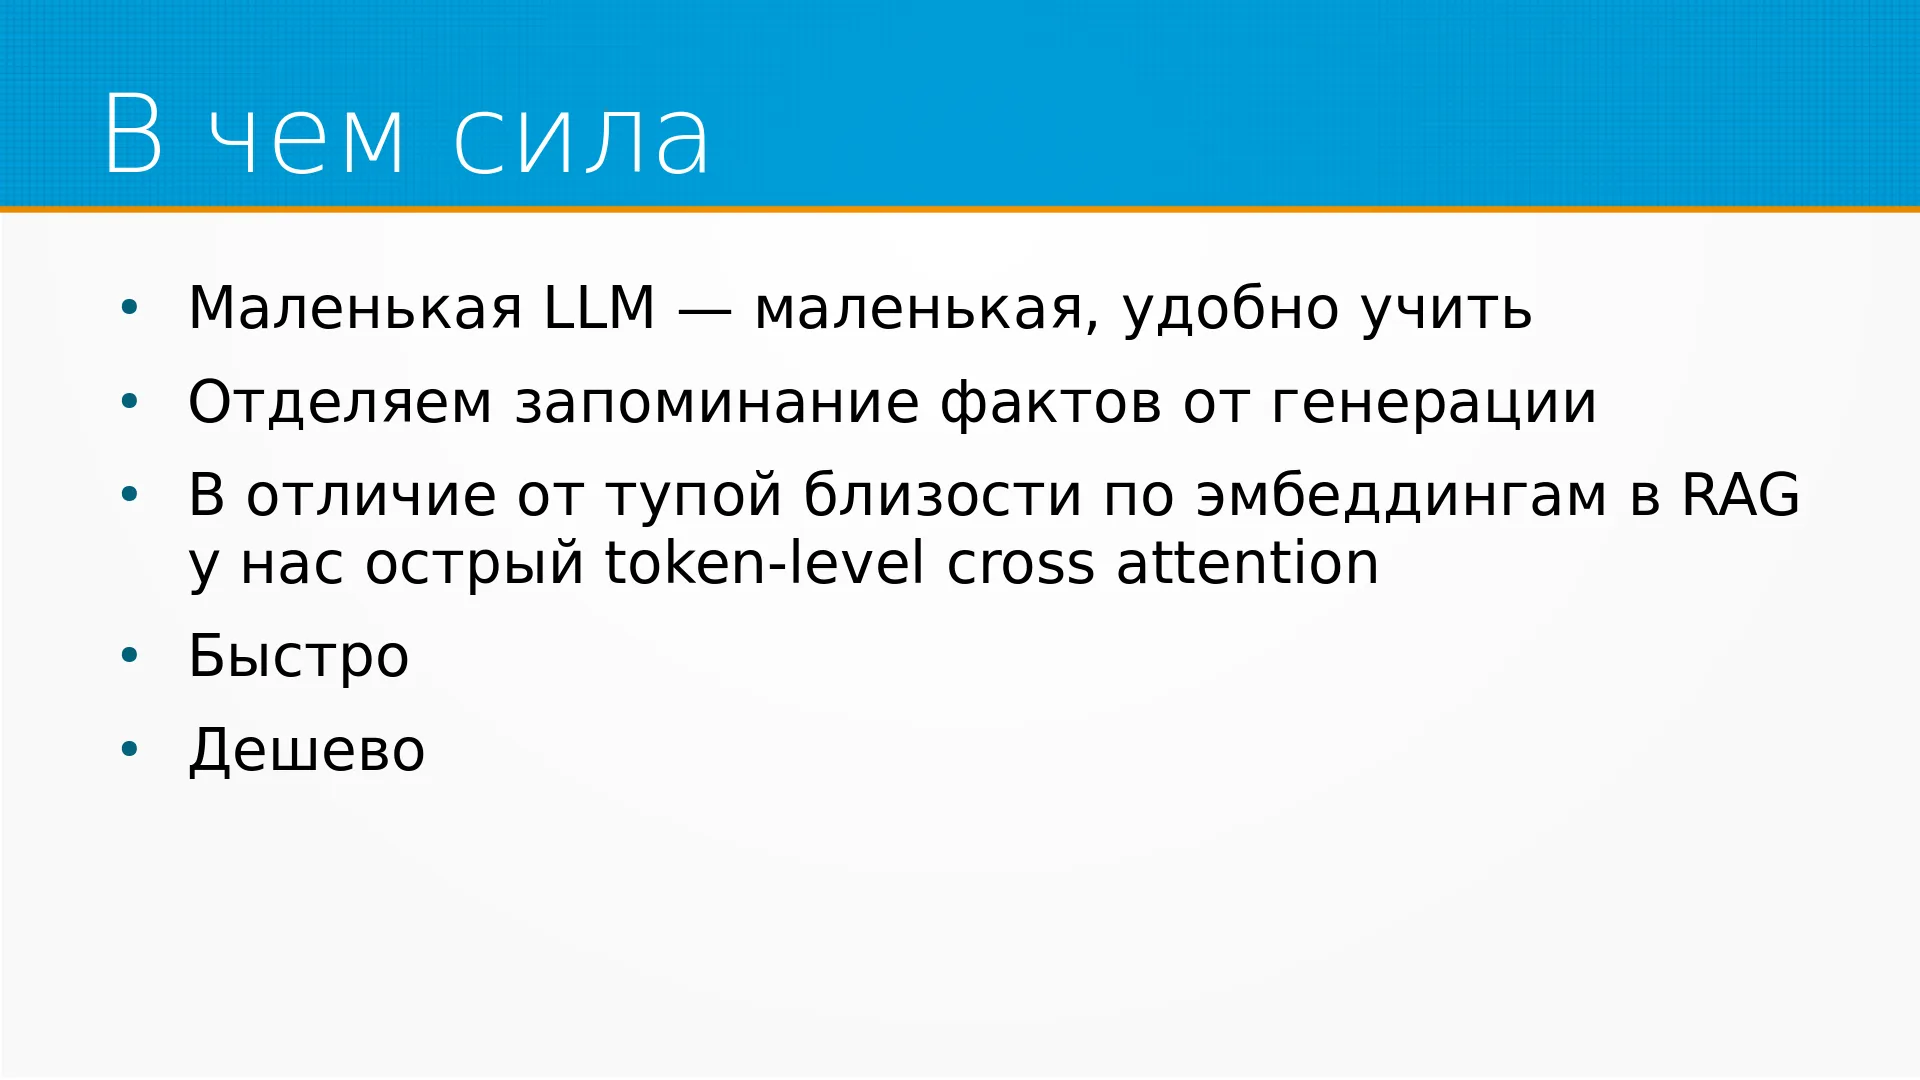
Преимущества понятны, что маленькую LLM можно дообучать. К тому же, она может быть под нашим контролем, в отличие от, например, от Chat GPT, которую можно использовать в качестве большой языковой модели, а дообучать не очень. Плюс они тут делают интересное интересный поинт, что мы тем самым отделяем запоминание фактов от генерации. Если мы не хотим в файн-тюнинг большой языковой модели отдавать наши документы, а мы доучиваем маленькую модель, которую у нас есть силы доучить, то потом мы из неё вытаскиваем уже не сами документы, а только конкретные факты по обстоятельствам. Что безопаснее и проще контролировать утечку, и, в общем, тут просматривается, что если вы сидите в Китае и хотите использовать Chat GPT, то понятно, что нельзя отдавать туда юридические документы, какие-то факты в промпт можно пробрасывать.
И опять же, они говорят: "Вот, в отличие от тупой близости по эмбеддингам в RAGе, у нас там token-level cross attention". В общем, это даже правда, но, мне кажется, за уши притянуто. И они говорят, что это быстро и дёшево. 3 млрд - не так это и быстро, не так это и дёшево, но дешевле, чем Chat GPT обучить.
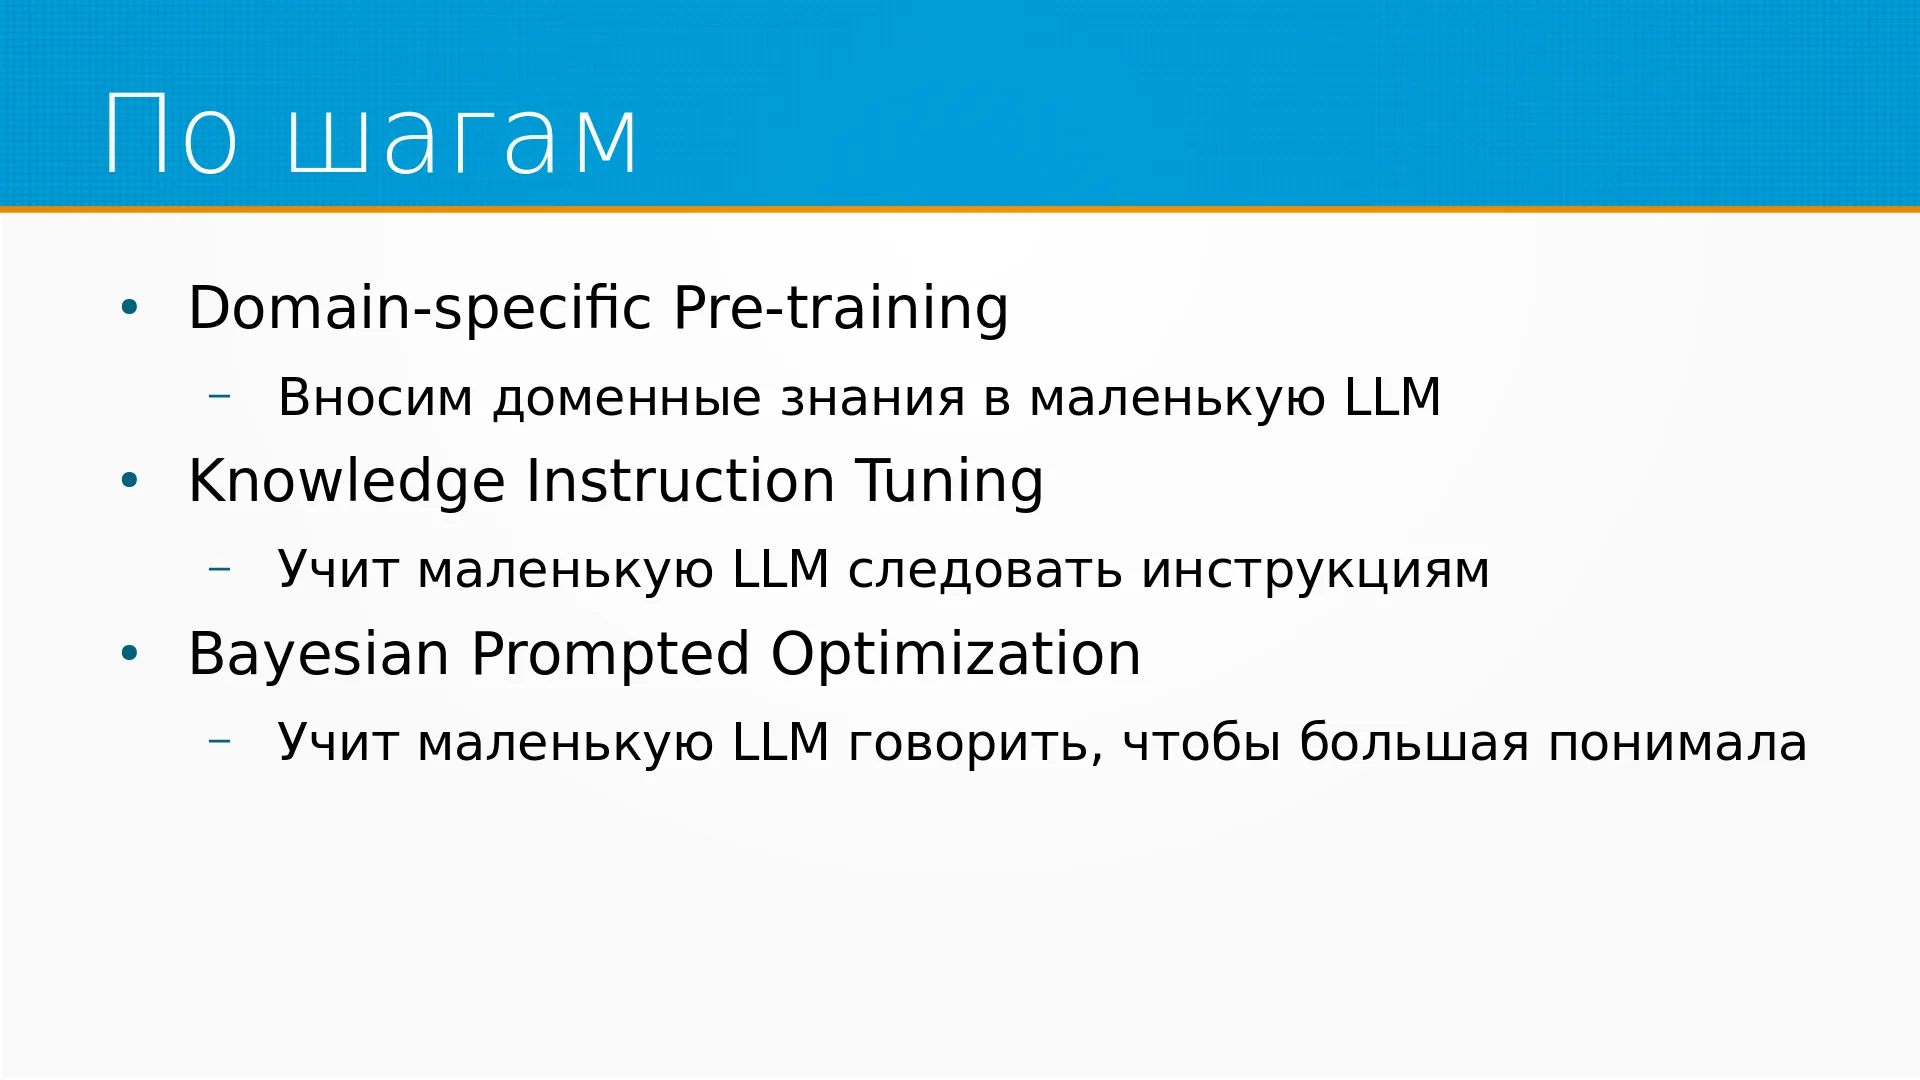
Как всё это делается? Три главных шага. Первое - это Domain-Specific Pre-training, когда мы вносим доменные знания в нашу маленькую LLMку. Затем Knowledge Instruction Tuning, когда мы учим маленькую LLMку следовать инструкциям. И байесовская Prompted Optimization, мы учим маленькую LLMку говорить так, чтобы большая её хорошо понимала. Вот, они в тексте статьи очень широко используют социальные аналогии, типа: "Вот люди предварительно договариваются о сотрудничестве, люди срабатываются", ну и так далее. Прямо вот они такими аналогиями мыслят.
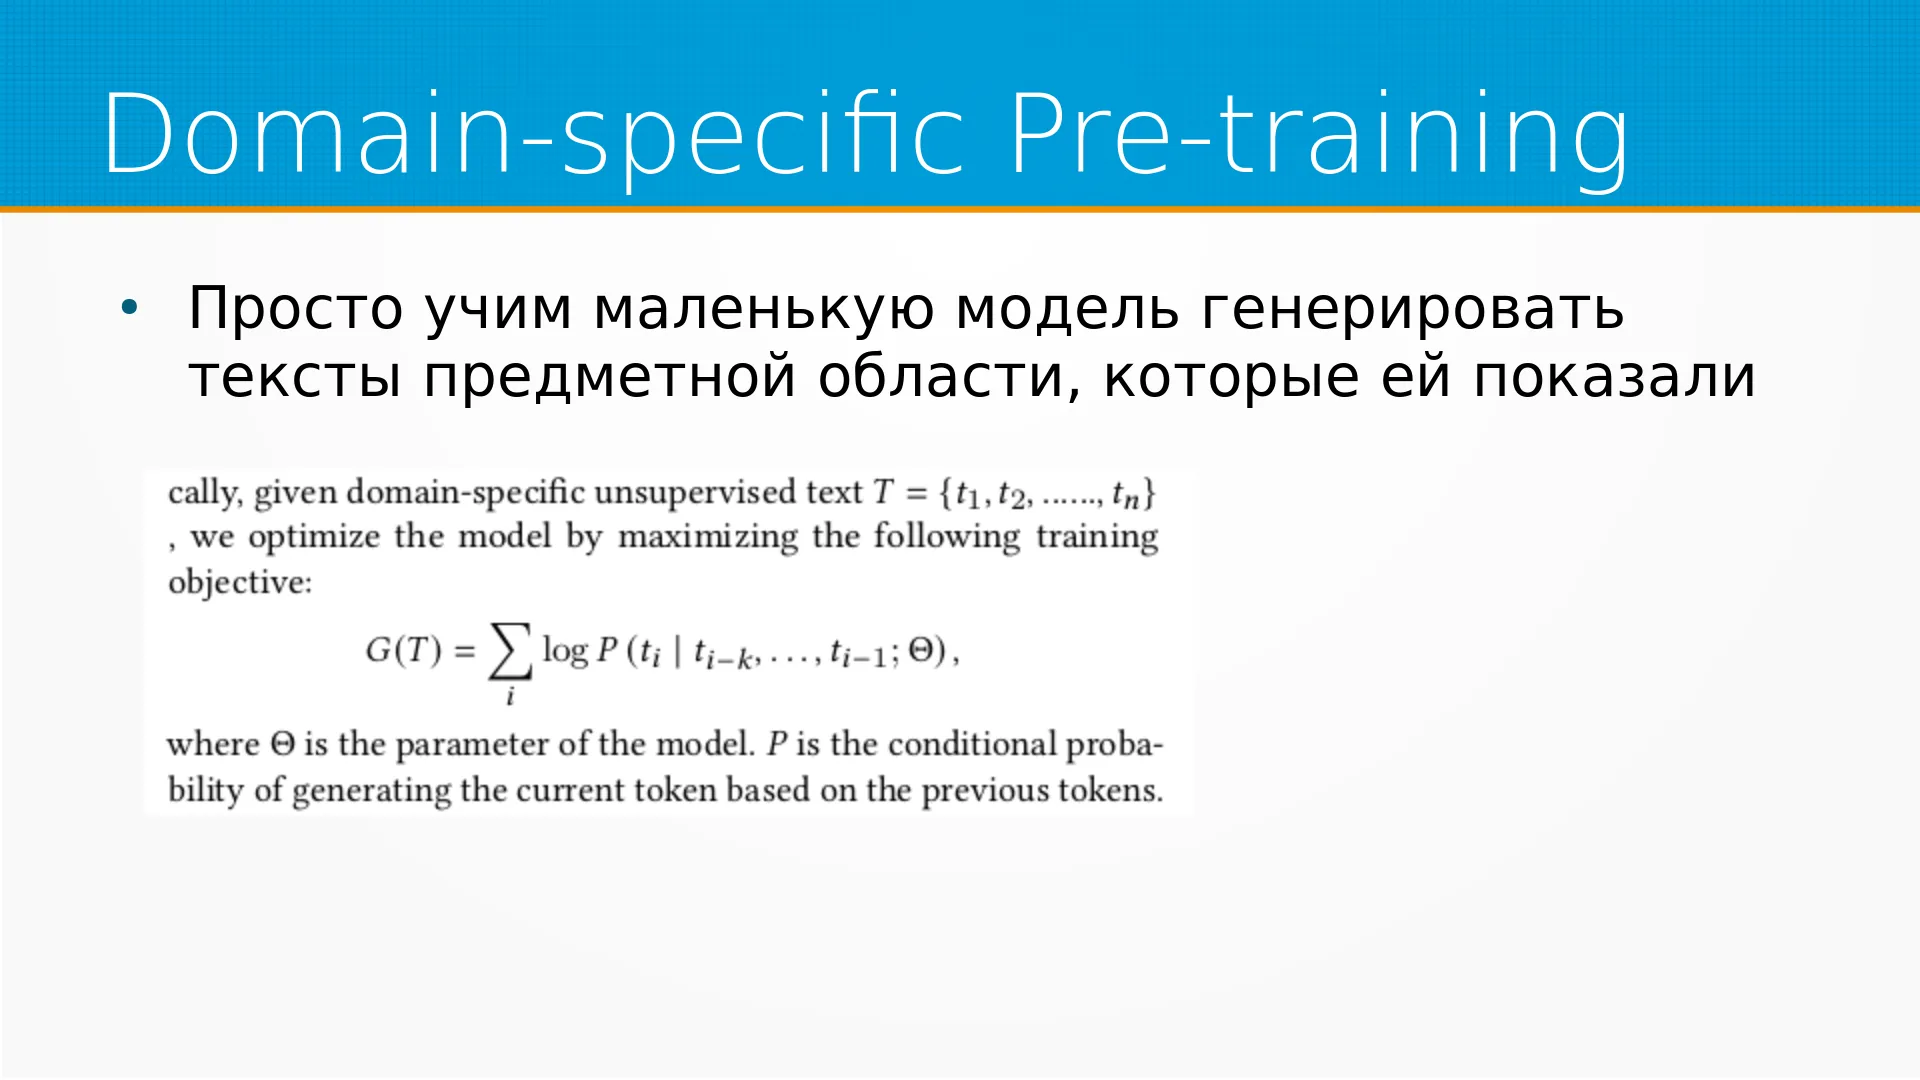
Как производится Domain-Specific Pre-training? Просто это просто претрейнинг. Мы просто учим её с высокой вероятностью воспроизводить те тексты, которые мы ей даём. Тут ничего нового совсем, на мой взгляд. Дальше начинается интересное. Knowledge Instruction Tuning - это трёх шаговая опять же процедура.
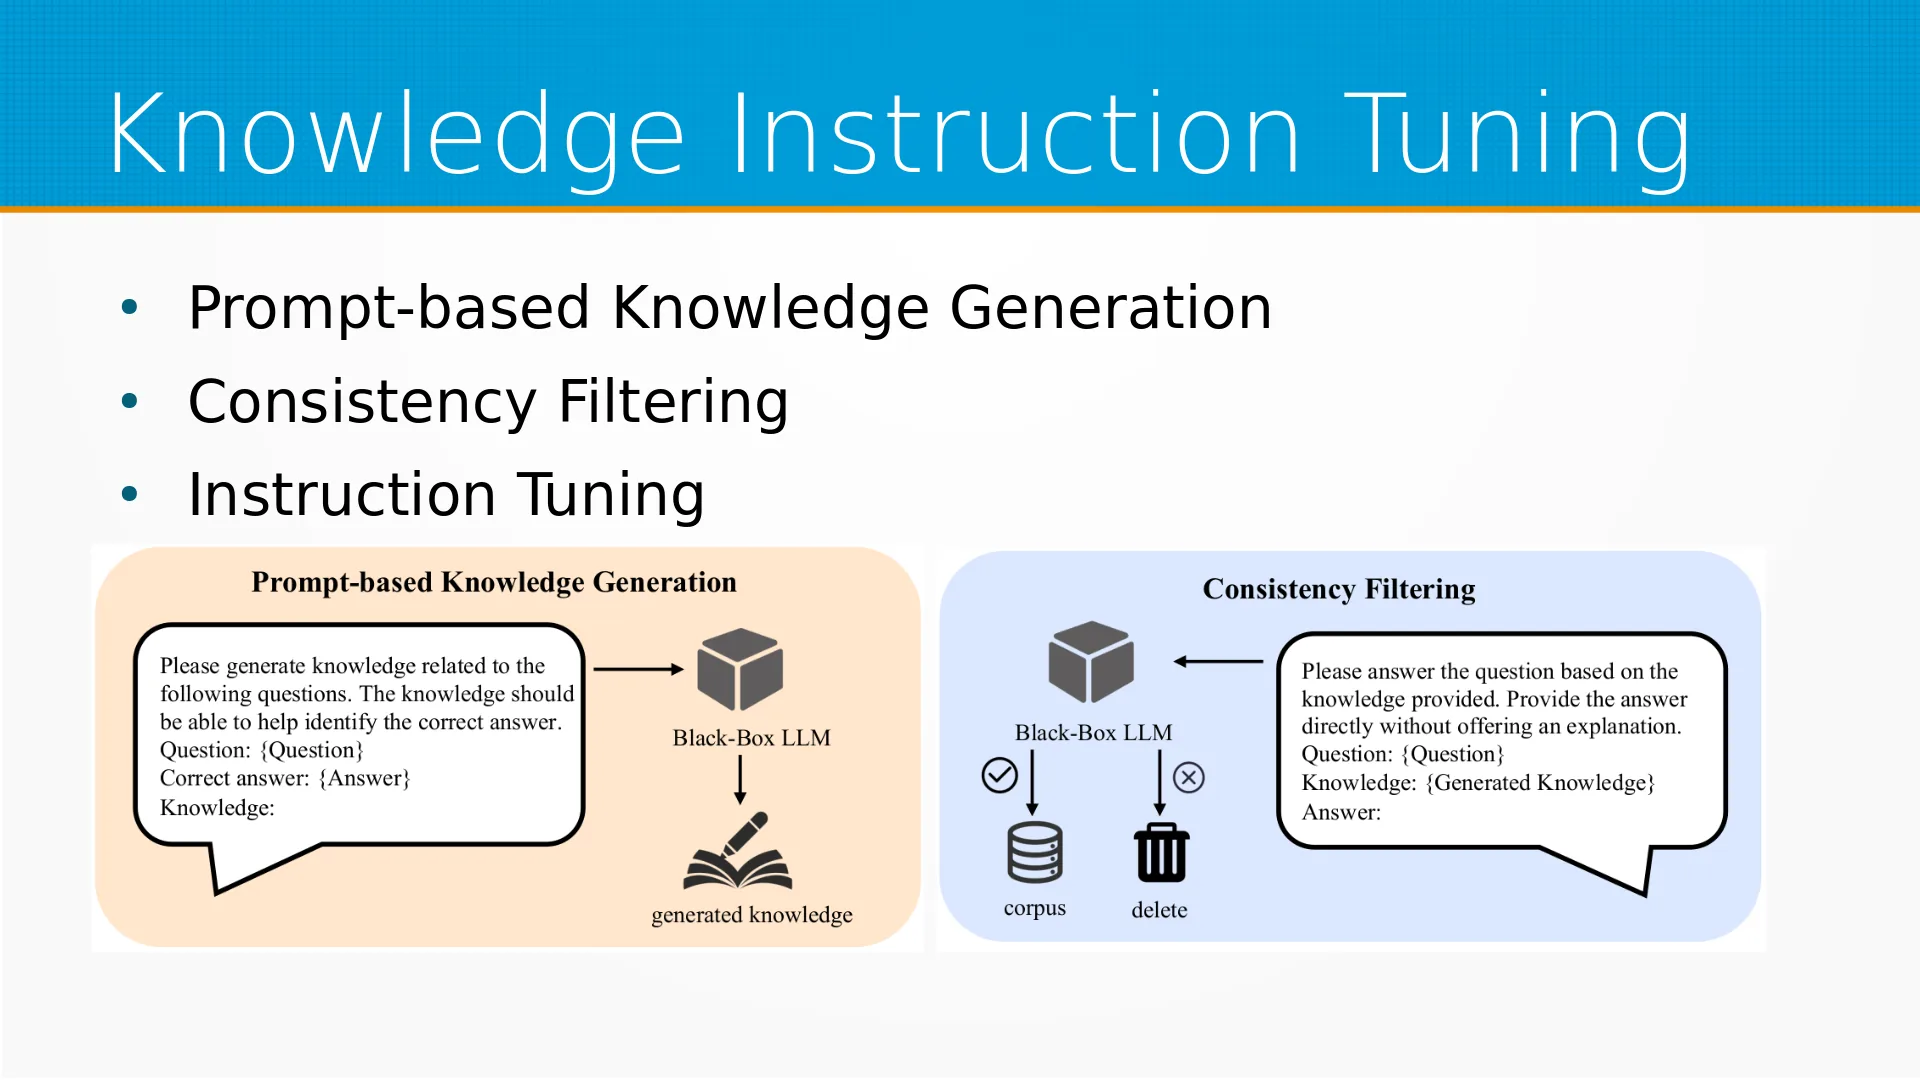
Сначала это Prompt-Based Knowledge Generation, когда мы с помощью большой языковой модели, которую мы не контролируем, мы генерируем некоторые кусочки знания. Затем с помощью Consistency Filter мы проверяем, удобно ли ей самой с этими кусочками знания работать, и потом с Instruction Tuning мы доучиваем маленькую модель. Сейчас по шагам разберём. На первом шаге ну, в данных у нас есть вопрос, ответ. И мы ей говорим: "Пожалуйста, сгенерируй кусочек знания, относящийся к следующему вопросу". Знание должно помогать найти правильный ответ. Дальше, значит, у нас есть вопрос, правильный ответ, и какое знание тебе должно было помочь на это ответить. И языковая модель как-то отвечает.
Затем они делают обратную проверку этой же языковой модели. Говорят: "Пожалуйста, ответь на вопрос, базируясь на том знании, которое у тебя вот даётся". Вот тебе вопрос, вот тебе знание, то, которое на предыдущем шаге сгенерировали ответь. Если она ответила примерно так, как надо, мы говорим, что это хорошее знание сгенерированное, то есть оно инвертируемое. И мы его складываем в наш корпус. Если нет, мы удаляем и идём дальше. Потом мы берём нашу маленькую языковую модель и учим её вот на этой этим левым промптом. Пожалуйста, сгенерируй знания к относящиеся к этому вопросу. Ровно так, как мы спрашивали Black-box языковую модель.
И что мы тем самым получаем? Мы приучаем языковую, маленькую языковую модель генерировать такие кусочки знания, которые удобно использовать большой языковой модели. Почему их удобно использовать? Потому что мы на этапе Consistency Filter только такие подводки и отобрали. Вот, то есть мне показалось это очень красивое решение. После этого мы оптимизируем весь комбайн из двух моделей из конца в конец, то есть, чтобы у нас весь этот тяни-толкай работал хорошо.
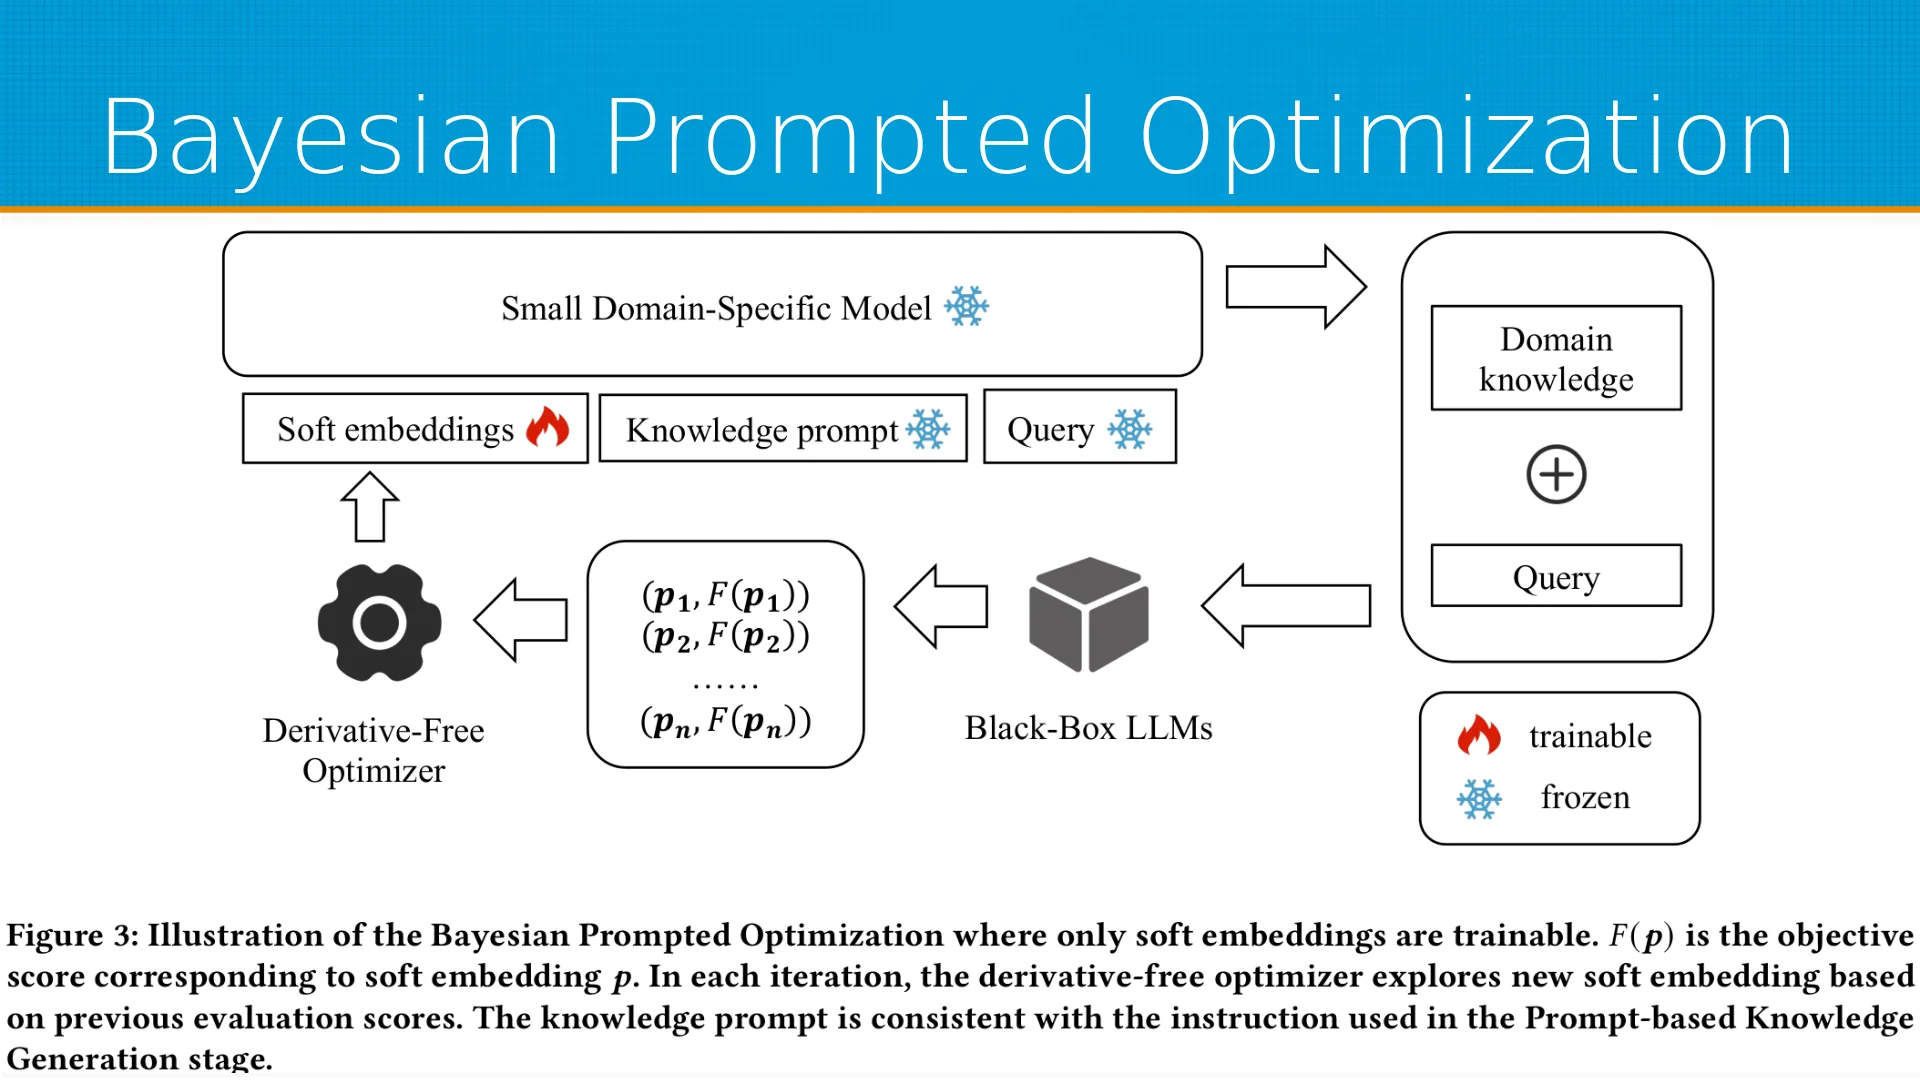
У нас есть малая языковая модель. Она состоит из, собственно, нашего промпта, который не тюнится, из вопроса, который не тюнится. И они ещё добавляют Soft Embeddings. Это то, что вот, если я правильно терминологию помню, это P-tuning. Когда у нас в наш промпт добавляются несоответствующие никаким словам искусственные эмбеддинги, которые мы тюним. И наша маленькая языковая модель генерирует доменное знание, в которое мы добавляем тоже наш запрос. И отправляем её в Black-box LLM, которую мы вообще не трогаем. Вот, которая генерирует нам то, что мы хотели. И на основании того, что она там сгенерировала, мы наши Soft Embeddings софт-эмбединги как-то корректируем, чтобы получалось ближе к тому, чего мы хотели.
Схема красивая, тут есть несколько проблем. Во-первых, через Blackbox LLM у нас не текут градиенты. Она у нас честная Blackbox. Соответственно, градиентом мы всё эту штуку оптимизировать не можем, а обычно софт-эмбединги как раз градиенты мы оптимизируем. Вот, поэтому нам нужно free оптимизер какой-нибудь, то есть оптимизатор не основанный на градиентах. И как мы, собственно говоря, а, ну и у нас трейны было это только вот эти софт-эмбединги. Всё остальную часть мы комбайны мы не тренируем. Как мы этого добиваемся? У нас вот здесь вот достаточно, а, ну это сейчас на этом слайде.
Как мы этого добиваемся? Мы оптимизируем из конца в конец обе модели, градиенты у нас не ходят, поэтому мы используем байсовскую оптимизацию без градиентов. И тут мы эксплуатируем предположение о том, что внутренняя размерность LLM-ки, она мала. И мы берём и строим случайную проекцию из того, из вот этого вот результата в пространство сильно меньшей размерности и в нём уже выполняем оптимизацию. Они говорят: "Ну вот смотрите, случай мы просто будем случайную проекцию строить, потому что мы не знаем, какую нам нужно. Случайная проекция со значительной вероятностью сохраняет дистанцию внутри нашей фигуры, так что близость, ну то есть векторная близость, консистентна между пространствами. Что в пространстве до проецирования они были близки, что после случайного проецирования они будут близки.
И как вообще работает байсовская оптимизация?
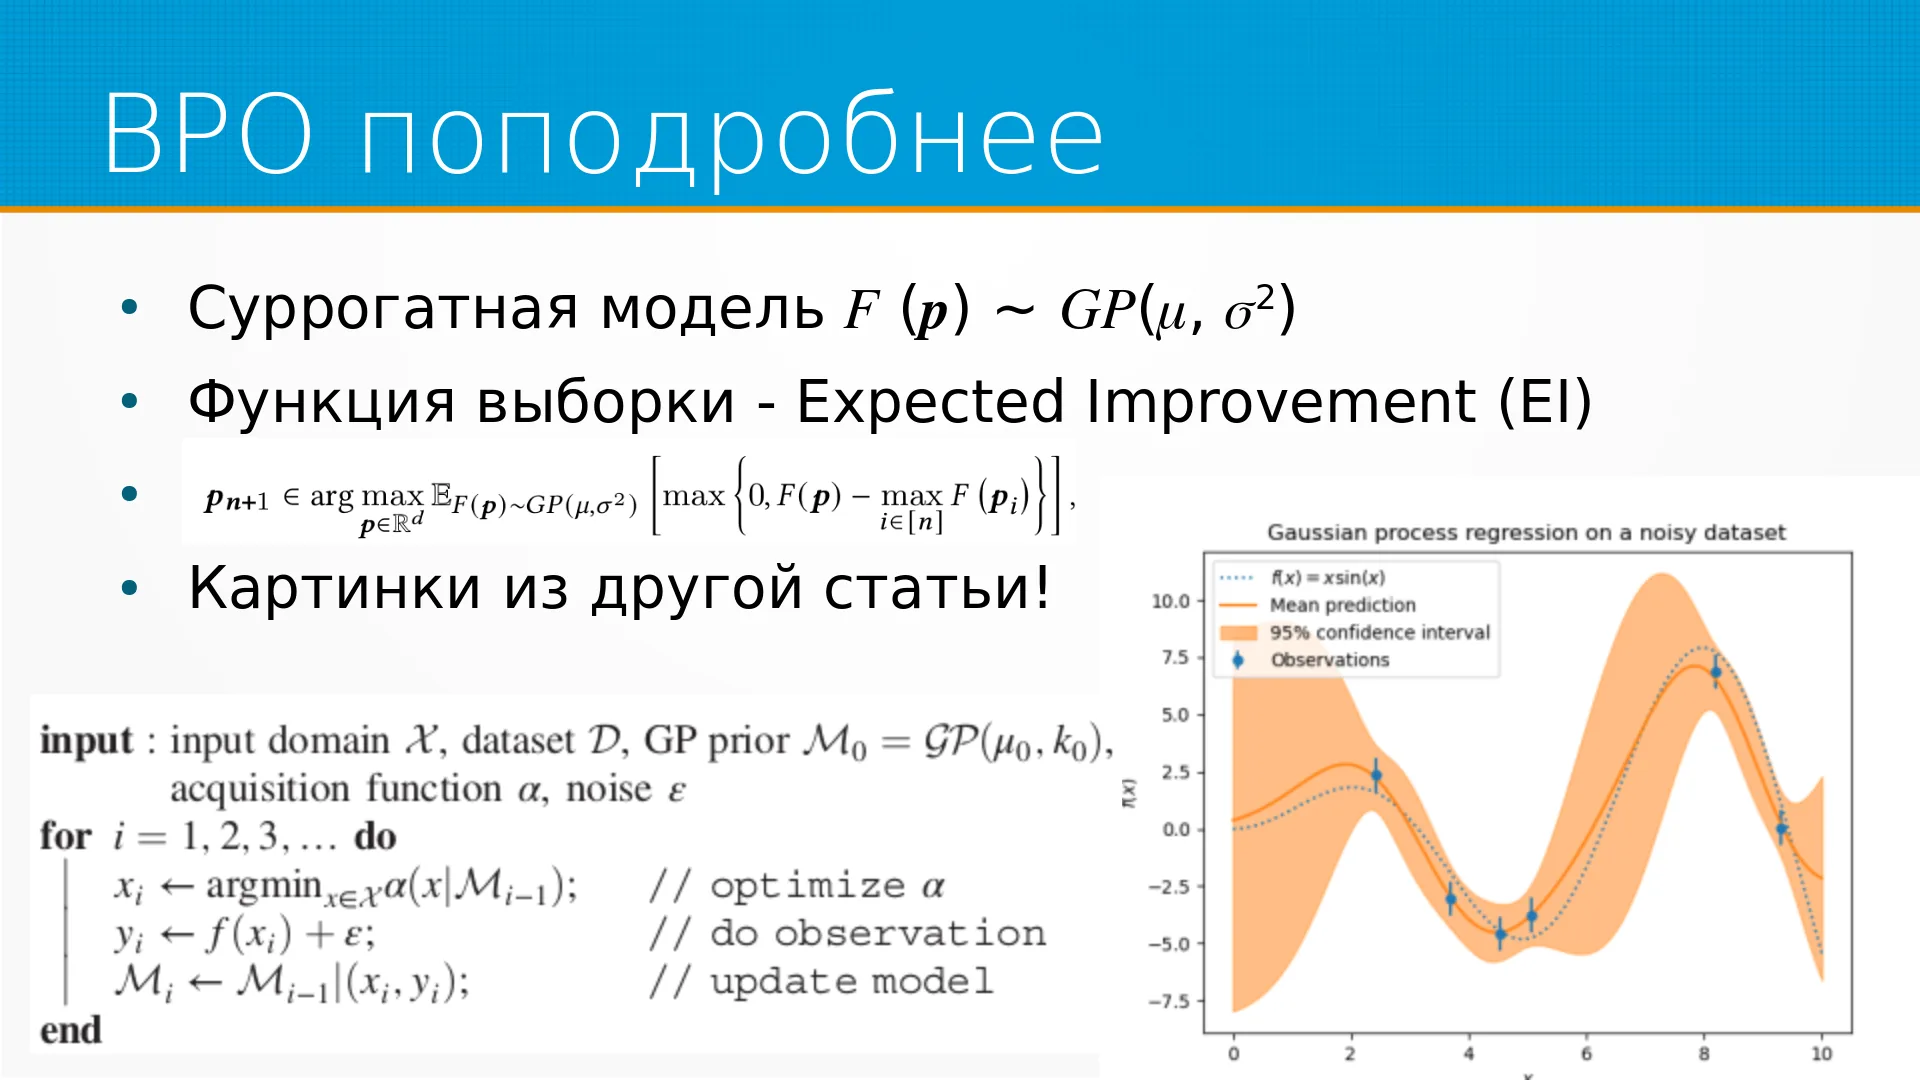
Тут вот картинки взяты из другой статьи, предыдущий раз, когда я рассказывал про байсовскую оптимизацию. Берётся две модели. Первая - это суррогатная модель, которая предваряется тем процессом, который мы оптимизируем. И эта суррогатная модель, она не обязательно должна быть такая уж очень хорошего качества, но она должна предсказывать матожидание ответа системы, которую мы оптимизируем. И матрицу ковариации этого матожидания. Если у нас вот в этом случае это просто дисперсия, да? И достигается это примерно каким образом? У нас есть некоторое ядро, которое по близости к опорным точкам, то есть точкам системы, которая нам известны, она рассчитывает вот эту вот самую облако ковариации.
И когда мы узнаём какую-нибудь ещё точку, она пересчитывает вот эти вот и среднюю, и модель неопределённости. И с каждым шагом у нас уточняется как средняя, так и вот эта вот колбаса становится уже. Модель становится более уверенной в своих предсказаниях. Итак, у нас есть суррогатная модель, которая предсказывает, как будет вести себя оптимизируемая система, и некоторая функция выборки, которая позволяет выбрать точку, которая, скорее всего, нам поможет эту систему как-то улучшить, либо снизить неопределённость в этой системе, чтобы на следующем шаге нам проще было выбирать. Тут они используют expected improvement. Если так совсем грубо, то вот у нас есть наше матожидание - это наша оранжевая линия, тонкая.
И есть, скажем, 95% доверительный интервал. И мы хотим получить наибольшее значение функции, мы берём вот верхнюю границу этого интервала и говорим: "Ну вот, либо мы попадём в очень высокую значение функции, либо мы здорово снизим нашу дисперсию. Давайте мы выберем вот эту вот точку, которую вот на этом горбике". И это вот как раз функция выборки, acquisition function. И мы крутимся в этом цикле, то есть мы выбираем точку, отправляем её на систему, которую мы оптимизируем, система нам выдаёт какой-то результат, мы уточняем нашу суррогатную модель, выбираем точку и так далее. Они, а, на самом деле выбирают вот эти точки несколько более сложным способом, чем просто вот выбрать горбик.
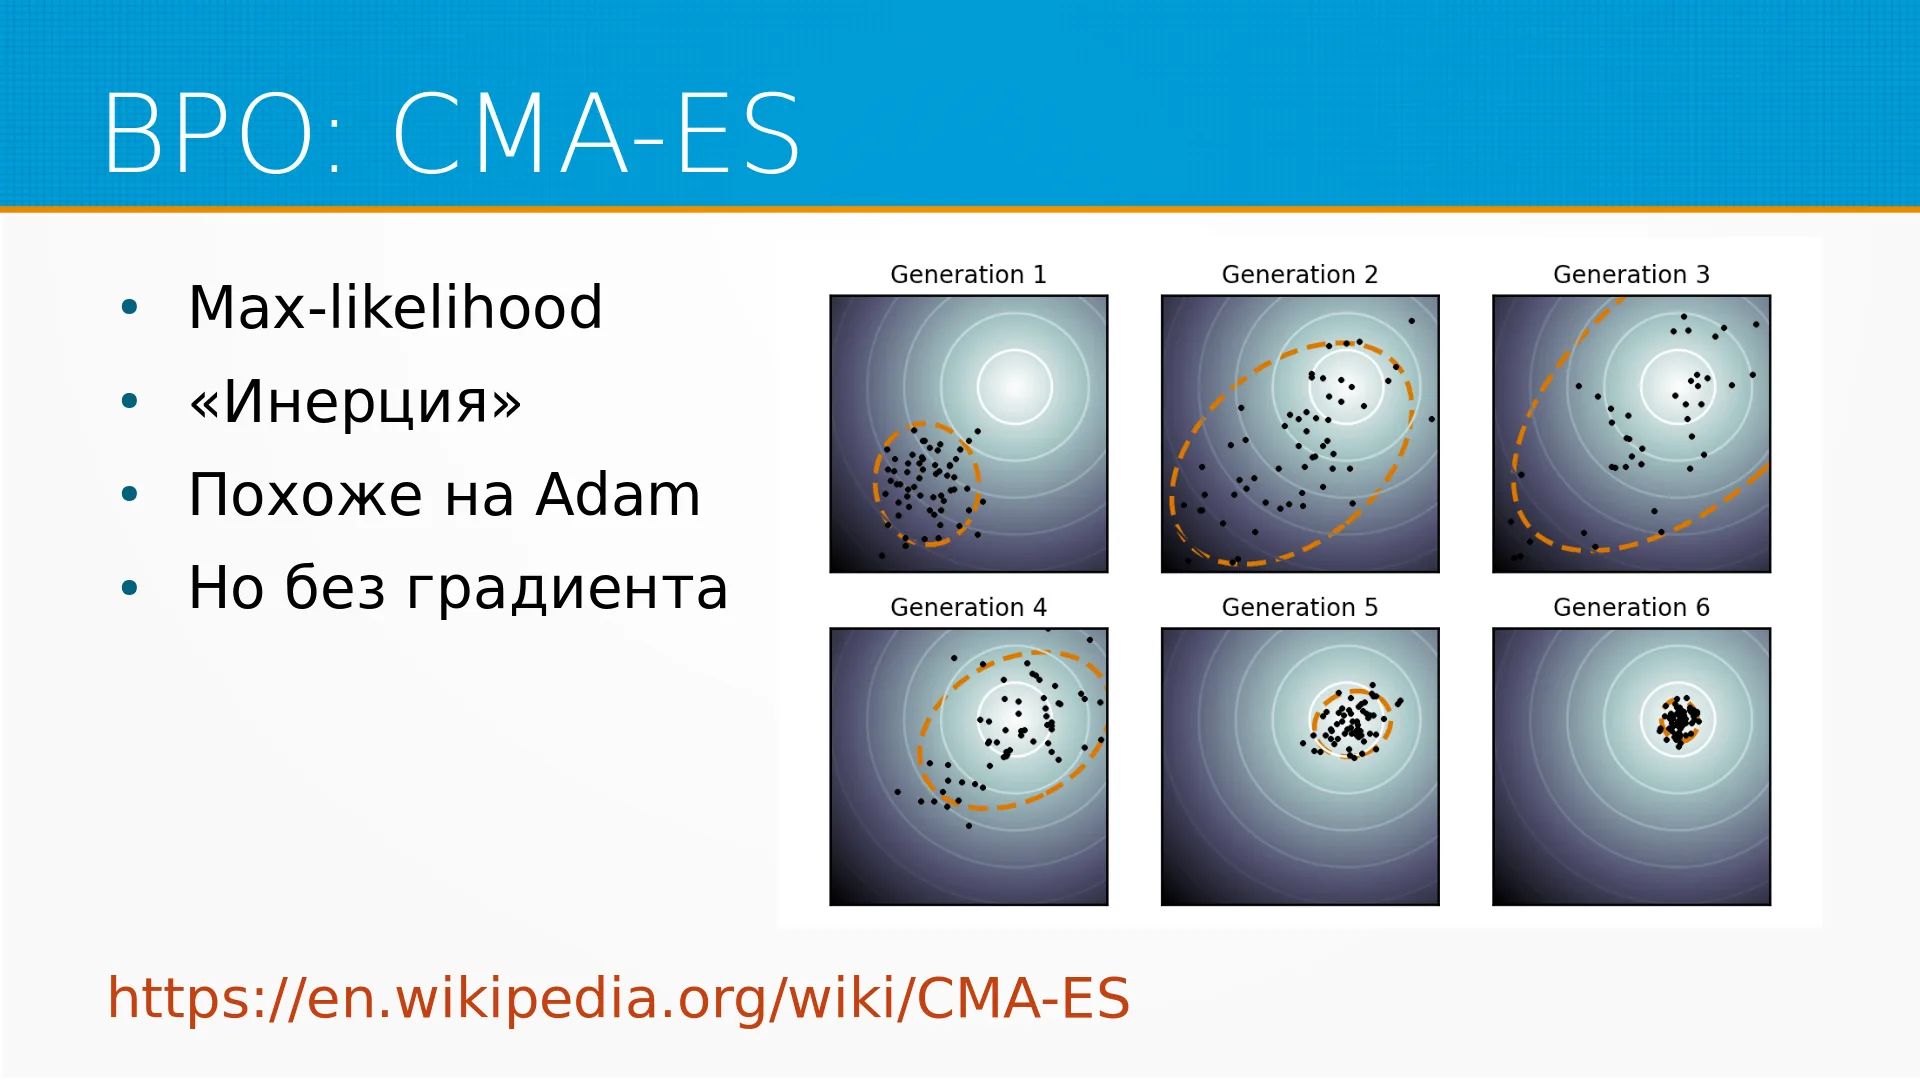
Именно они используют алгоритм эволюционный алгоритм оптимизации. Вот, CMA-ES. Он без градиентный, но по логике своей очень похож на Адам. У него там хранится две истории, два трека. И каждый раз, когда он ищет следующую точку, он смотрит, куда эти треки смотрели. Опять же, градиентов у нас нет, поэтому мы генерируем некоторый батч точек сначала, и потом по этому батчу мы смотрим, в какую сторону нам хорошо идти. Вот здесь вот примерно так нарисованы шаги оптимизации. Если посмотреть на сам алгоритм, то вот это вот аналогия именно, то есть это не соответствие с Адамом, потому что Адам хранит первую, вторую производную там и так далее, тут нет никаких производных.
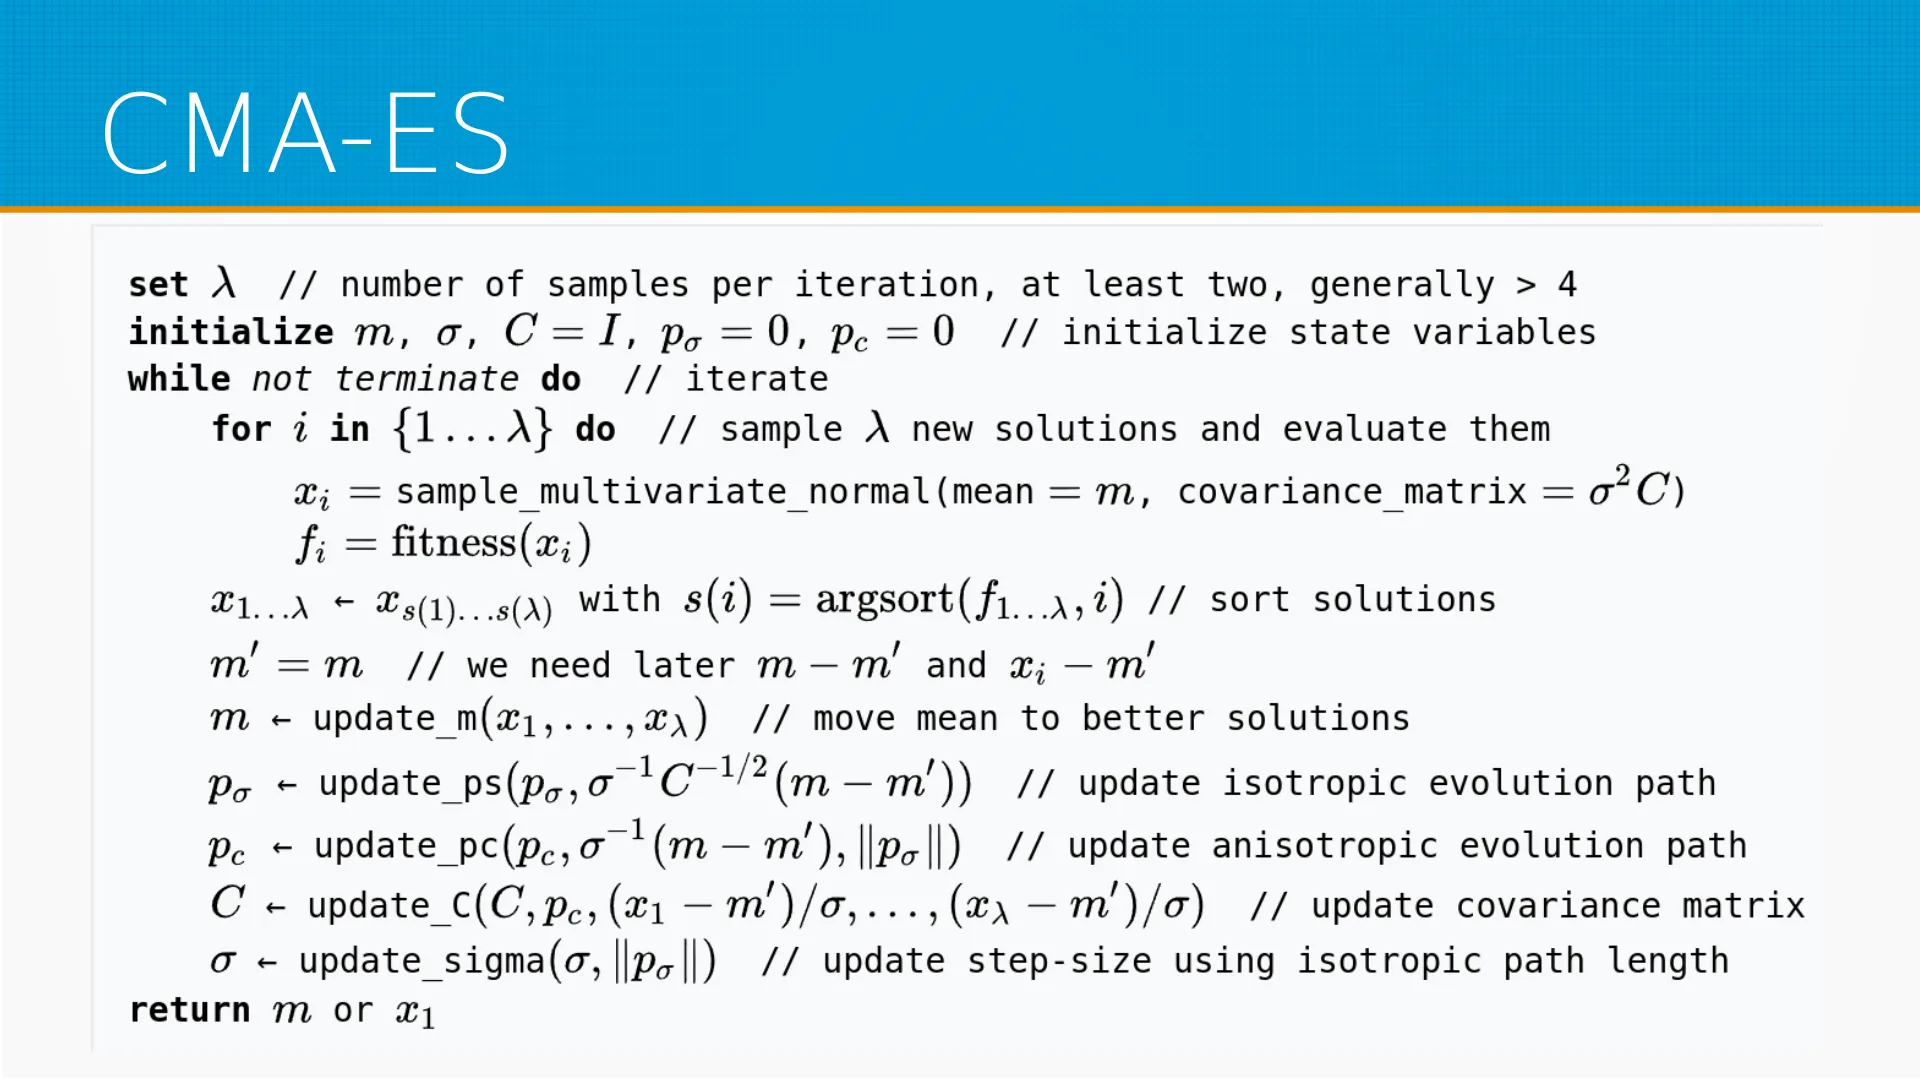
Но если посмотреть на то, как он работает, у нас вот есть вот изотропик Evolution Patch, анизотропик Evolution Patch. И вот на основании его мы рассчитываем скорость обновления нашей, собственно говоря, матрицы ковариации, и этой матрицей ковариации, считай, шагом оптимизации, мы двигаем наши точки. Вот именно сама структура, сама идеология на Адам похожа, исполнение, конечно, отличается.
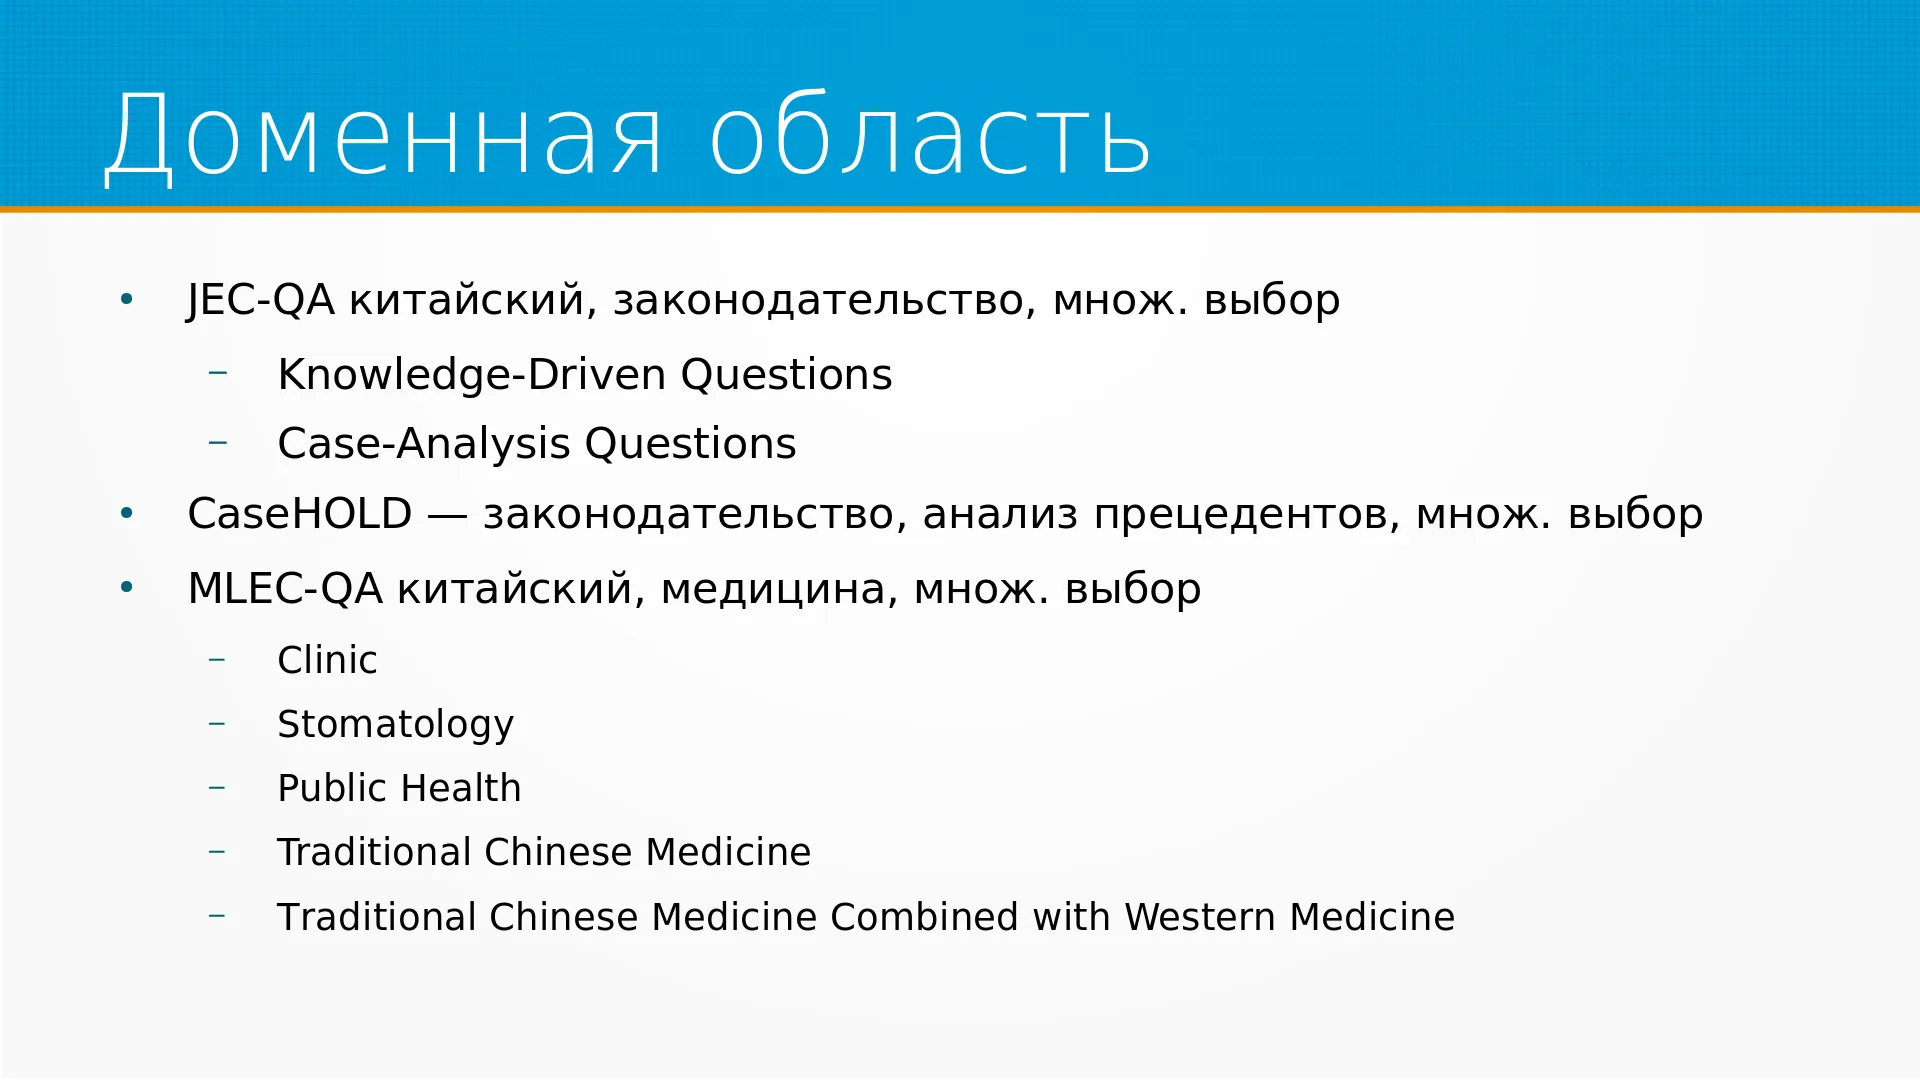
В какой доменной области они развлекались? У них было три датасета. Один GEC Question Answering - это на китайском законодательство, вопросы с множественным выбором. Там вопросы двух типов: Knowledge-driving question и Case-analysis question. Knowledge-driving - это вы должны знать, что, например, бить кирпичом прохожих по голове нельзя. Case-analysis question - вам даётся кейс, вот типа Джан ударил Гуна кирпичом по голове, молодец, Ли Джан. CaseHOLD - это датасет с законодательством, он на английском, но он анализ прецедентов, там тоже множественный выбор. Например, Джан ударил Гуна кирпичом по голове, его посадили на 10 лет. Какой прецедент из этого следует? Нельзя бить кирпичом по голове, тех, кто бьёт кирпичом по голове, сажают на 10 лет.
Вот примерно такие достаточно сложные умозаключения. И MLEC-QA - это китайский датасет с медициной, причём на этом датасете я бы на месте ChatGPT сдался сразу, потому что там в числе прочего по традиционной китайской медицине и традиционной китайской медицине, комбинированной с западной медициной, а также стоматологии и клинические какие-то какие-то клинические эти данные.
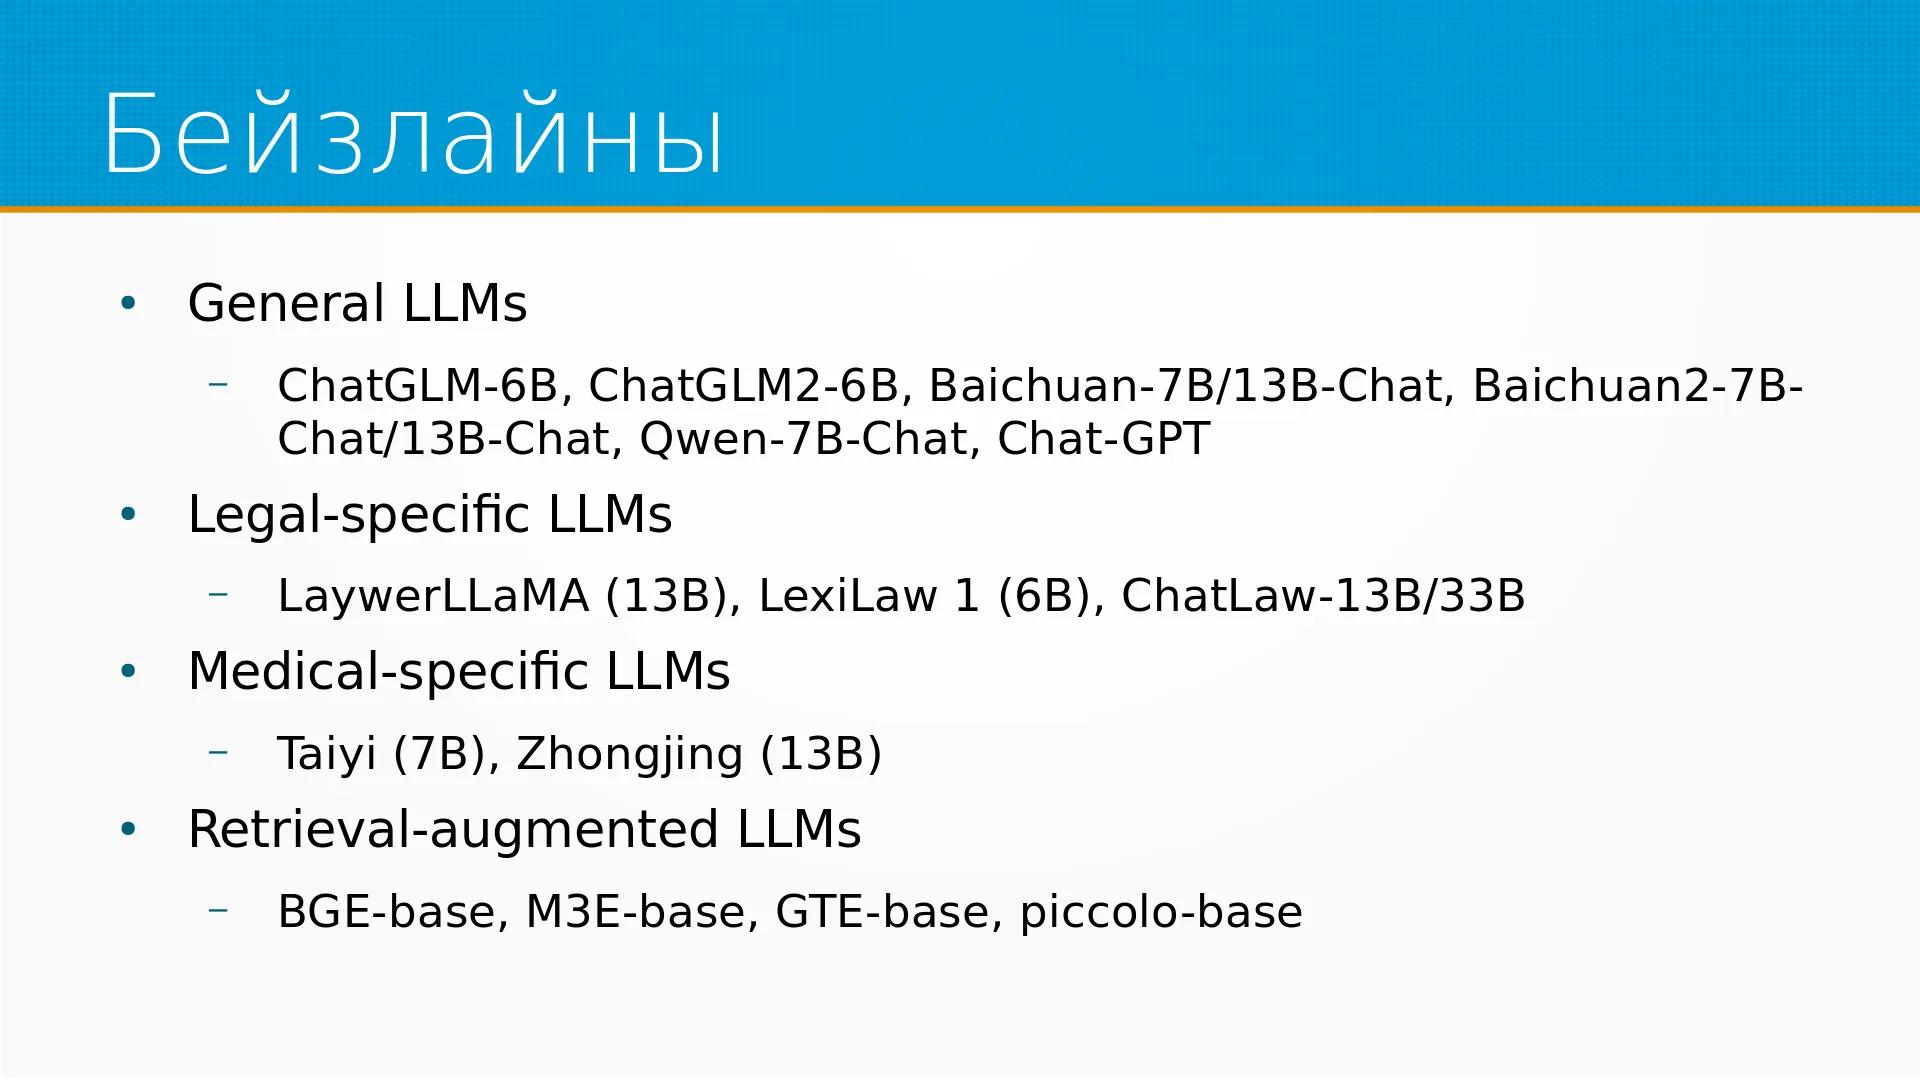
И с чем они сравнивались? В качестве General LLM они взяли некоторое количество моделей, умеющих китайский, от 6 до 13 миллиардов параметров. Плюс у них были Legal Specific LLM, то есть обученные на законодательстве LLM-ки, тоже 13 и 33 миллиарда. И обученные на медицине. И ещё они сделали четыре рега на базе каких-то моделей, с которыми я тоже не знаком. И в качестве маленькой модели они использовали BloomZ на 1,7 миллиарда параметров.
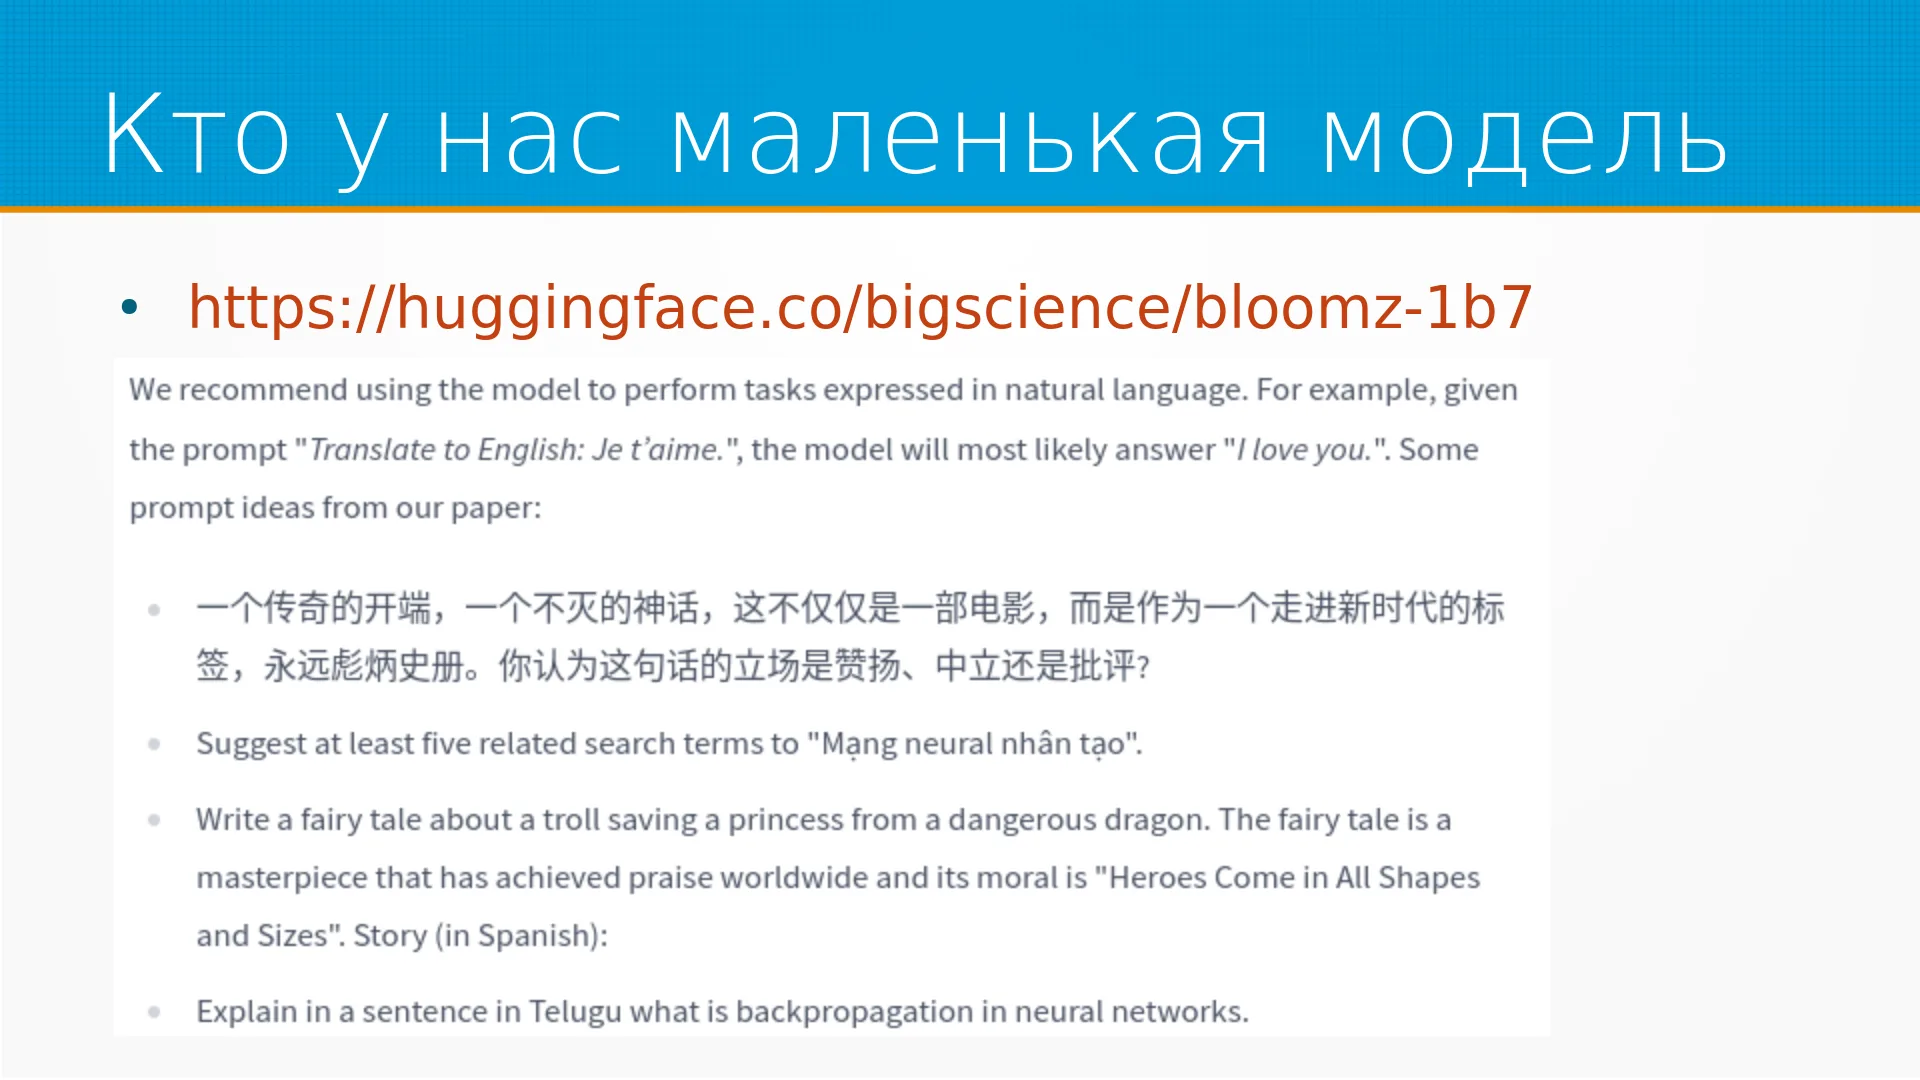
Модель многоязычная и ну достаточно сообразительная. Если посмотреть, на какие вопросы она должна отвечать, то, в общем, это прямо такие очень умненькая модель. Вот. Например, объясните в сентенции на языке тулугу, что такое backpropagation в нейронных сетях, да?
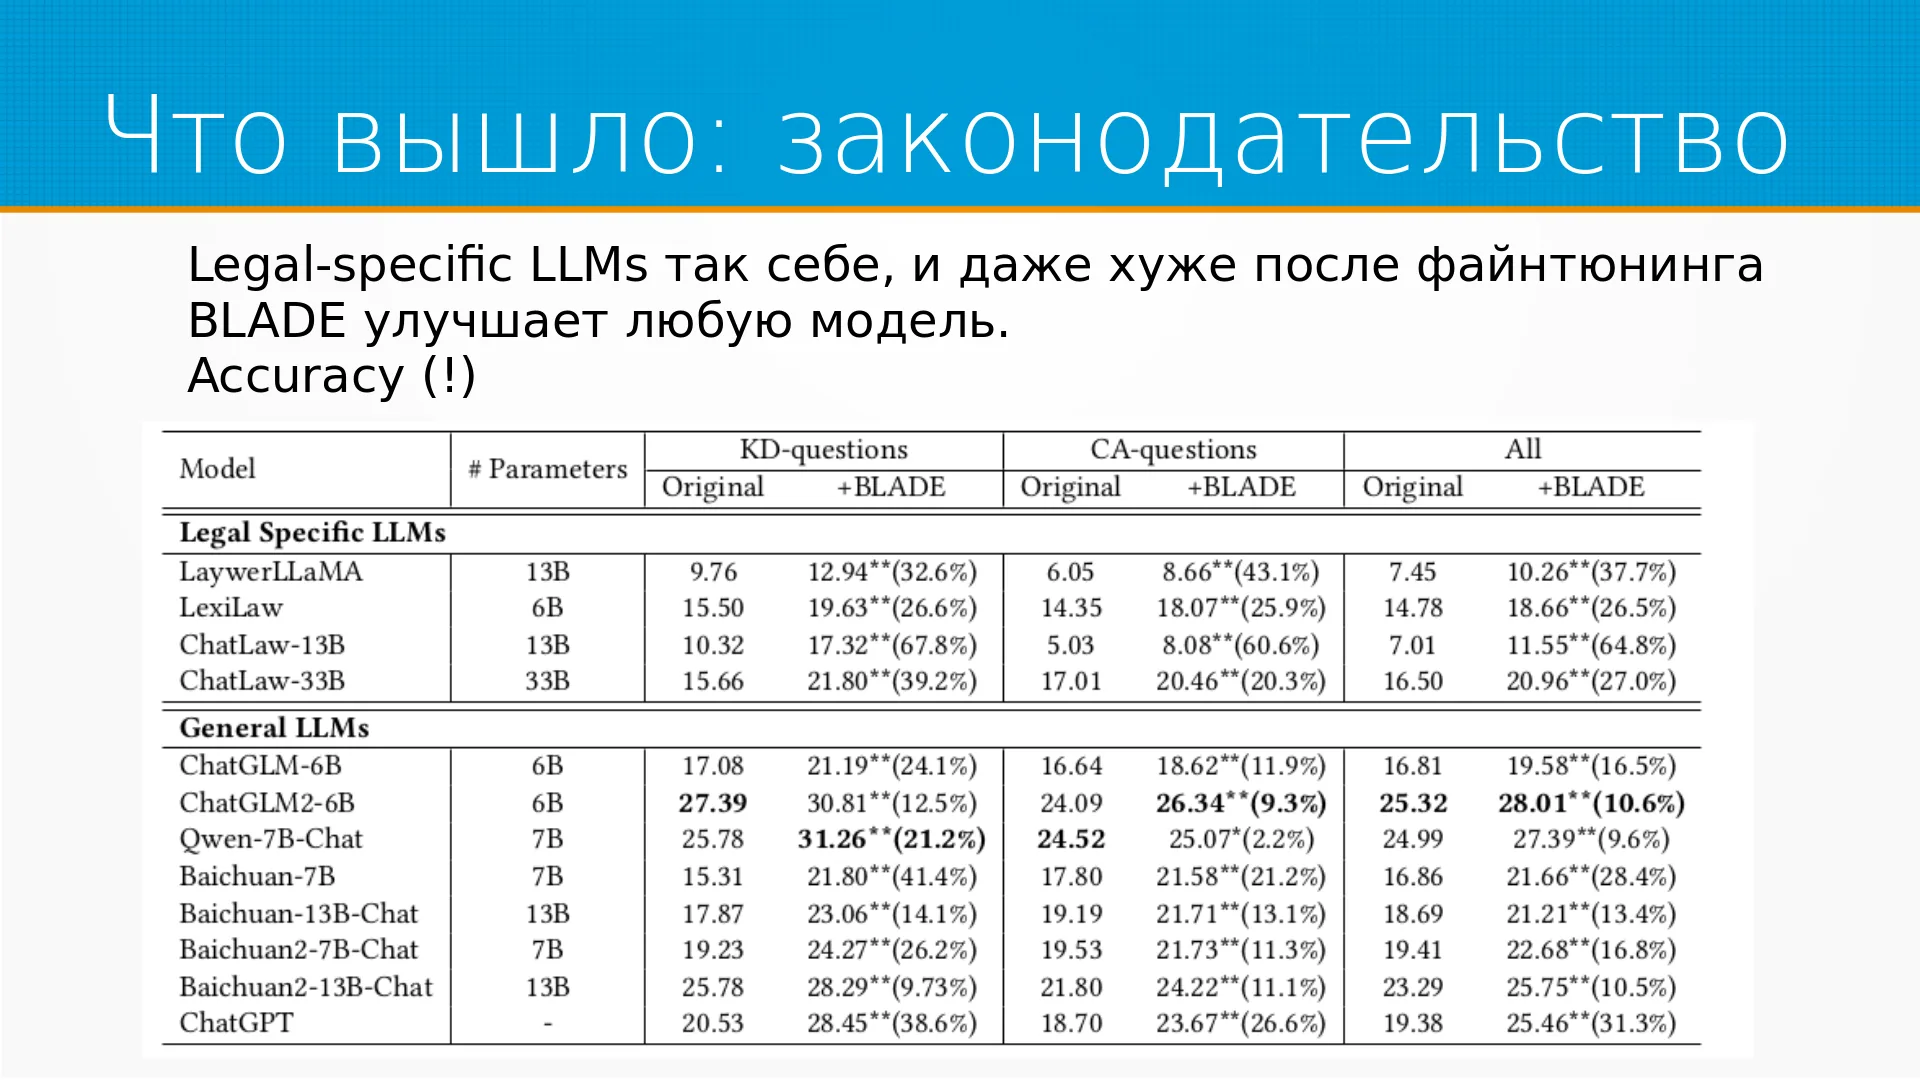
Что вышло? Вышло интересно. Во-первых, Legal Specific LLM, они на этих же как раз Legal датасетах работали сами по себе плохо, после файн-тюнинга, как в статье написано, они ещё хуже работали. Добавление Blade улучшает просто любую модель. В качестве метрики они, если я правильно понял, здесь использовали банальную accuracy. Я вот тут не понял, почему это так, но, в общем, accuracy. И мы видим, что куда бы мы ни добавили Blade, результат растёт. В качестве ChatGPT, если я правильно понял статью, они использовали третью ChatGPT. Chat GPT. Вот причём непонятно, третью или 3,5. Это эта информация была непонятной. И вот здесь, на самом-то деле, видно, что вообще-то говоря, сложность модели не коррелирует с итоговым результатом.
Лучше всего вот эту вот 7B модель, а не 13B и не Chat GPT. Здесь вообще 6 6 млрд лучше. Везде вот как-то так подкидывает. Они сделали много тестов, я не стал тут все бенчмарки приводить.
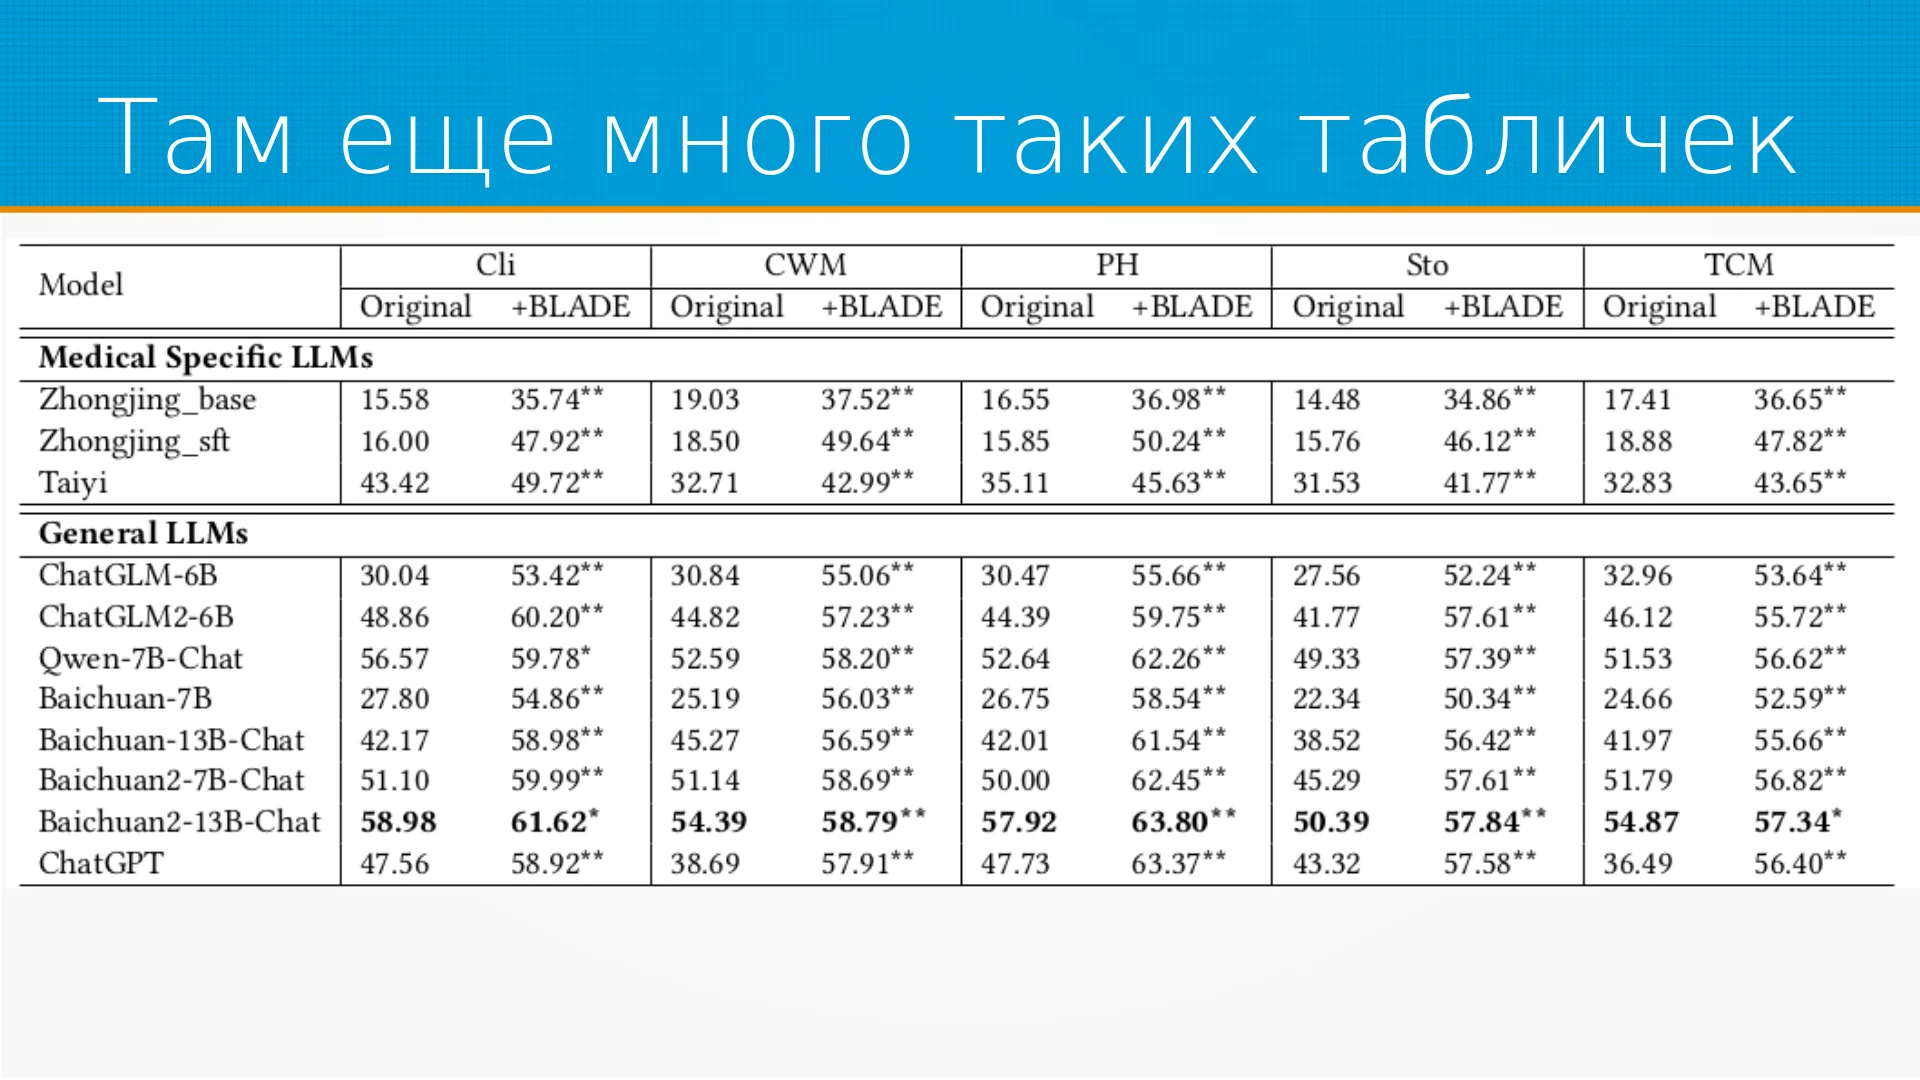
Вот на медицинских данных интересно, что именно специфические языковые модели, даже с BLADE-ом, проигрывали модели общего назначения с BLADE-ом. И, в принципе, они не то чтобы так превосходили модели общего назначения. И вот если здесь посмотреть, докуда удавалось дотягивать BLADE-ом, видно, что, в принципе примерно до одного значения BLADE-ом и дотягивались все модели, неважно, с какого момента они стартовали. 27,8 или там 58,96, но всё равно дотянули их примерно до 60. Тут можно на эту тему фантазировать по-разному. У меня зародилось подозрение это же известный факт, что в тяжёлых моделях очень часто просто протекают датасеты. И вот те модели, которые хорошо себя показали до BLADE-а, в них, скорее всего, эти датасеты уже протекли просто.
Вот, поэтому такое маленькое улучшение. Это вот моё предположение, авторы его не делали.
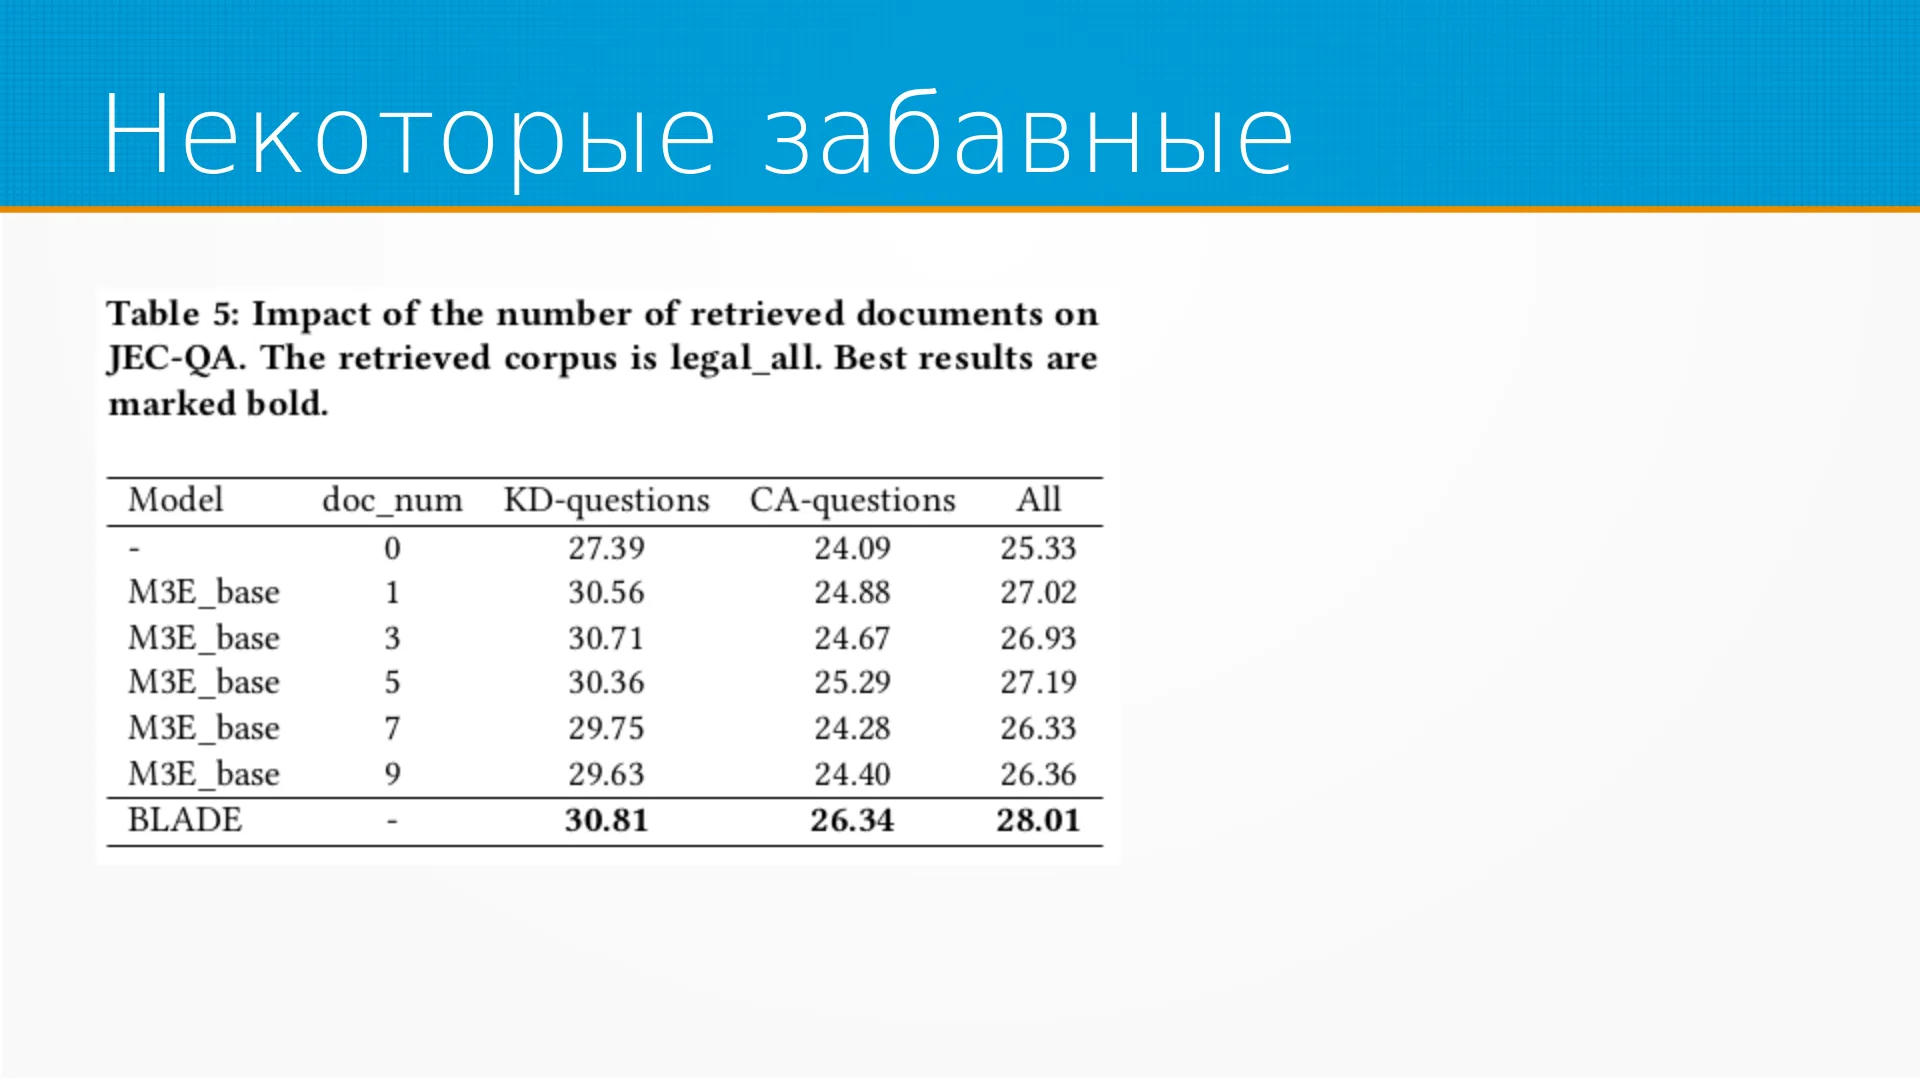
Из забавных вещей они сравнивались с регами и когда обсуждают рег, часто, например, говорят: "Да давайте мы просто все документы в рег сложим". И вот тут вот хорошо видно, что все документы в рег сложить - это не самая оптимальная стратегия, а самая оптимальная стратегия в рег сложить, например, там 2 1 3 документа. Вот, то есть, слишком много документов рег путает, и все преимущества рега мы теряем. BLADE улучшал и тут. Рег он тоже улучшал, не так значительно, но это.
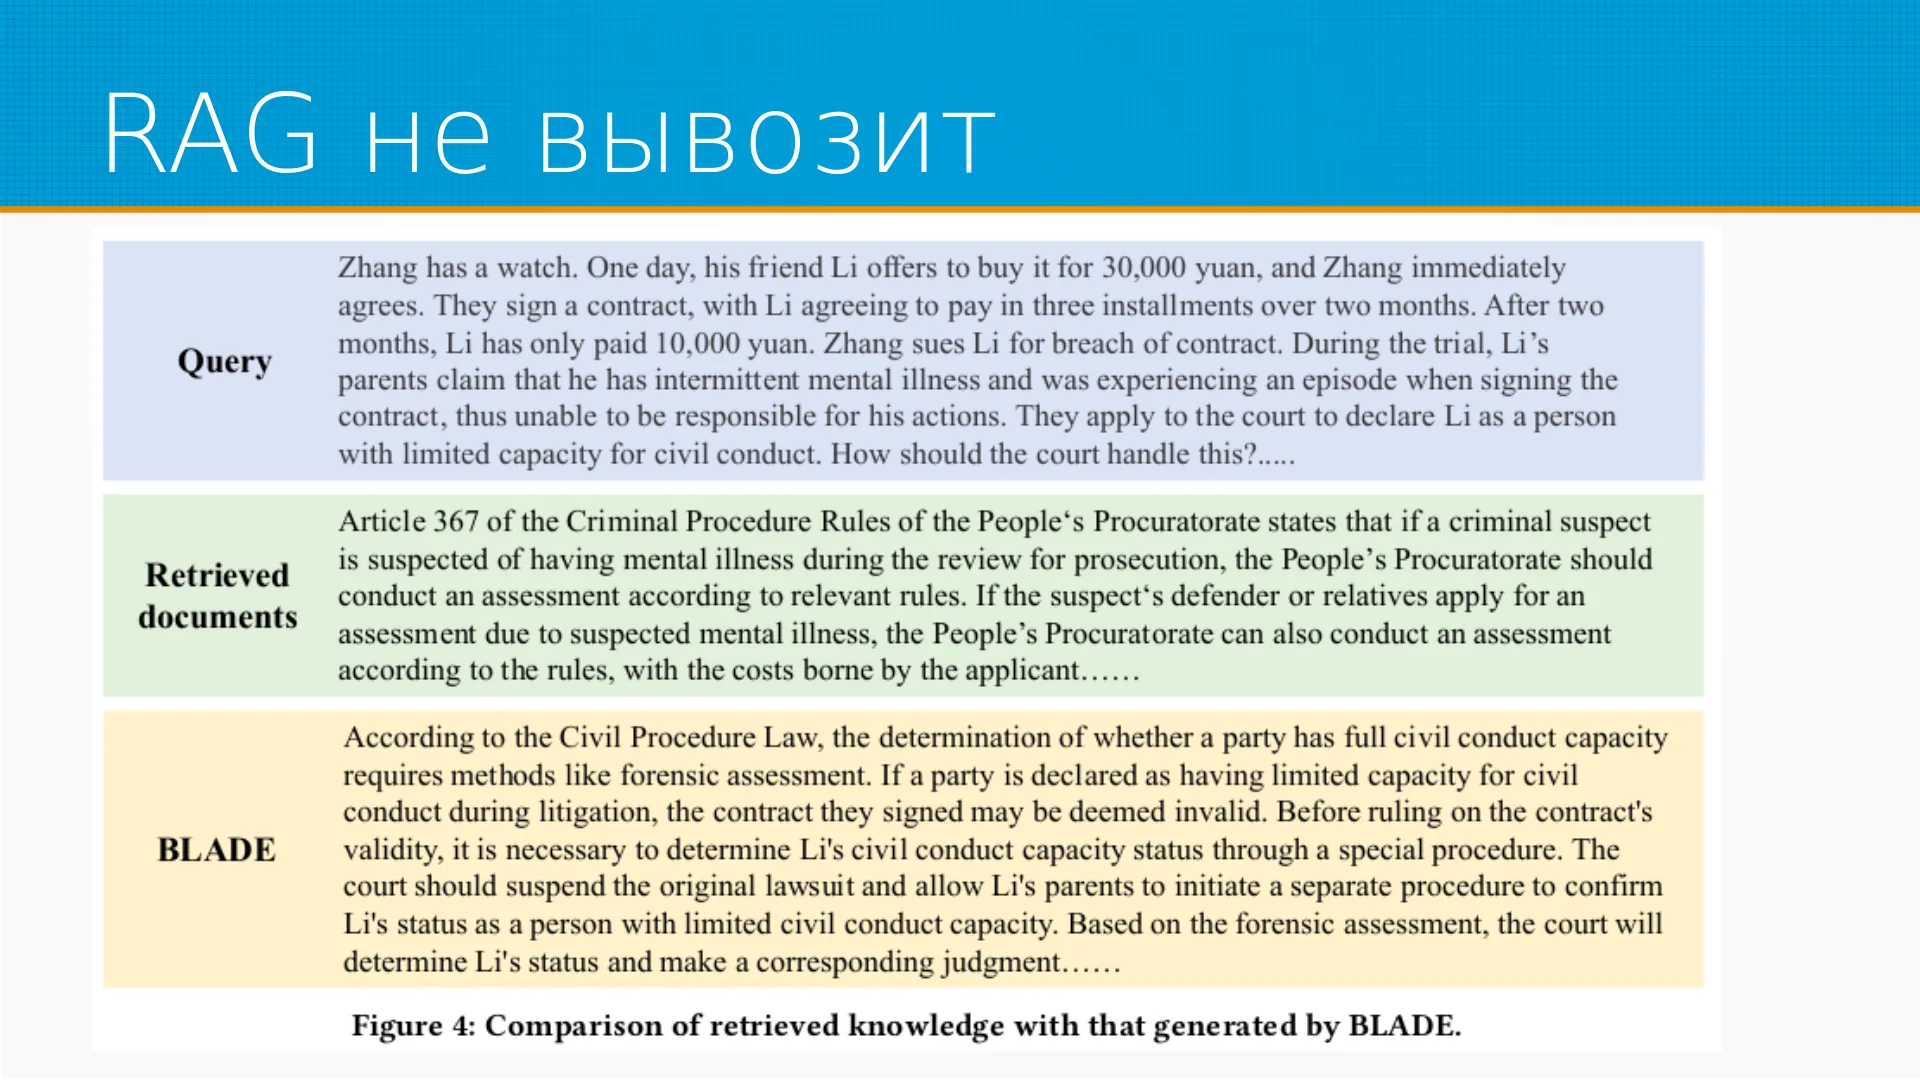
В принципе, сам по себе рег у них не вывозил. Вопросы были действительно сложные. Например, вот у Джана были часы. Однажды его друг Ли сказал: "Давай я их куплю за 30.000 юаней", это примерно 4.500 долларов, по-моему. И Джан сказал: "Да, конечно, покупай". Они подписали контракт, Ли согласился заплатить тремя платежами в течение двух месяцев, спустя два месяца заплатил только 10.000 юаней, это примерно полторы штуки в долларах. И Джан подал на него в суд. Во время суда родители Ли сказали, что у него, на него периодами находит безумие, и это как раз был тот самый случай, поэтому давайте всё отменим. Вот, и они подали ходатайство о том, чтобы признать Ли персоной ограниченной дееспособной.
Что должен сделать, а как с этим должен обращаться, что должен делать суд? Вот такой вопрос. И рег вытащил очень правдоподобный документ, но, на самом-то деле, не дающий именно указаний, что делать. С BLADE-ом у них прямо такая вот, получился пошаговый рецепт, что делать. Они сделали Ablation Study, и у них получилось, что, вот, допустим Chat GPT без ничего выдавала там 27%.
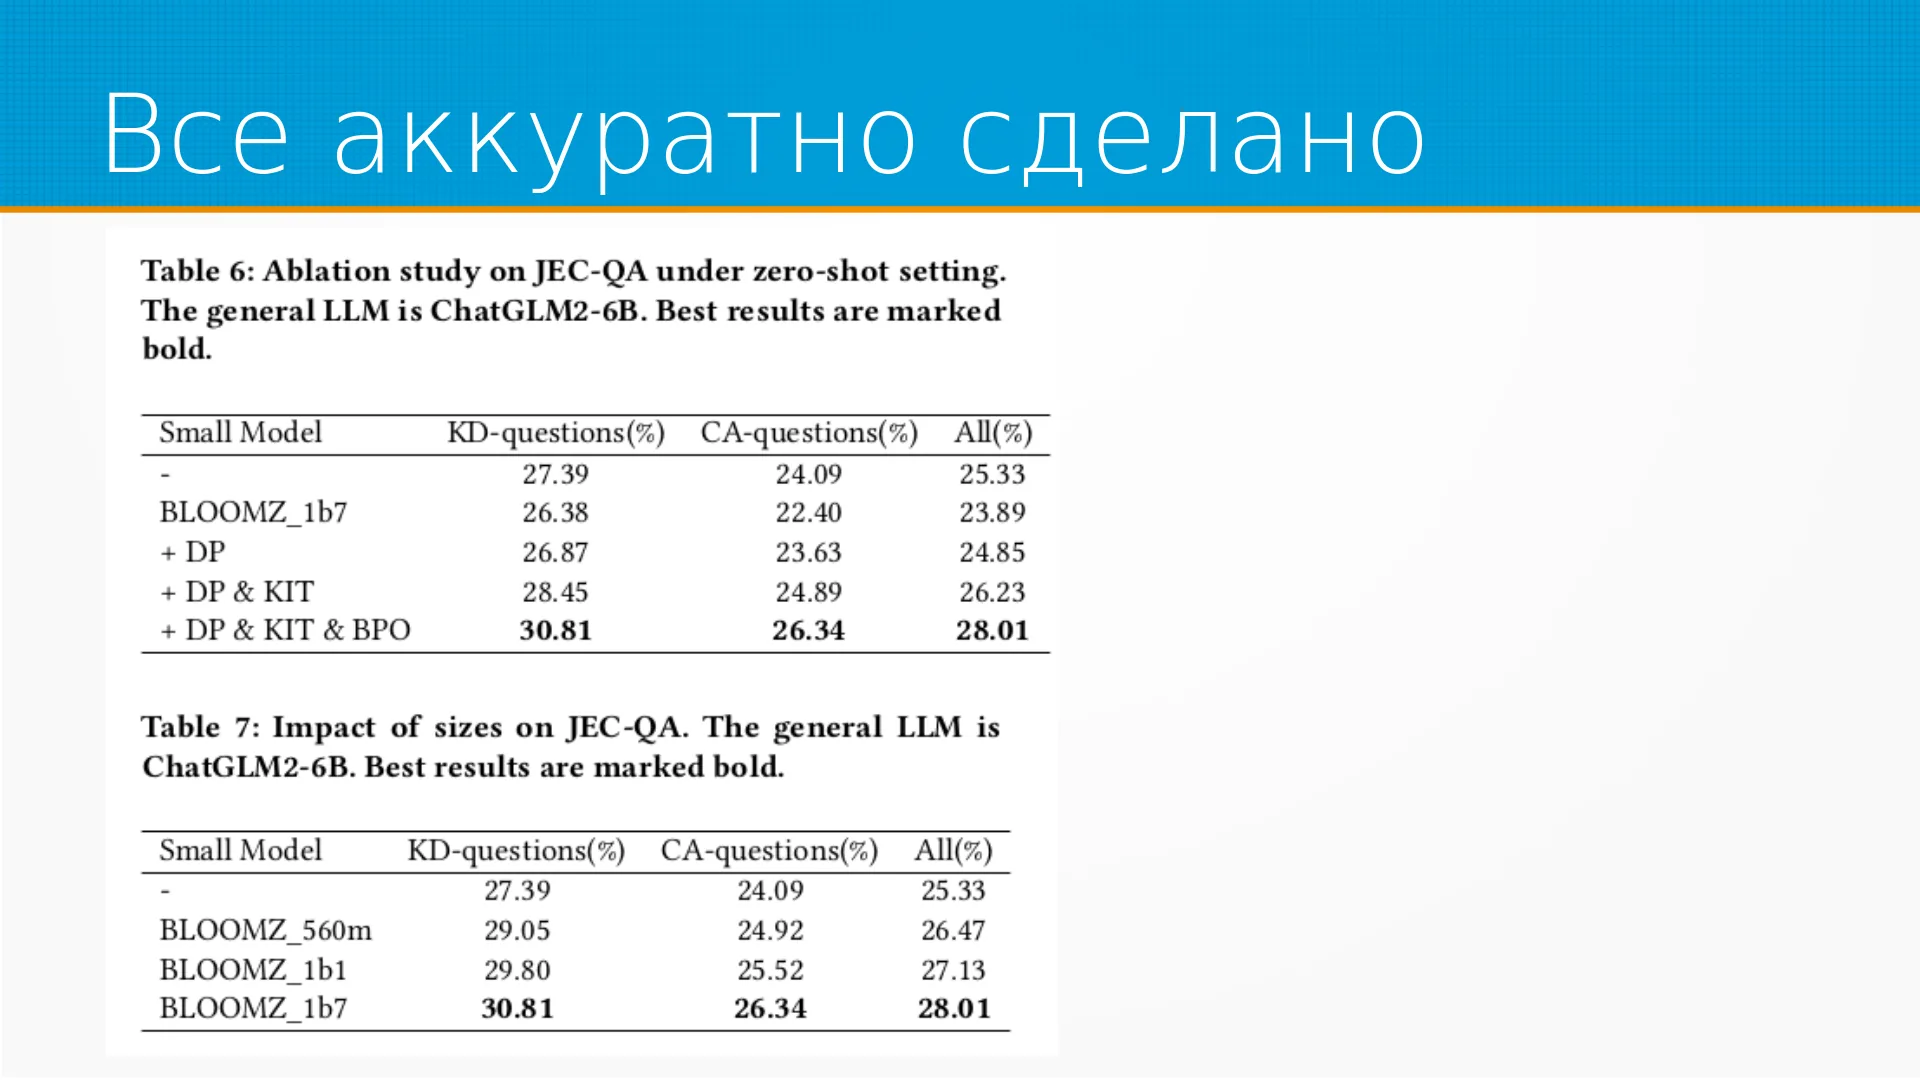
Bloom без ничего выдавала 26. Вот, и мы всё это дело дотянули, у нас получилось 30. И на каком бы датасете мы ни делали, у нас оно каждый шаг вот этого вот, этого чуть-чуть, да и улучшал. Кроме этого, они попробовали разные маленькие модели. Там не было особого сюрприза, большая маленькая модель лучше маленькой маленькой модели. Причём вот здесь вот они увеличили модель в два раза с полумиллиарда до миллиарда, она чуть-чуть улучшилась. Потом они улучшили её с 1,1 млрд до 1,7, и она выросла аж на целый процент прямо вот так вот хорошо выросла.
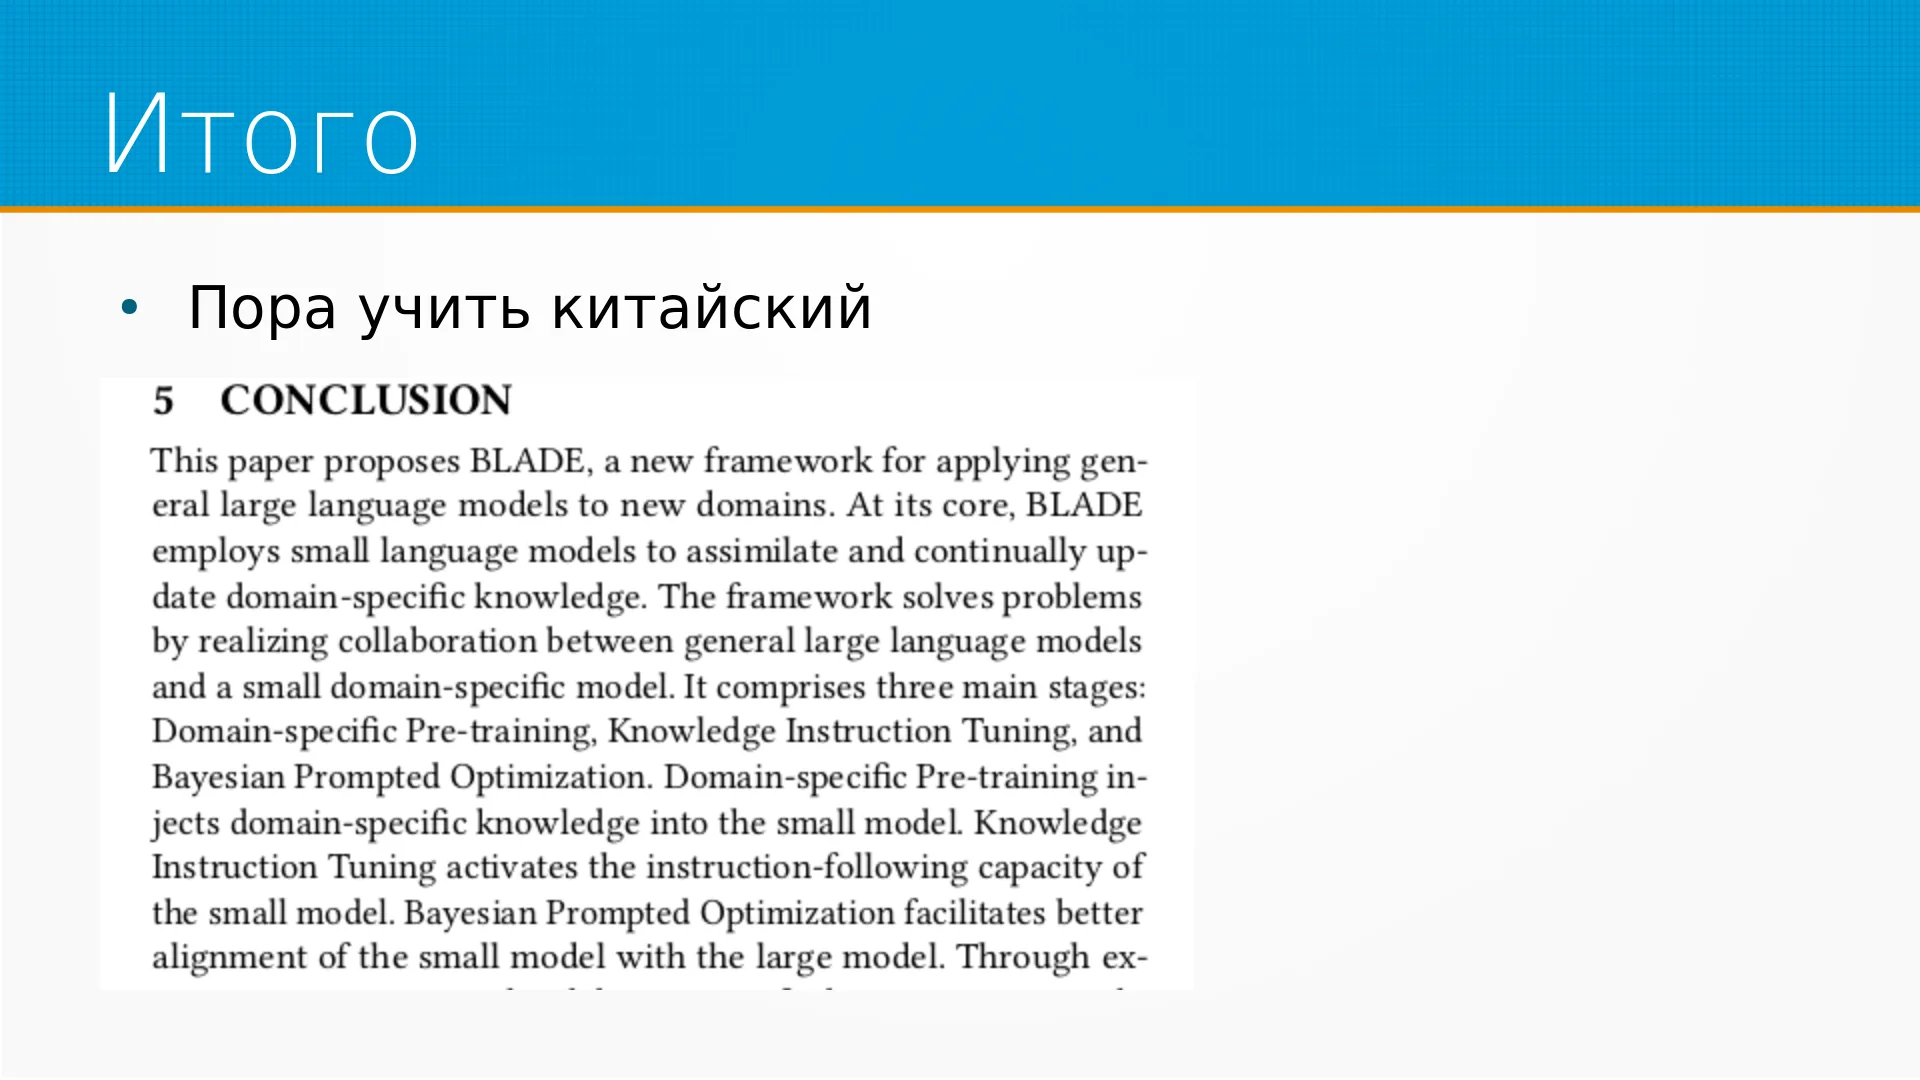
Дмитрий: И итого, конечно, пора учить китайский. Вот в модели предложен фреймворк BLADE, который позволяет доучивать маленькие модели и с их помощью использовать большие модели, которые на этом датасете не учились. От себя замечу, что напрашивается, на самом-то деле следующий кейс, про который авторы статьи не говорили, что у нас есть плагины, скажем, из десятка маленьких языковых моделей под каждую доменную область, а большая языковая модель у нас универсальная под всё. И, возможно, даже не под нашим контролем. И если чуть-чуть дальше, то смесь экспертов мы делаем MOE из этих маленьких языковых моделей, у нас получается такой комбайн, который знает всё, и мы его можем апдейтить по частям.
Например, раз, мы проапдейтили в нём знания китайской медицины, раз, значит, китайского законодательства, раз тут Open AI выкатил новую GPT, и мы под это дело подтюнились, промты подобрали. Вот, как бы, очень технологичный подход с которым удобно жить на проде. Вот, наверное, всё.
Ведущий: Спасибо большое. Тут Михаил в комментариях написал, что Chat GPT не знает китайские законы, поэтому у него подъём метрик заметнее других.
Дмитрий: Я думаю, что, на самом деле, не в том дело, что он не знает китайский. Чуть-чуть китайского там есть, вообще-то говоря, в Chat GPT.
Ведущий: Китайские законы.
Дмитрий: Да, но он просто вот этих датасетов не видел.
Дмитрий: В, если посмотреть, да, вот на вот эту, то есть Бай Чань, скорее всего, видел этот датасет. О чём я и говорю, что он даже после BLADE-а не сильно вырос потому что, скорее всего, датасет тут протёк.
Ведущий: Угу.
Дмитрий: Это это общая мечта, а проблема всех бенчмарков. Сейчас, кстати, недавно была какая-то статья, в которой детектировали протекание бенчмарков, но я ещё её не разбирал.
Ведущий: Это интересно, потому что, если так задуматься, это прямо проблема проблемы, как тестировать-то модели.
Дмитрий: Да, да, да, да, но я видел статью, в которой прямо предложена методология вскрытия протёкших бенчмарков, и они прошлись по моделям, и там живого места не оставили на этих бенчмарках. Как-то вот я сижу в рагах и раги читаю, поэтому, может, в следующем месяце расскажу про неё, если кто-нибудь раньше не успеет.
Ведущий: Вы можете скинуть? Может, кто-нибудь успеет.
Дмитрий: Скину, вот, потому что статья интересная и очень практичная.
Ведущий: Угу. Так, и я видела, что Ваня хочет спросить.
Из зала: Да, спасибо большое, Дмитрий, за интересный доклад. Я, возможно, не сильно внимательно его слушал.
Из зала: Вот концептуально, вот концептуально, чем эта идея отличается от идеи применения адаптеров для управления LLM-ками, как бы, достаточно давно ещё Uber самый первый же вот эту вот статью, что-то там мышка управляет мамонтом для адаптеров к LLM-ке, потом это целое направление стало, там разные адаптеры. Маленькая LLM управляет большой или адаптер достаточно большой адаптер управляет большой?
Дмитрий: Я думаю, разница, знаешь, в чём тут? Что у нас мы большую LLM используем без градиентов. В смысле, она не под нашим контролем, мы из неё градиенты не.
Из зала: Ага, то есть этот момент основной, то есть из-за этого мы городи огород, эту суррогатную модель большой LLM делаем, да, вот.
Дмитрий: Мне показалось что тут два момента. Что, во-первых это даёт нам возможность использовать вообще что угодно в качестве большой языковой модели, просто может быть, доступно по API, на самом-то деле, но не так много нужно вызовов. Это, кстати, позволяет не только, это позволяет бенчмаркаться на чужих моделях, не ставя авторов в известность, например.
Из зала: Я понимаю, но а если мы имеем доступ к, а, если мы имеем доступ к LLM да, там.
Дмитрий: Если мы имеем доступ, то, скорее всего, нам, а, и у нас бесконечные патроны, то нам, вполне возможно, достаточно просто по-тюнинга. Вот брать учить мягкую вот этот Soft Soft Prompt и не мучиться.
Дмитрий: Я бы вот Soft Embedding-и бы доучивал бы, да и всё.
Из зала: Или вот эти лоры использовать как бы, что, но лора - это же не бесконечные патроны, это, наоборот, как раз мы должны как-то выжить в условиях ограниченных ресурсов.
Дмитрий: Да, но, но, видишь, лора, она же у неё есть родовая травма, что она ищет Оптимизирует в пространстве низкой размерности. Хотя в принципе, её вот сейчас вот глория эту проблему решает, а ещё попалась статья, которая тоже вот я на неё смотрю, и хочется про неё рассказать, где они тоже строят проекции прямо весов и в проекциях оптимизируют, возвращают назад. Сама по себе идея, что мы можем дёшево оптимизировать модели, она в общем, скоро к нам придёт, даже большие. Дело в том, что и сами большие языковые модели, они растут как на дрожжах, и для вот Яндекс-то до выложил свою вот эту вот модельку, да?
С неё даже градиенты тут толком не возьмёшь, потому что у тебя инференс там очень медленный. Помнишь, когда они сначала ЯГПТ?
Из зала: Да-да-да, помню, помню, это я помню.
Дмитрий: Да, то есть варварски совершенно поступили, типа положили. И сейчас вот этот самый Грок, он в таком же виде, то есть ну вот он лежит его веса. Возьми ты с него градиент. У меня столько карт нет. Тут вот таким способом, на самом-то деле, нам от блэкбокс LLM нужен просто инференс, который можно на ЦПУ делать, понимаешь?
Из зала: Понятно, в общем-то, понятно. Спасибо. Угу.
Ведущий: Ещё был ну, небольшой вопрос-комментарий в чате от Виталия, что основное направление этой работы - это composability моделей.
Дмитрий: На самом-то деле основное направление работы их они говорили, как, как бы нам обойтись без без ну да, как комбинировать модели при условии, что к части вот этого пайплайна у нас нет доступа по градиентам. Вот, да.
Ведущий: Угу. Так, если у кого-нибудь есть вопросы или комментарии, можно задать или написать в чат.
Из зала: Ой, хотелось бы комментарий, если можно.
Ведущий: Угу.
Из зала: Слышно, да? Вот, если мы как бы берём вот за метафору то, что мы нанимаем модели как бы на работу, да, то вопрос теперь становится в том, что кого мы хотим нанять? Мы хотим нанять модель, которая обладает посредственными знаниями в широкой предметной области, или как бы очень специализированными знаниями, но сильно узкой предметной области.
Из зала: И вот, скорее всего, нужны и, видимо, и такие модели, и такие, и вот как раз-таки вот эта вот работа - это попытка дать нам возможность вот этим вот, вот этим вот как бы трейдоффом, а, или как там, управлять.
Дмитрий: Да-да-да. Да, смотрите, вот есть вот этот слайд из их бенчмарков, почему я выбрал именно его? Потому что вот тут проявляется, что грубо говоря, вот например вы, может быть, кандидат наук, да, вы не возьмёте себе школьника четырёхлетнего в напарники, да? Есть какой-то минимальный интеллектуальный уровень человека, который мог бы продуктивно вас поддерживать в работе, да? И чем он выше ваш уровень, тем выше требования к вашему помощнику. И вот тут посмотрите, у нас 1,7 модель может хорошо помогать 7B модели и 6B модели. Уже чат GPT она не очень-то сильно и помогает. И 13B модели она не так сильно помогает. Не должен быть большой разрыв между моделями, чтобы они в такой паре должны быть.
Грубо говоря, порядок может быть там, да? Вот, а два порядка уже нет, например. Опять же, то есть у нас в команде есть специалисты разные, но они не так, чтобы один тихий дебил, а второй прямо светило. И вот этот, этот момент есть, да.
Из зала: Да. Всё корректно. Ещё, а, как бы под composability что понималось, что наверняка как бы следующим шагом вот в вот в этом исследовании будет хорошо, мы натренировали вот одну такую вот модель. Можем ли мы натренировать одну поумнее, потом ещё сильнее, поумнее, ещё и так далее? Как бы, можем ли мы их вот как бы стакать друг на друга для того, чтобы получать как бы всё более и более мощного специалиста, и, соответственно затраты на инференс такого специалиста будут тоже расти пропорционально, чем он будет умнее, тем больше моделей будет как бы застакано. Я вот, вот, наверное, про это как бы хотел.
Дмитрий: На самом деле, мне кажется, что проще попробовать пару, то есть вот, в моей конкретной области, где я живу, да, я вообще торговец, а не учёный. Вот, там в производстве всегда есть директор и завпроизводством. Вот, то есть это люди одного уровня, но по-разному сконцентрированы, с, с настроены. И вот тут мы точно так же, на самом деле, могли бы взять две модели одинаковой примерно сложности, но одну бы мы учили отвечать в общем, а вторую формулировать частные знания.
Они не обязательно должна быть простой. Они говорят: "Ну, здорово, что она простая, тогда её можно дёшево учить". Но мне кажется, что даже если бы они брали две сложные модели, всё равно бы они получили плюс от composability и так далее и тому подобное.
Дмитрий: И ещё вот этот сценарий, который я в конце рассказал, что mixture of expert, моэ. Мы можем, а, получить некоторое количество экспертов узких областей и затем достаточно простой метамоделью выбирать, какого конкретно эксперта мы будем спрашивать вот в этом конкретном случае. Это то, как Мистраль устроен, например, да? И это позволяет модель эволюционно наращивать. Вы такой раз, обучили, ещё одного эксперта добавили, обучили, ещё одного эксперта добавили. Вот, потом вы обучили какую-то большую модель, новую версию, вам не надо выкидывать всех экспертов. Вы просто софт эмбединги для них доучили чуть-чуть, чтобы они с новой моделью умели работать. И вот, получается, что мы вместо того, чтобы всё переучивать, мы получаем большой комбайн, который можно апгрейдить по частям.
Вот я так вижу.
Из зала: Да, спасибо. Полностью совпало видение у нас с вами.
Дмитрий: Угу.
Ведущий: Спасибо. Я, может, ещё кого-то появятся комментарии, я пока хотела сказать, что мне на самом деле больше всего запала в душу вот эта первая часть, вот как раз на этом слайде, где они фильтруют знания.
Дмитрий: Да-да-да, очень. Она очень практичная, потому что её можно использовать в любом другом проекте.
Ведущий: Да-да-да. Как-то, возможно, выбирать, увеличивать вес, не знаю, удалять знания, прикольно.
Дмитрий: Да. Они вообще молодцы. Вот я, как про то, что учить китайский, это я вообще не шучу, я его учу активно. Потому что это вот они сейчас ещё по-английски публикуются более-менее, а потом они в какой-то момент перестанут публиковаться по-английски. Что хотите, то и делайте.
Ведущий: Где бы ещё столько время брать, как они статьи пишут, с какой скоростью.
Дмитрий: Да. Да, это вот тоже демотивирует, конечно. Вот, но они хорошие статьи пишут. Пусть по три в месяц, но хорошие. Я не знаю, как, как у них это получается.
Ведущий: Не все, наверняка, хорошие, но, да, согласна. Есть классные.
Ведущий: Так, вроде закончились вопросы. Я думаю, что в любом случае всегда можно написать в чат. Вот, предлагаю тогда на этом заканчивать.
Дмитрий: Всё, ладно, спасибо.
Ведущий: Спасибо вам большое, и всем спасибо, что Сейчас, сейчас, сейчас скину в чатик. Всё, спасибо большое, Гай, всем хорошего вечера.