- 16.07.2024
- 30.10.2026
- выступления
- #NLP
На канале DS Talks разбирали статью STaRK: Benchmarking LLM Retrieval on Textual and Relational Knowledge Bases.
Слайды: stark.pdf
Текстовая расшифровка доклада (автоматическая, еще не вычитана):
Сегодня я хочу рассказать про статью Stark, Benchmarking and Retrieval of Textual and Relational Knowledge Bases.
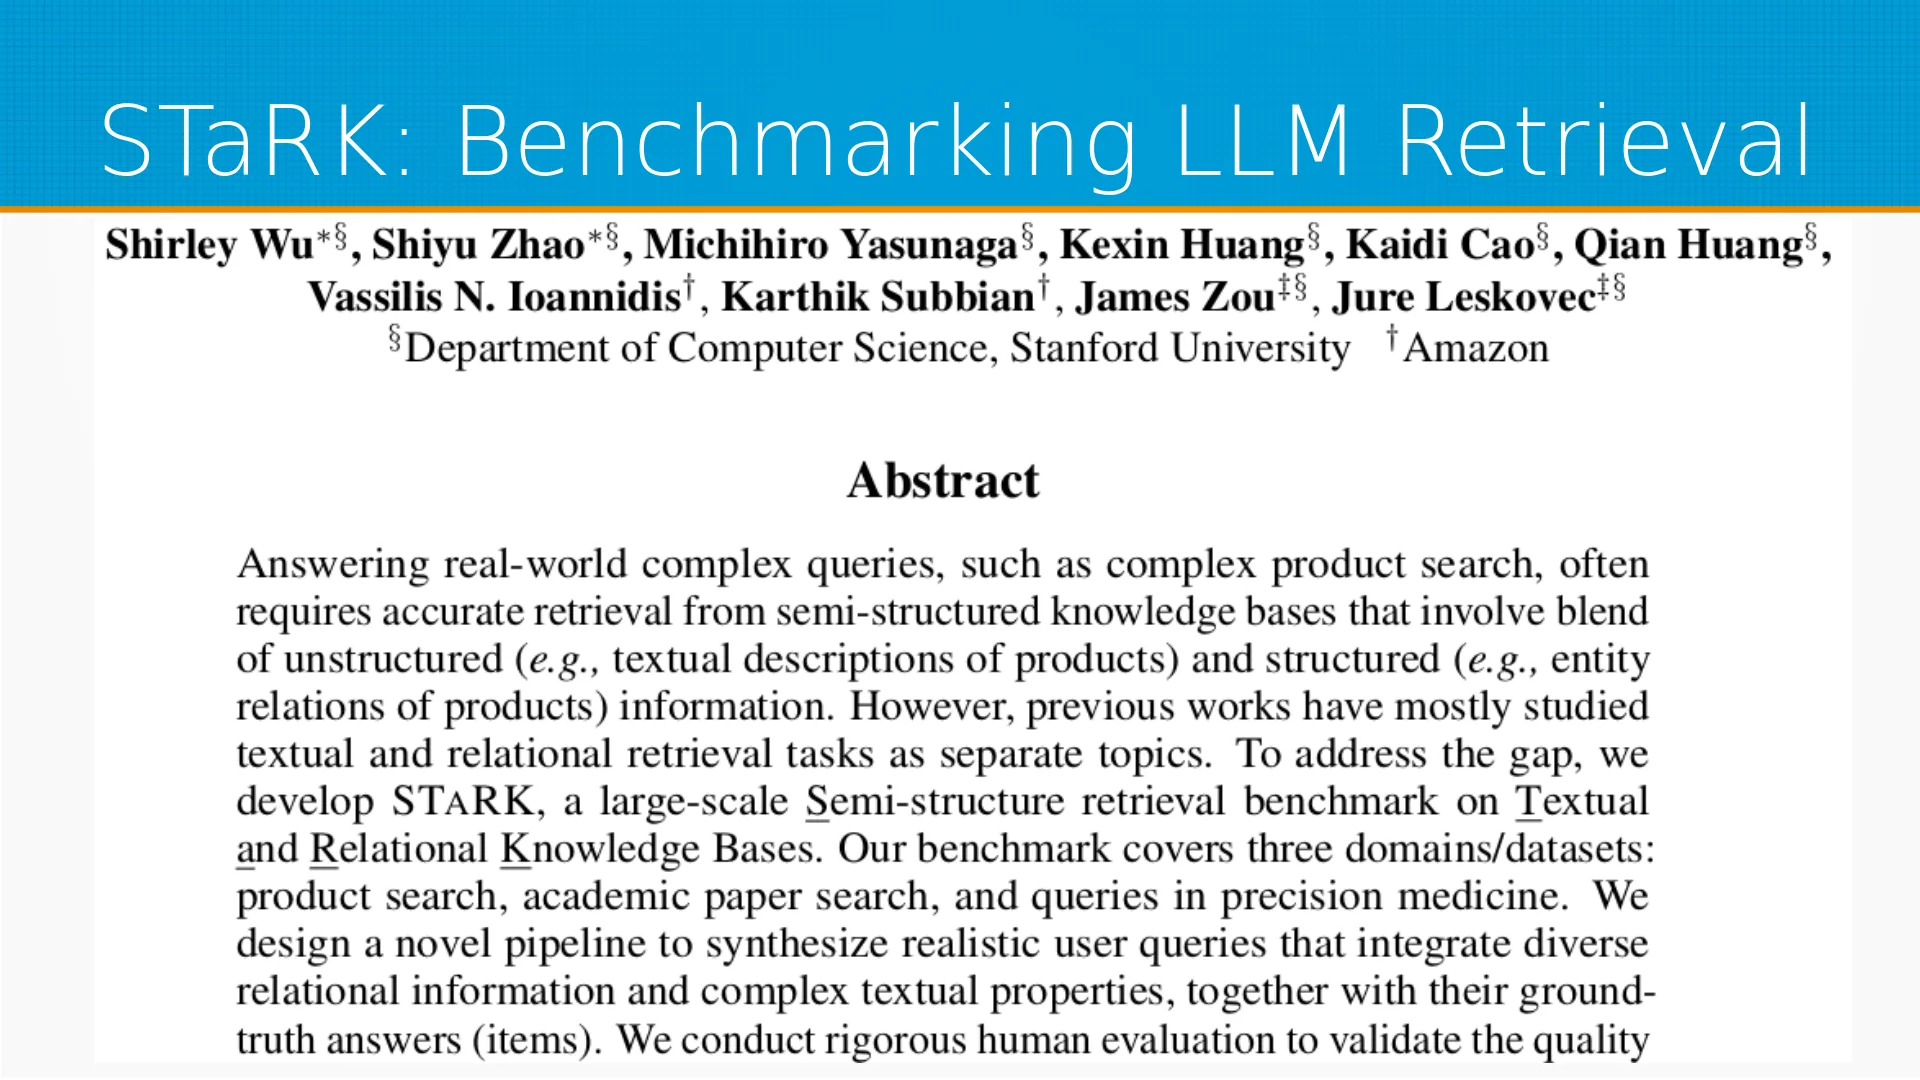 Статья про то, что в большинстве бенчмарков для оценки поиска с помощью LLM либо ищут текст, либо генерируют запросы для поиска в базе данных или графе.
Но в реальной жизни у нас одновременно существует и текст, и какая-то мета-информация о нем в базе или графе. И интересно посмотреть, как LLM сможет искать, используя всю доступную информацию.
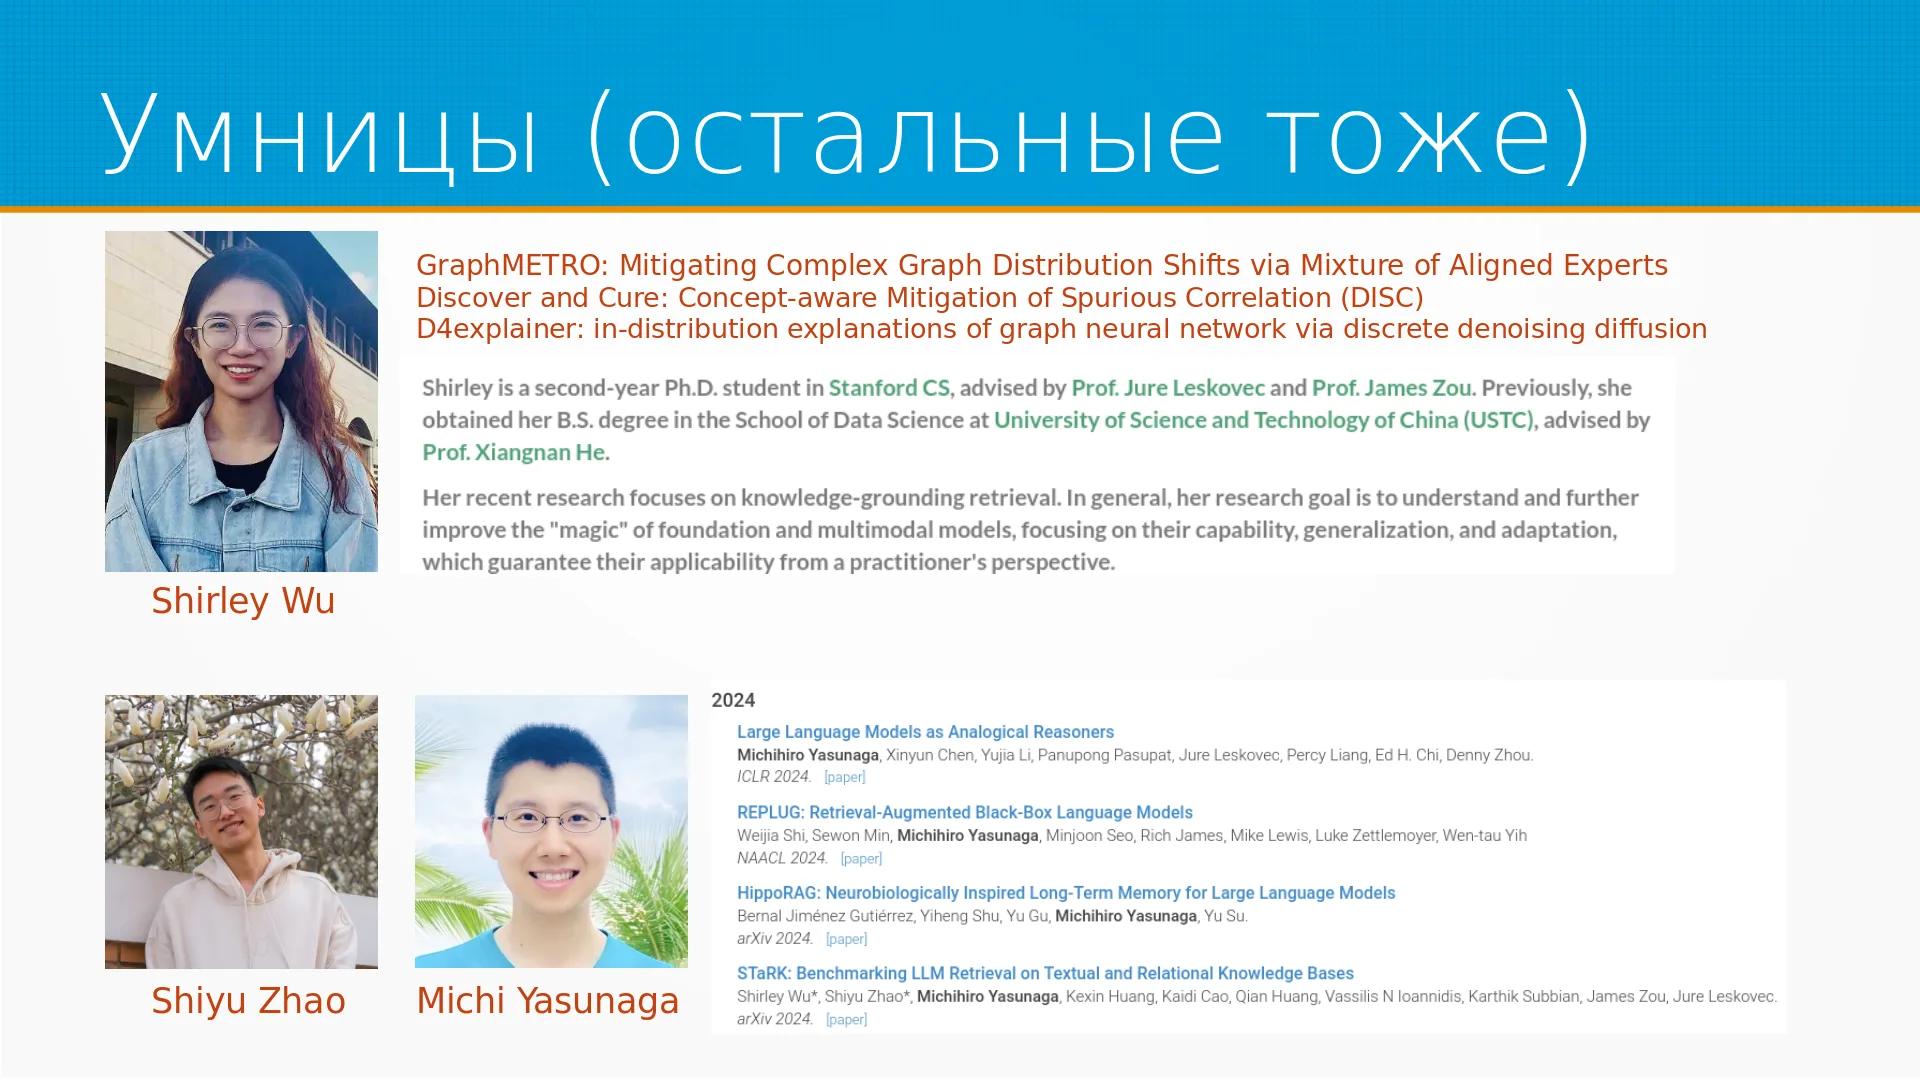 У статьи 10 авторов. Последний - всем известный Юрий Лесковец. Интересно, что они вдвоем с Джеймсом Цоу научруки у первого автора, Ширли Ву, как будто Юрия одного не хватило ;-)
Два предпоследних автора, Василис и Кэрфик, работают в Амазоне. Возможно, они предоставили датасеты. Шестеро ребят в первой строке с простыми американскими фамилиями - студенты Лесковеца. Думаю, что они все и делали.
Студенты умницы. Если посмотреть, например, на Ширли Ву, она просто Гермиона какая-то. У нее есть сайт, и на ней собранны ее статьи.
Много интересных статей про объяснимость графовых сетей, про извлечение информации, про LLM. Мне вот три понравились, например: * борьба со сдвигом данных в графах через смесь aligned экспертов. Я даже подумать не мог, что такое можно сделать. Оказывается, можно. * поиск выявлений и избежание spiritus correlations, то есть случайных совпадений. * D4explainer - модель, которая объясняет, как графовая нейронная сеть принимает решения.
Еще мне понравился Мичи Ясунага. У него в этом году четыре хорошие твердые статьи. Остальные ребята не такие крутые, но тоже очень хороши.
И, а о чём, собственно говоря, эта статья? О том, что поиск сейчас у нас везде. Но живые данные организации, они обычно, а, имеют какие-нибудь relations внутри, то есть это тексты со связями. И как измерить качество поиска на таких данных? Непонятно. И хорошо ли справляются текущие системы вот, если мы возьмём какую-нибудь, а, нормальную текущего инженерного уровня систему поисковую, сделаем её, не особо загоняясь. Насколько хорошо она будет искать в таких датасетах? И вот Левковиц говорит, что искать оно будет плохо. Нам нужно больше золота, нужны более мощные information retrieval системы.
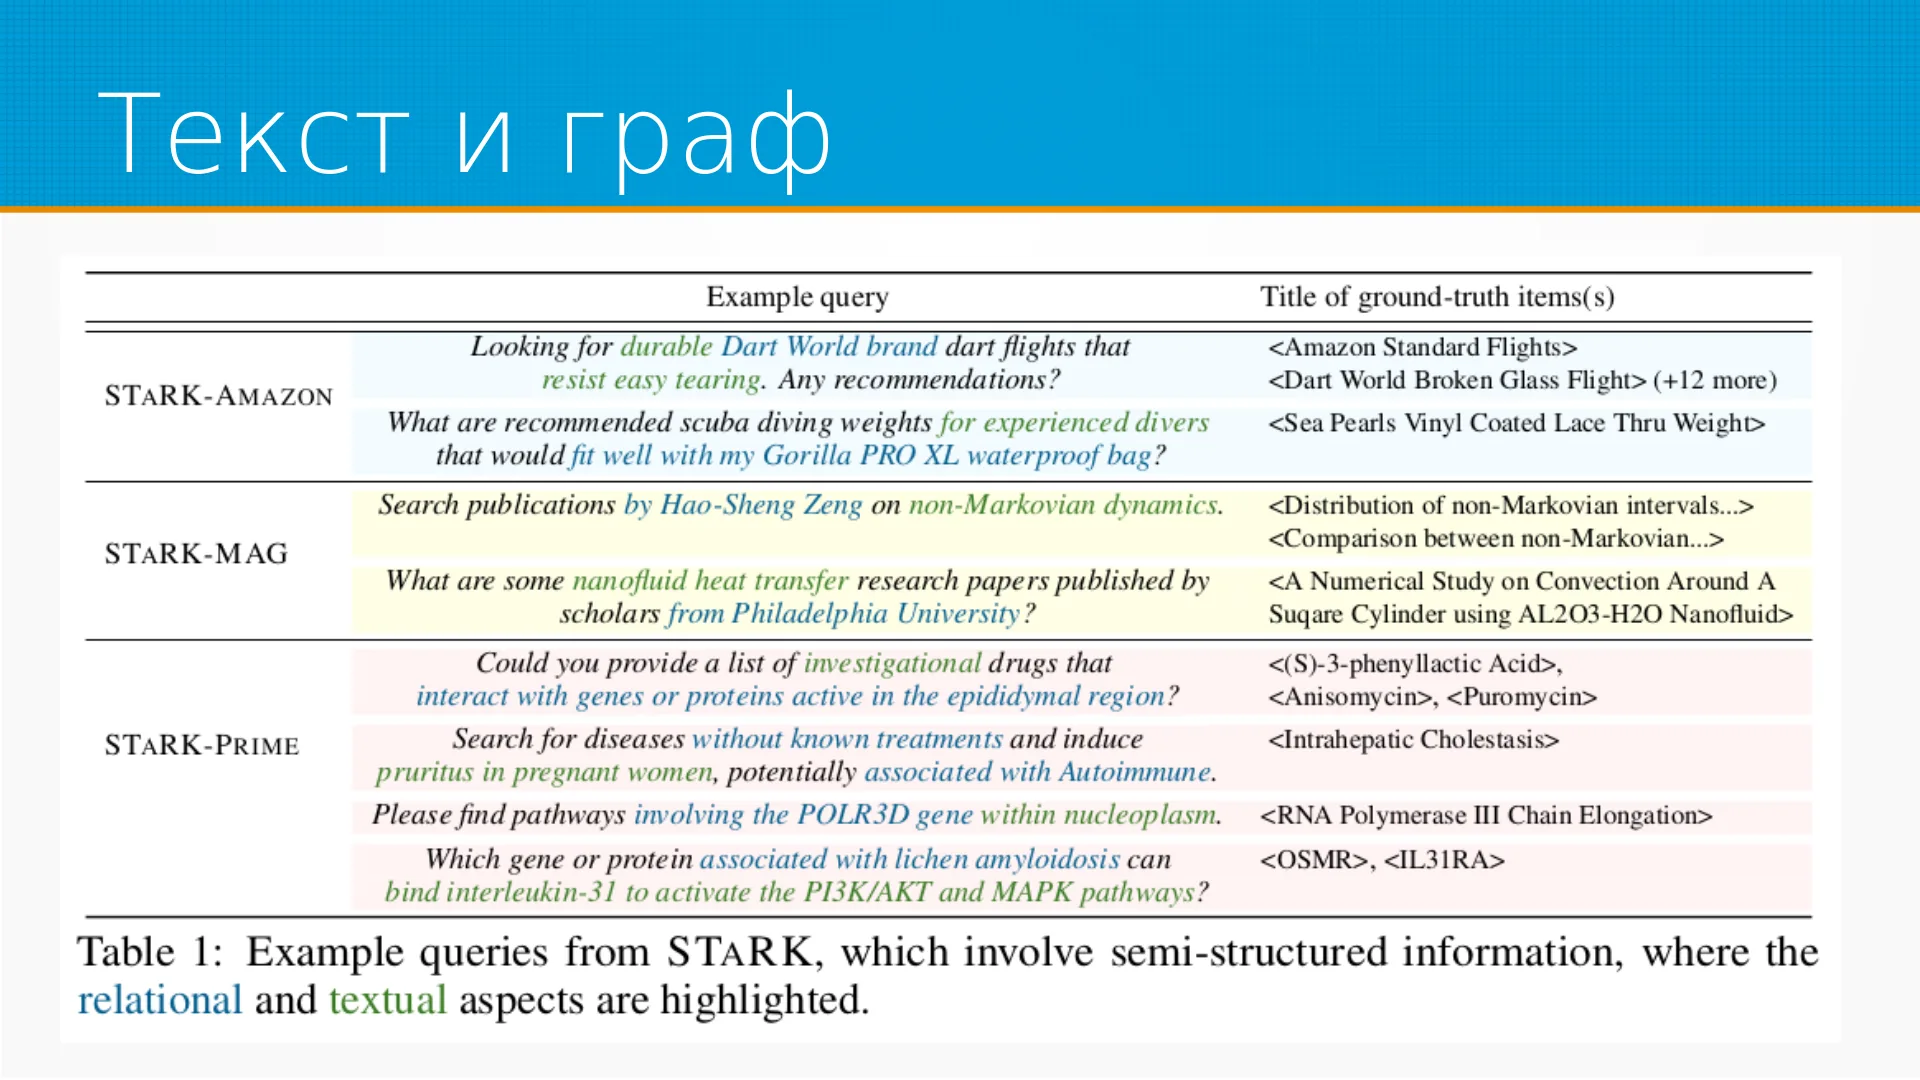
Какой датасет они сгенерировали? Они сгенерировали датасет запросов. Он устроен так, чтобы в каждом вопросе у нас был вопрос на структуру и вопрос, собственно, на текст. Например, "Looking for durable Dark World brand Dark Flight that resist early tearing. Any recommendations?" То есть, а, он тут нас спрашивает о конкретном бренде, а, и о его характеристиках товара. Вот, ну и какие сущности должны были найти. Использовались три датасета. Один датасет про товары. Второй датасет по научным публикациям, и третий датасет по, я не знаю, как это по-русски сказать, по точной медицине. Это что-то на уровне фармакологии, молекулярной, смесь фармакологии, а, молекулярной биологии и чего-нибудь ещё.
И достаточно сложные вопросы, но они осмысленные. Вот, примеры такие есть. Раньше поиск тестировали, есть люди по тексту, тестировали запросы к графу писали.
И иногда кто-то делал тестирование, хмм, бенчмарки по поиску текста с графом знаний каким-то. Но обычно использовались графы знаний из Википедии. Тут проблема, что знания из Википедии, они в общем, и так есть в языке. LLM-ка и так понимает взаимосвязи, которые мы из Викидаты возьмём. Корпоративные же данные устроены иначе обычно. И вот про датасеты. Датасет с амазоновскими продуктами, там содержалось типа бренд, эти товары смотрели вместе.
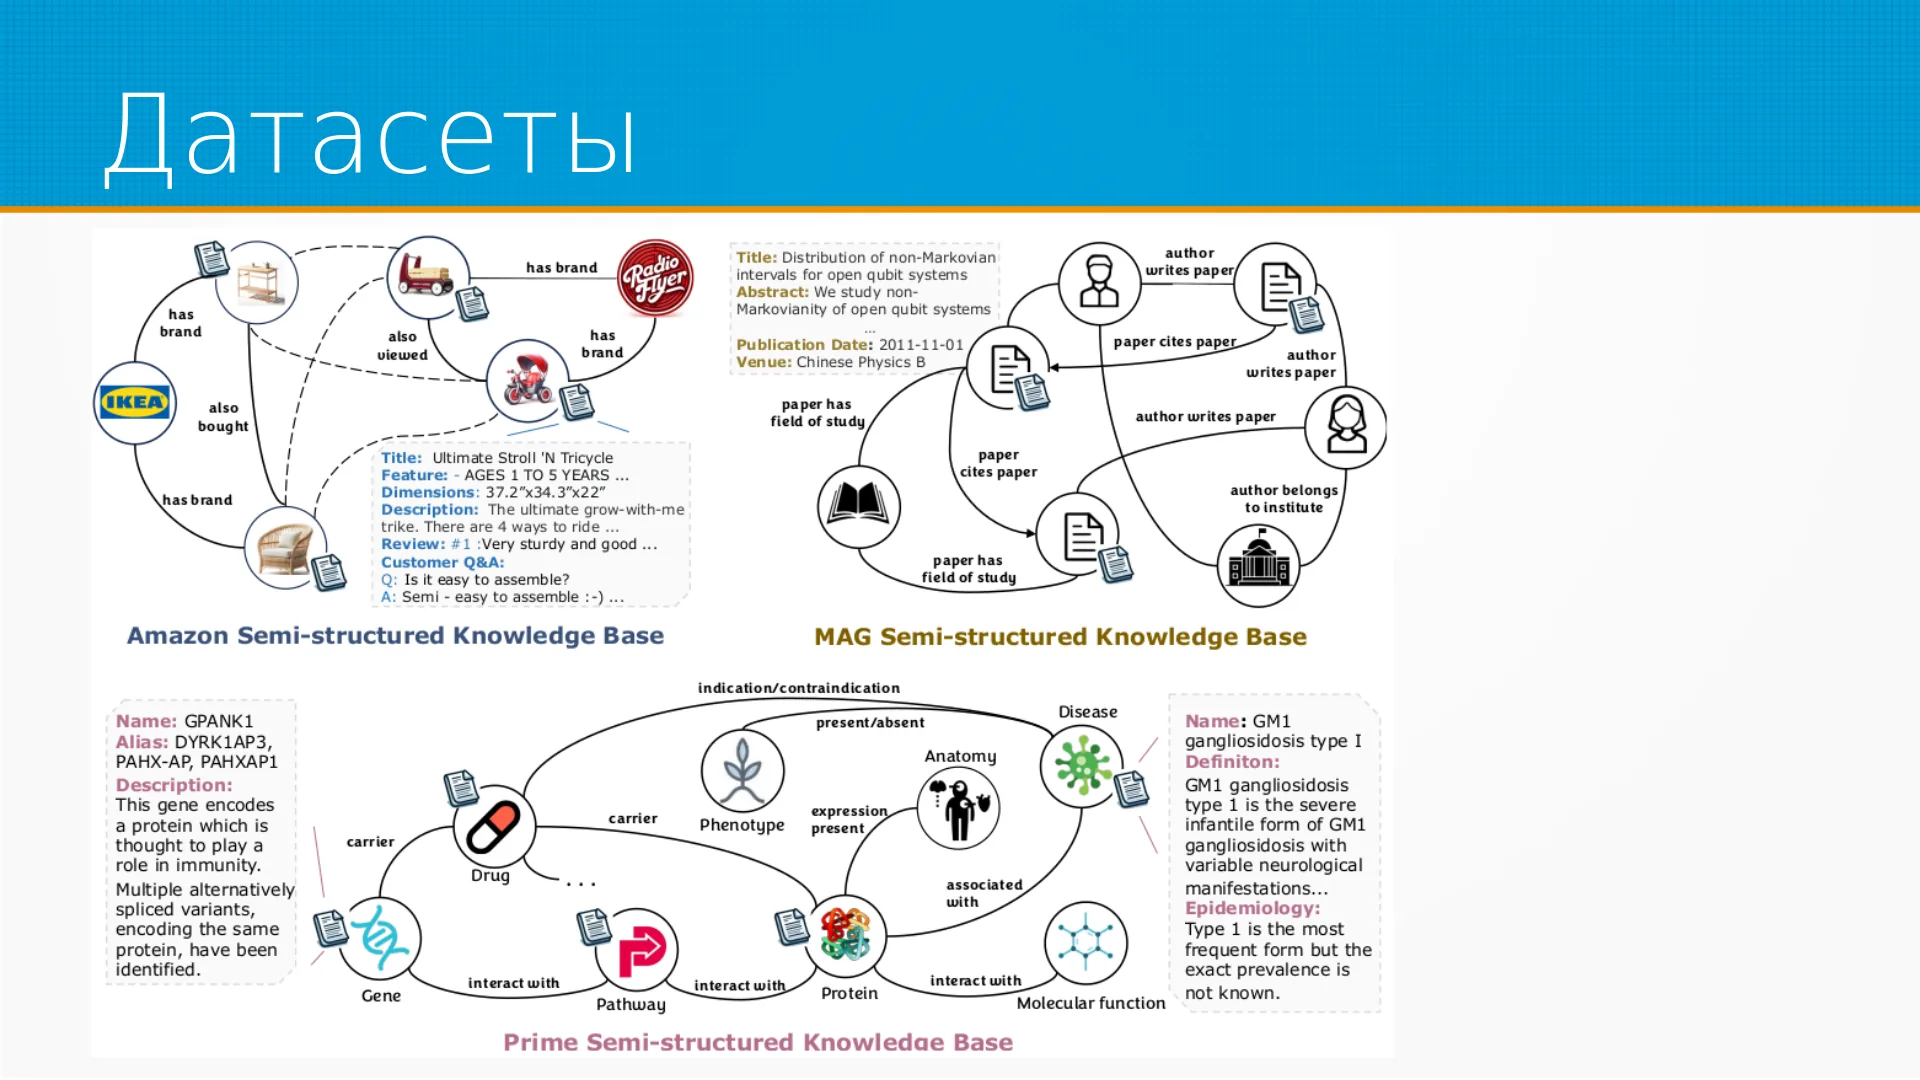
Вот, эти товары покупали вместе. И текстовое описание к каждому узлу. По журнальным по научным статьям - это, а, автор написал вот эту статью, эту статью процитировали в этой статье, и они делались, значит, в общем, institution или они относились к этой области знаний, в общем, такое. С точной медициной там самое сложное. Есть гены, есть лекарства, есть некоторые фенотипы, есть анатомические подробности, белки, болезни и так далее. Всё это как-то вот связано.
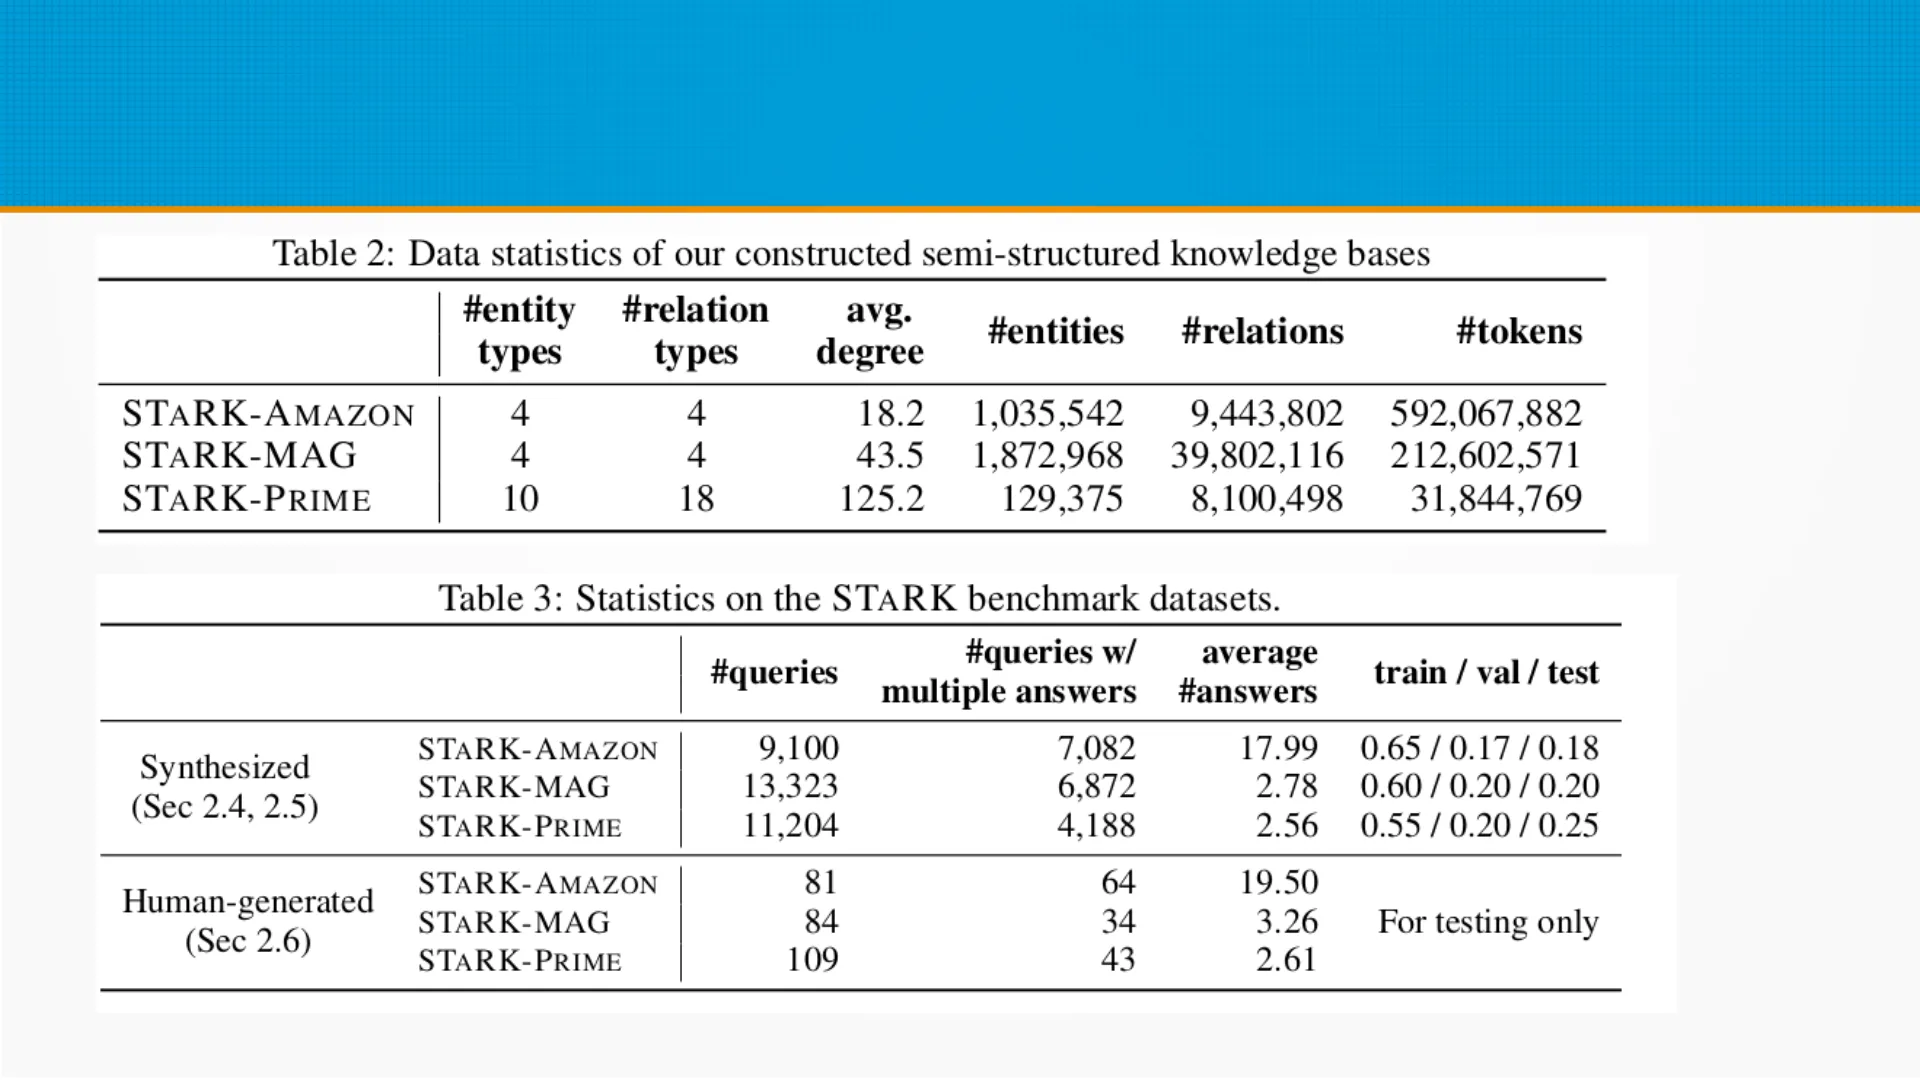
Датасеты очень разные по своей графовой структуре. Если Stark Amazon очень простой датасет, там четыре типа сущностей, четыре типа отношений, и, в общем средняя степень графа, я не знаю, тоже, как по-русски это сказать, а, 18. В среднем там 18 соседей у узла. То, например, в Stark Prime там 10 типов сущностей, 18 типов отношений и средняя степень 125. Очень плотно связанный граф. Датасеты также отличаются по размеру, и было сгенерировано некоторое количество запросов. Часть из них была с множественными ответами, часть, а, с одиночными ответами. Их поделили на train-val-set. Логика деления именно в такой пропорции мне непонятна, я её нигде не нашёл.
Также некоторое количество запросов, а, по этой же схеме сгенерировали руками людьми. Их не использовали только для тестирования самого датасета, то есть для сравнительного анализа.
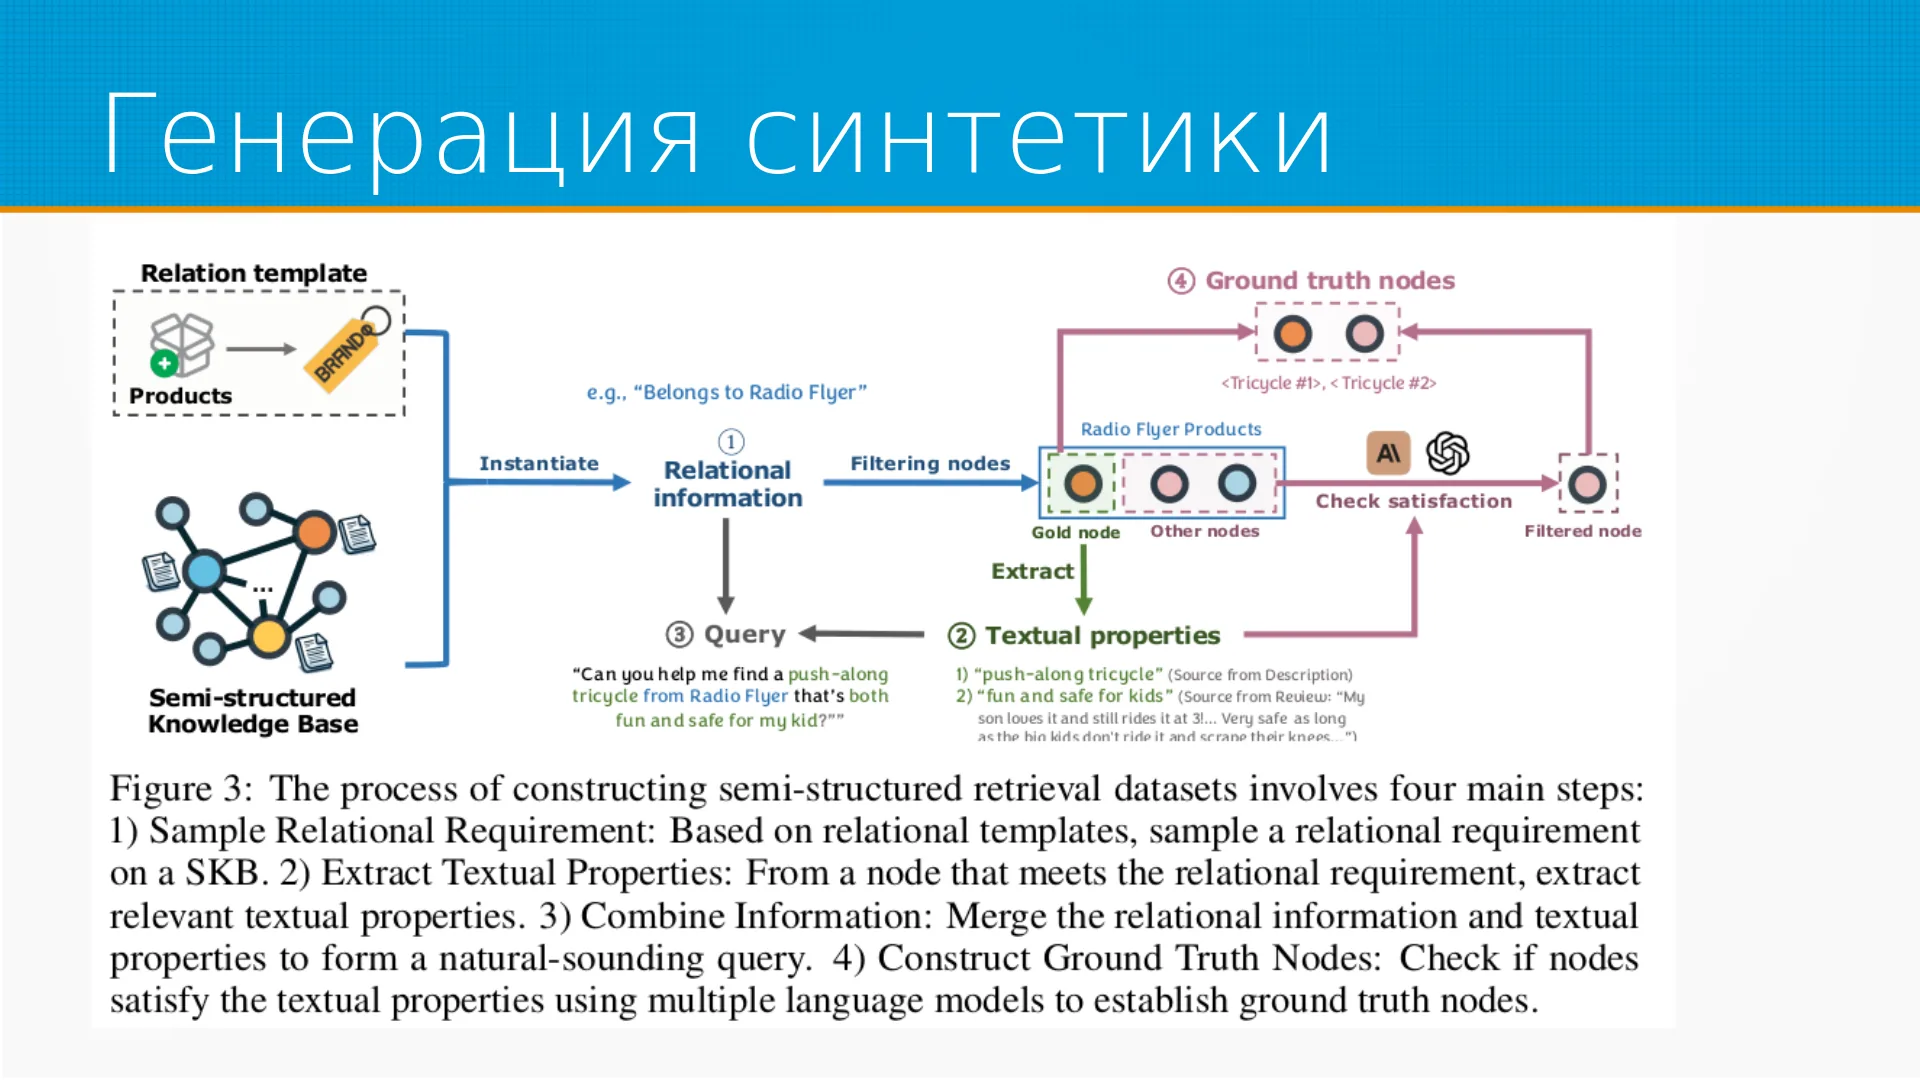
Как генерировали эту самую синтетику? У нас есть некоторый граф, и мы из него сэмплируем, а, подграф. Некоторый. Например, а, товар такого-то бренда который покупали вместе с таким-то товаром, да? Затем мы смотрим, какие узлы у нас отвечают вот этому подграфу. Выбираем один из этих узлов, подходящих заведомо, и вытаскиваем из него тестовое текстовое описание. Затем мы с помощью LLM комбинируем из текстового описания и пути на графе запрос. "Can you help me find a push along tricycle from Radio Flyer that's both fun and safe for my kid?" Вот. И затем мы проверяем по этому текстовому описанию с помощью Chat GPT подходит ли другие узлы на этом пути под это описание.
И те, которые подошли, мы откладываем как ground truth node, то есть разметку. Такой вот четырёх шаговый путь.
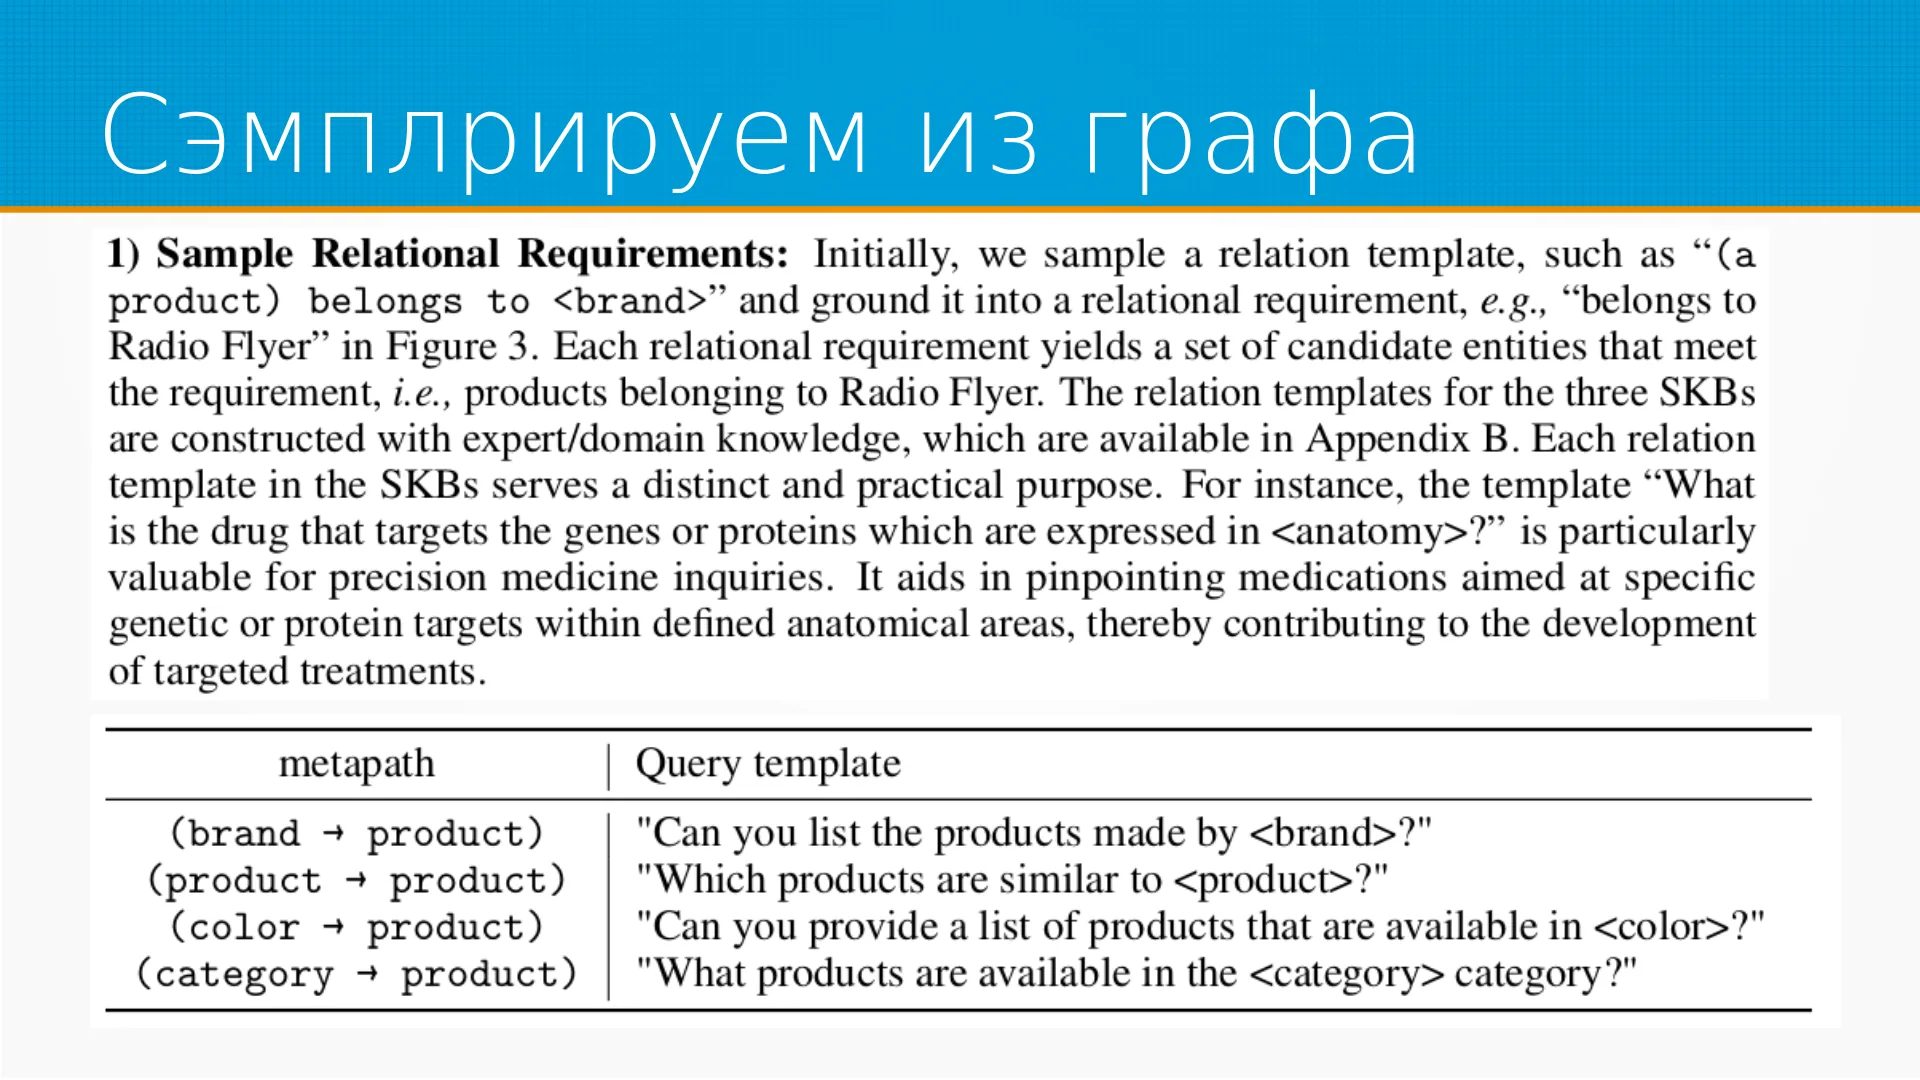
Сначала мы сэмплируем из графа, а, и вот пример, например, как мы из графа продуктов. У нас есть некоторые метапути, то есть, от бренда к продукту, от продукта к продукту. "Can you list the product made by brand?" и так далее. Там в самой статье все эти шаблоны и мета метапути изложены. После того, как мы на сэмплировали эти отношения, мы извлекаем текстовые свойства с помощью вот такого промпта.
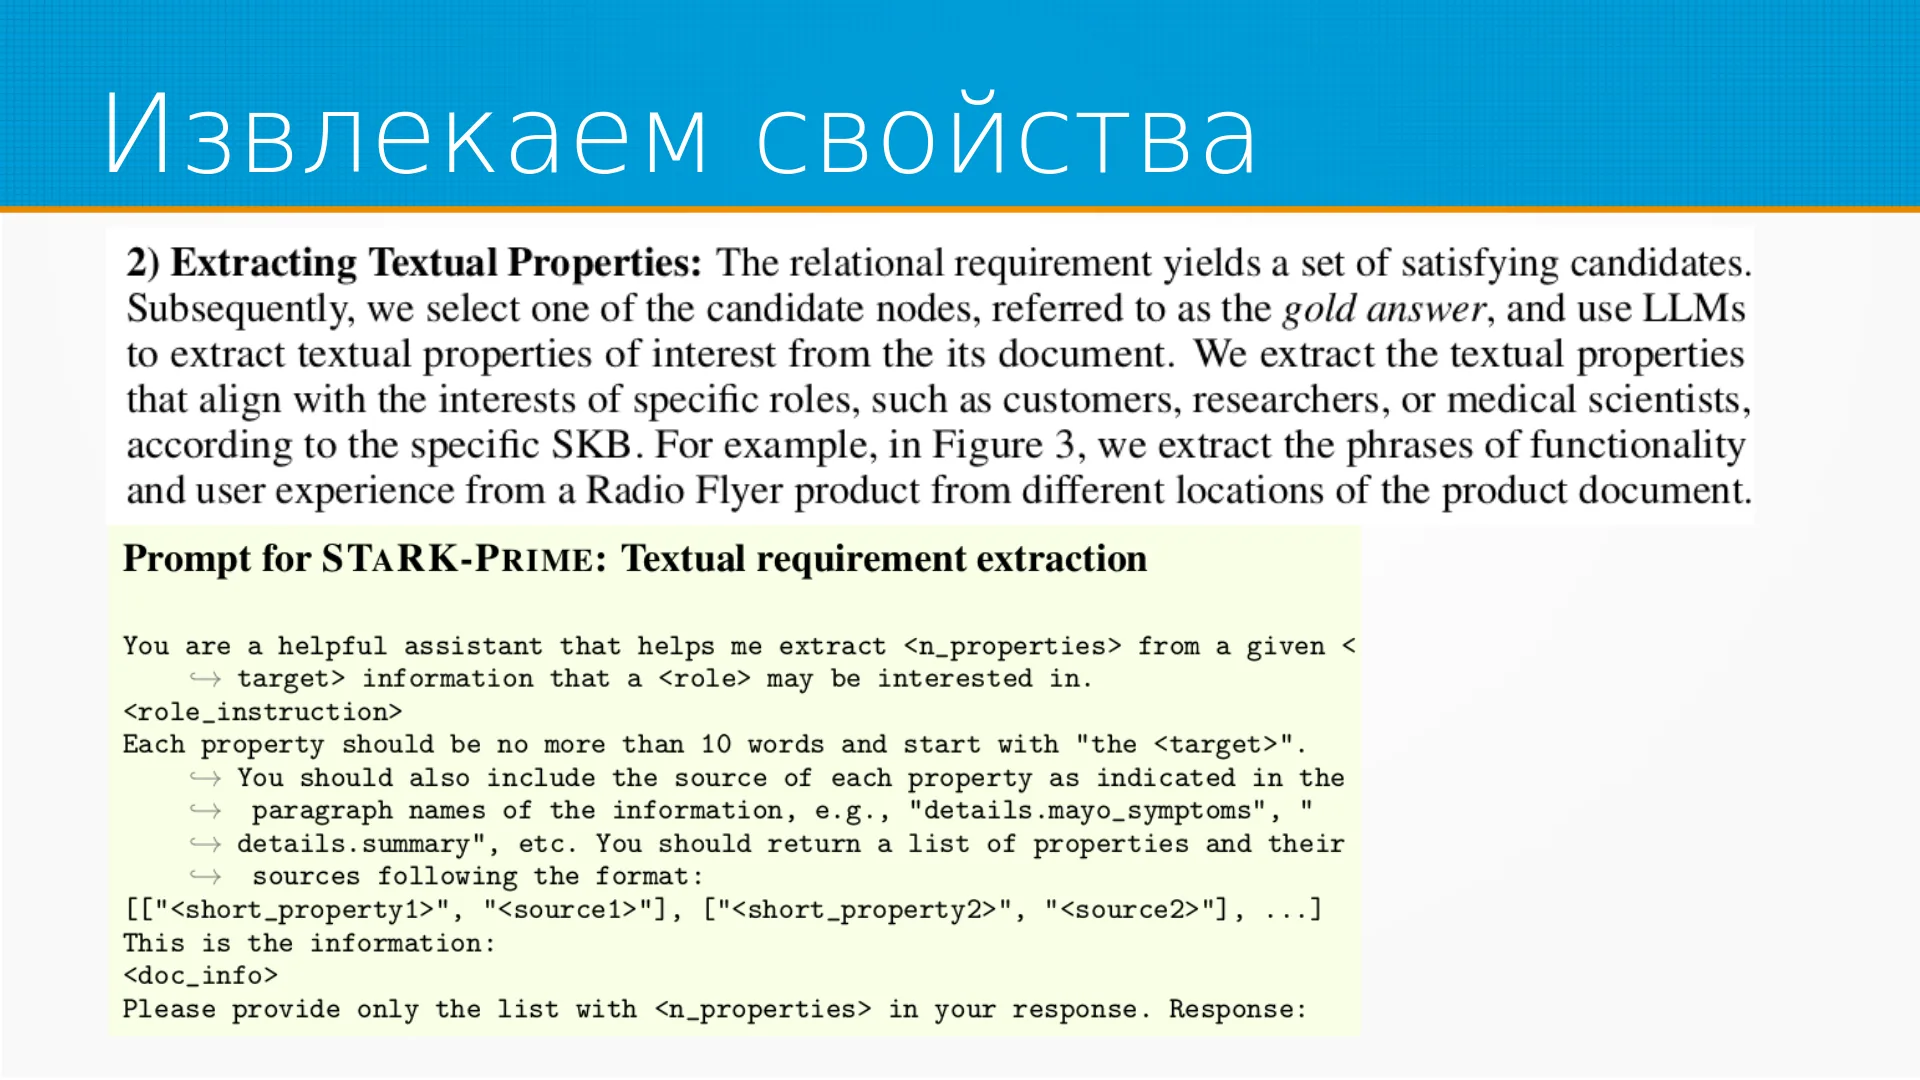
Промпт для каждого датасета свой, я здесь его вытащил кусок коротенького текста. В общем в промпте ничего такого военного нет. Ты ассистент, который можешь, можешь мне помочь вытащить N свойств которые бы хорошо характеризовали этот товар. Затем мы с помощью ЛЛМки собираем же назад запрос.
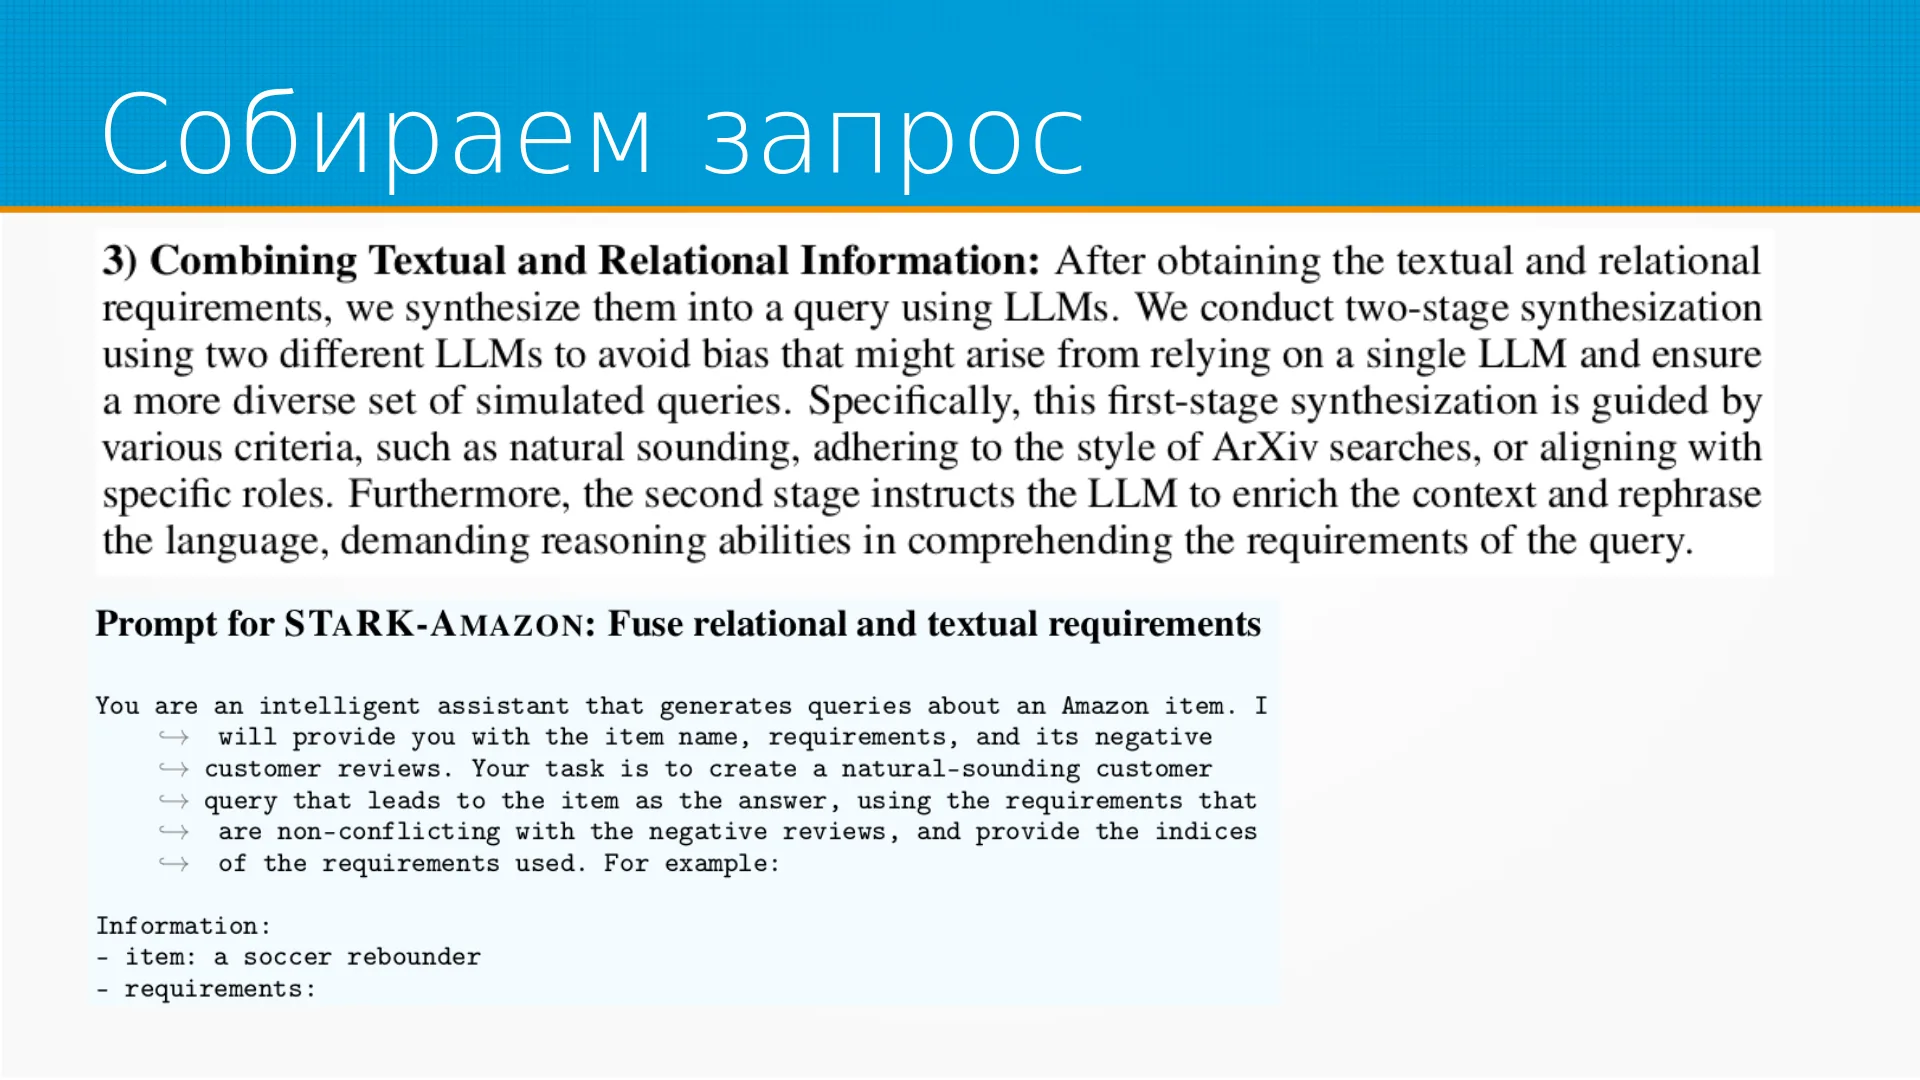
Вот, то есть у нас есть наш подграф, у нас есть наша текстовая информация, мы собираем запрос и затем, а, с помощью ЛЛМки же мы его фильтруем.
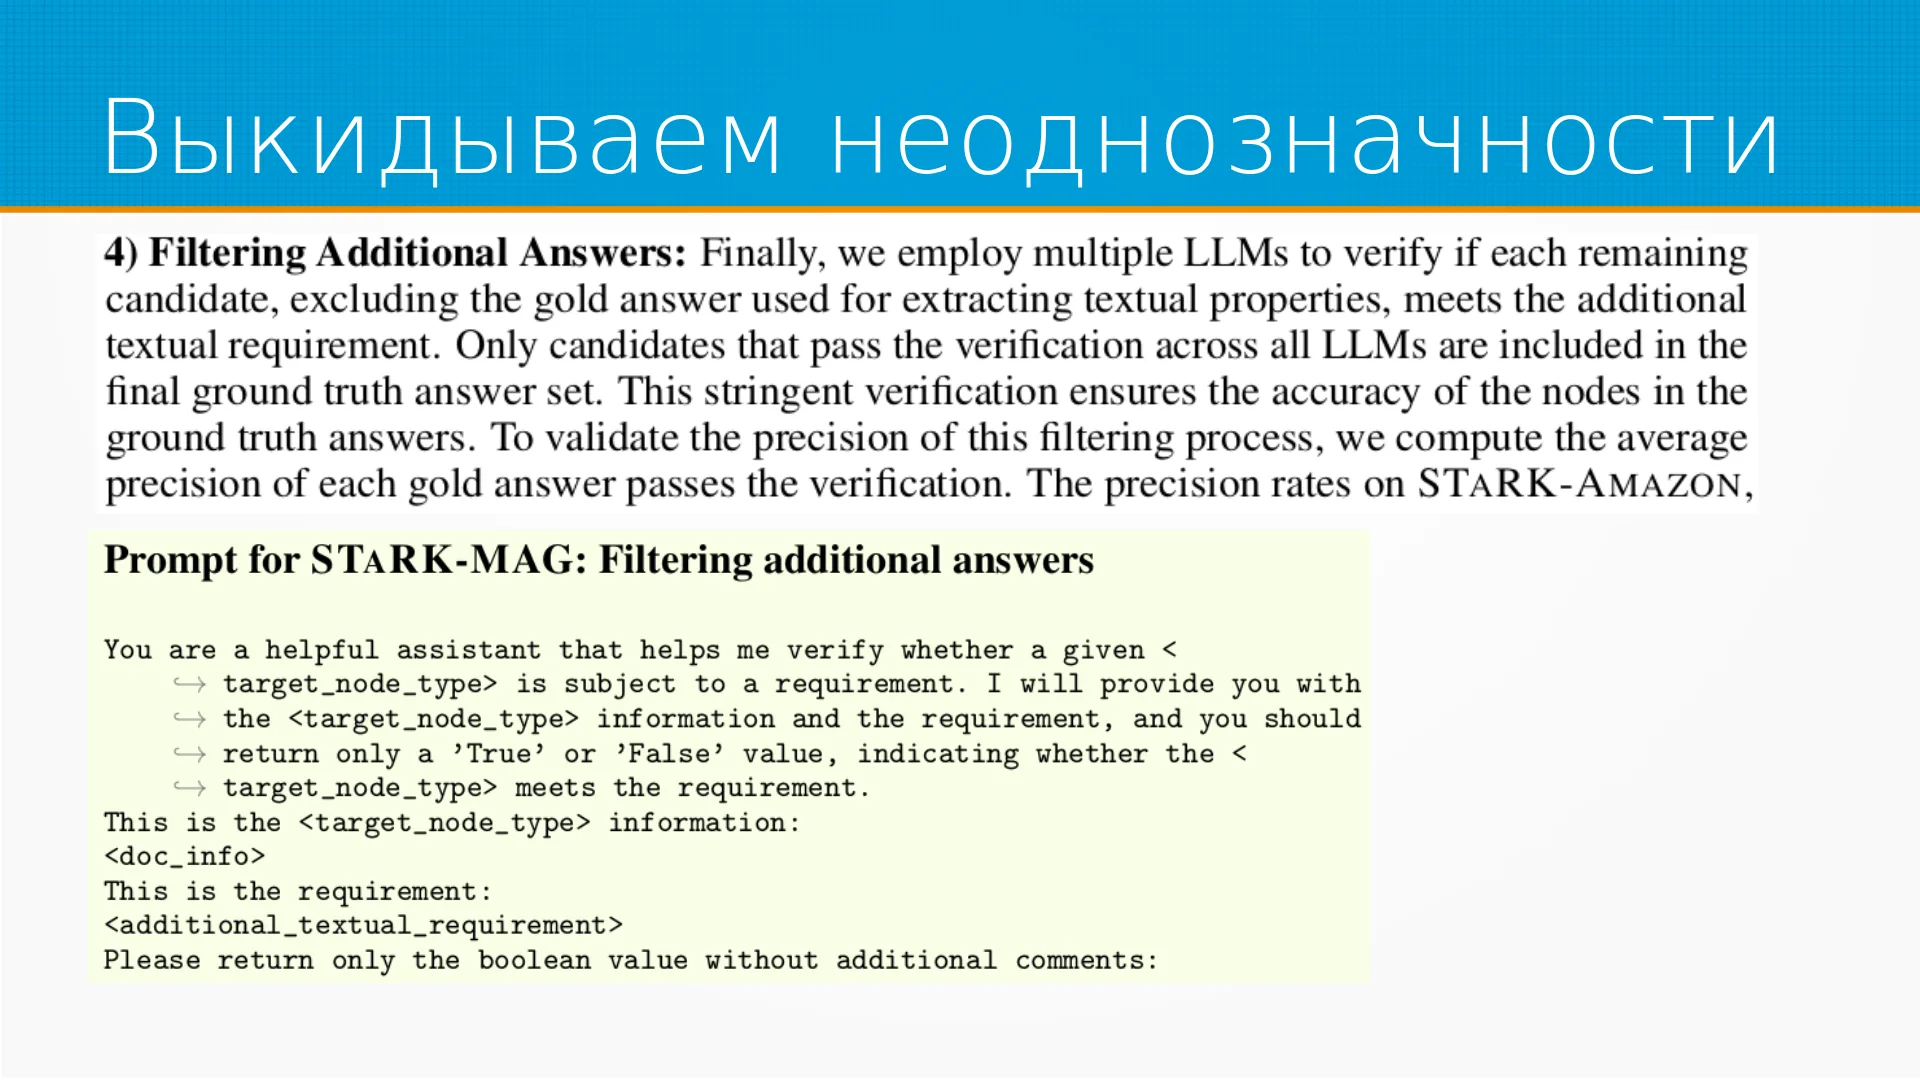
Для того, чтобы проверить качество получившихся запросов немножко запросов сгенерировали людьми.
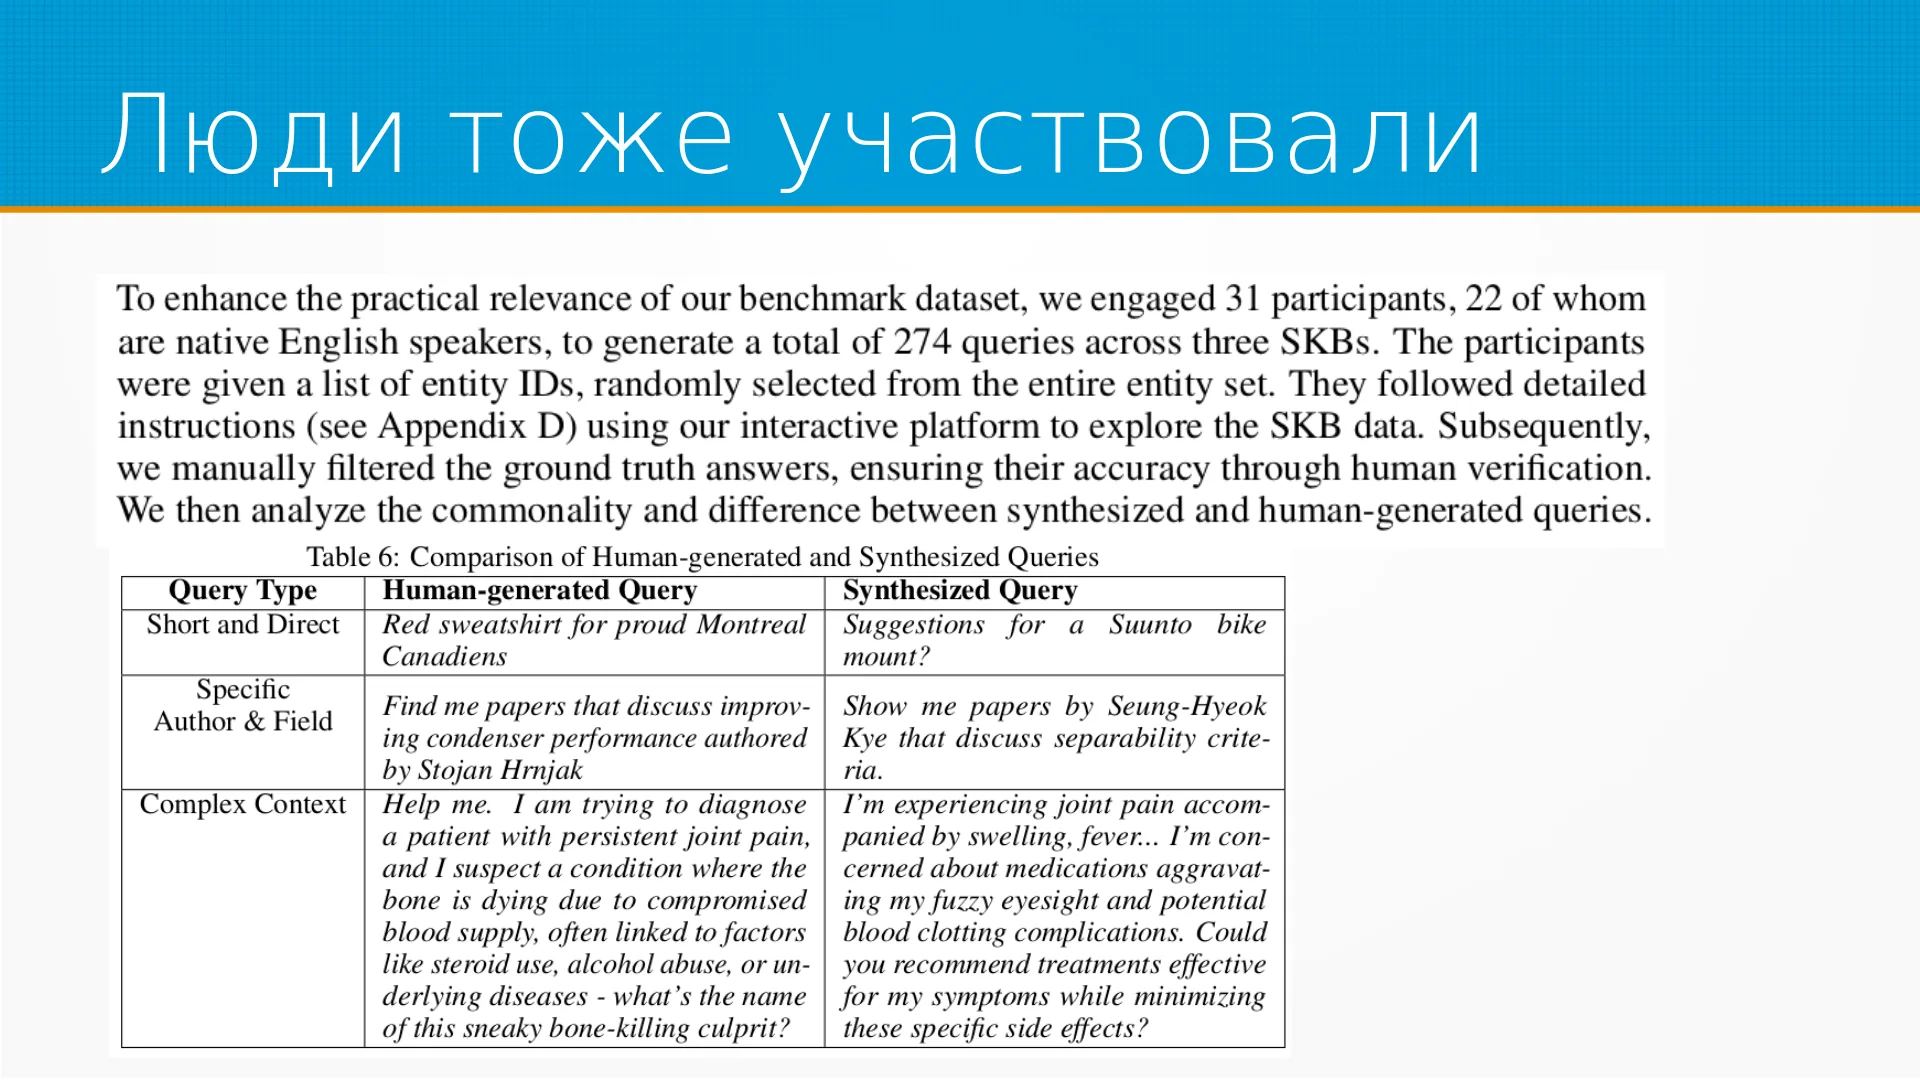
Тут получилось, что всего 274 запроса сгенерировали людьми и в общем, они достаточно похожи на запросы, сгенерированные ГПТ.
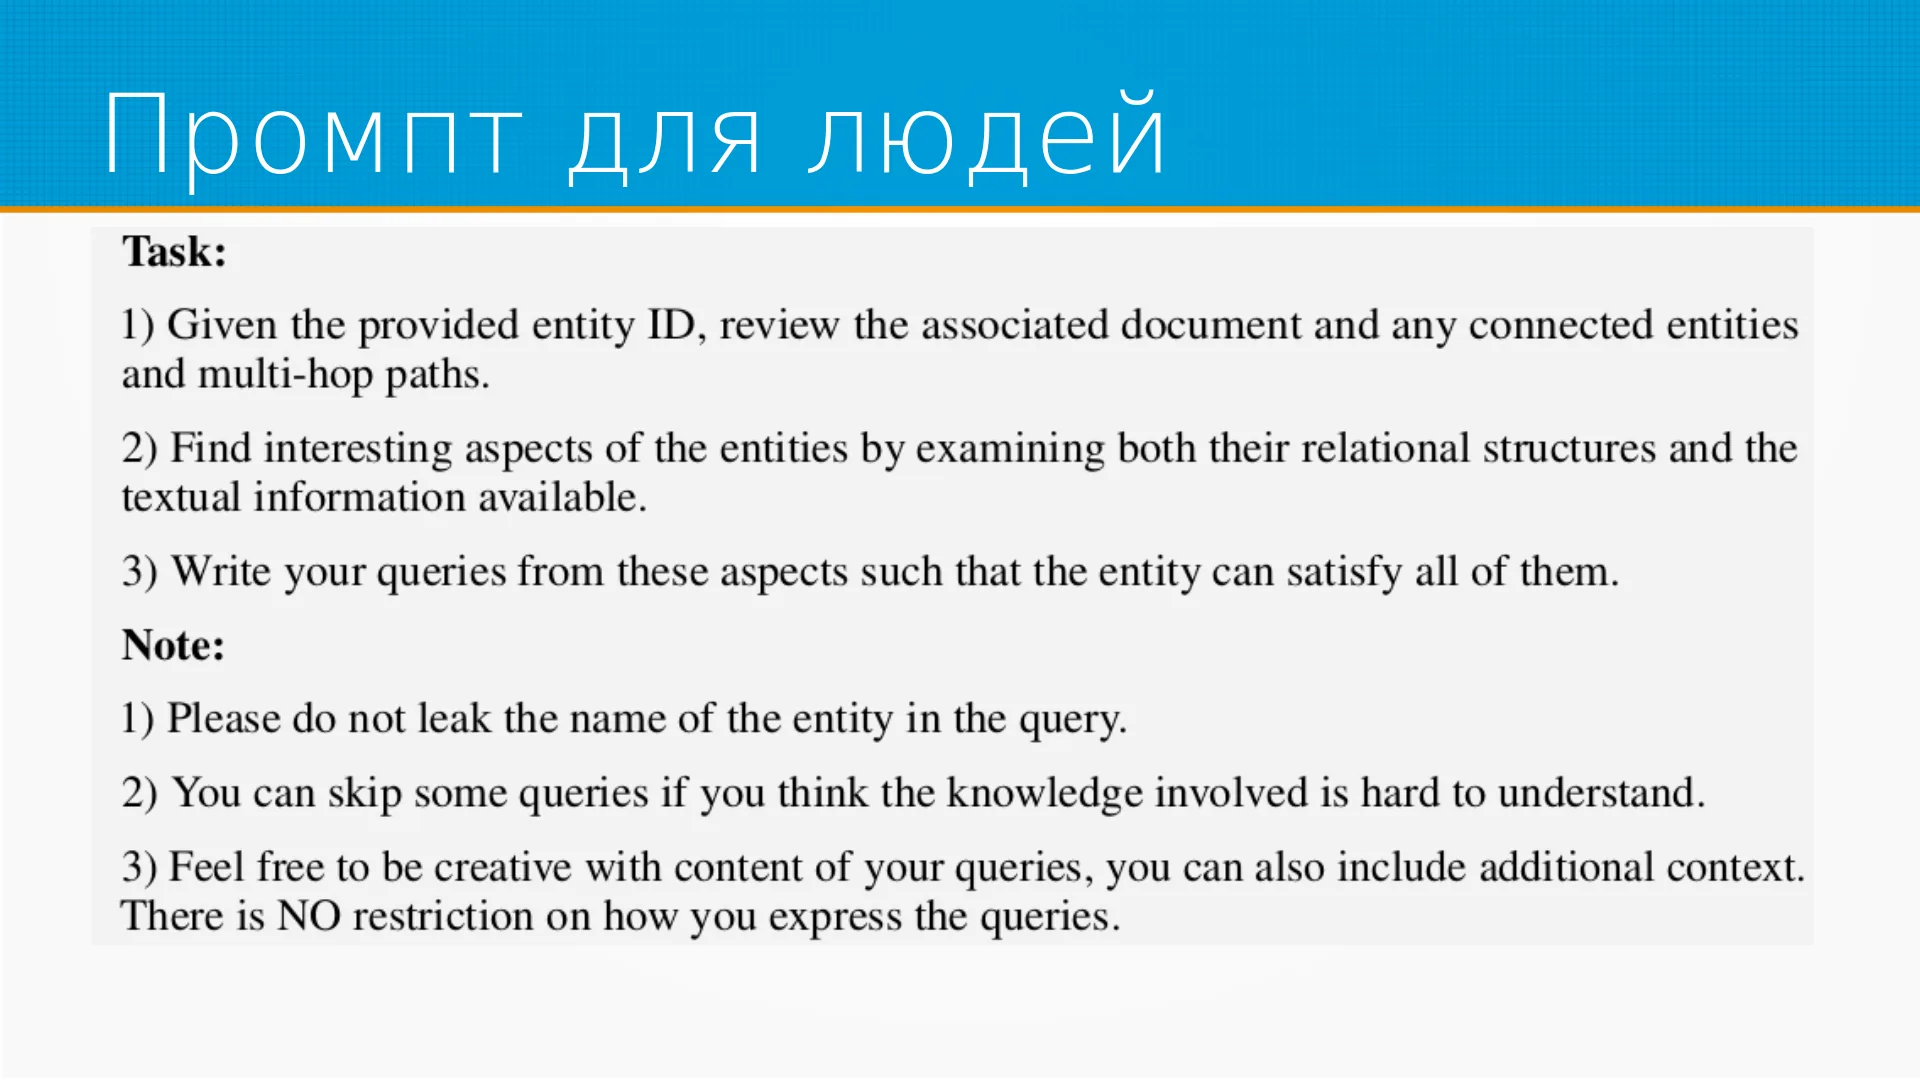
Людям давали вот такой промпт. И хочется тут отметить, что благодаря ЛЛМкам и необходимости писать для них промпт, мы наконец-то научимся хорошо ставить задачи людям. Вот, потому что тут подробно хорошо расписана задача для людей по генерации датасета. Возьмите случайно выбранный ID, посмотрите, с кем он ассоциирован в графе, там был инструмент для просмотра графа. Найдите интересные аспекты, напишите ваш запрос, который бы учитывал эти аспекты, так, чтобы эта сущность удовлетворяла этому запросу. Не вписывайте имя сущности в запрос. Вы можете некоторые запросы отпустить, если думаете, что они вообще не очень интересные. И можете что-нибудь изобретать. Ждите напалма.
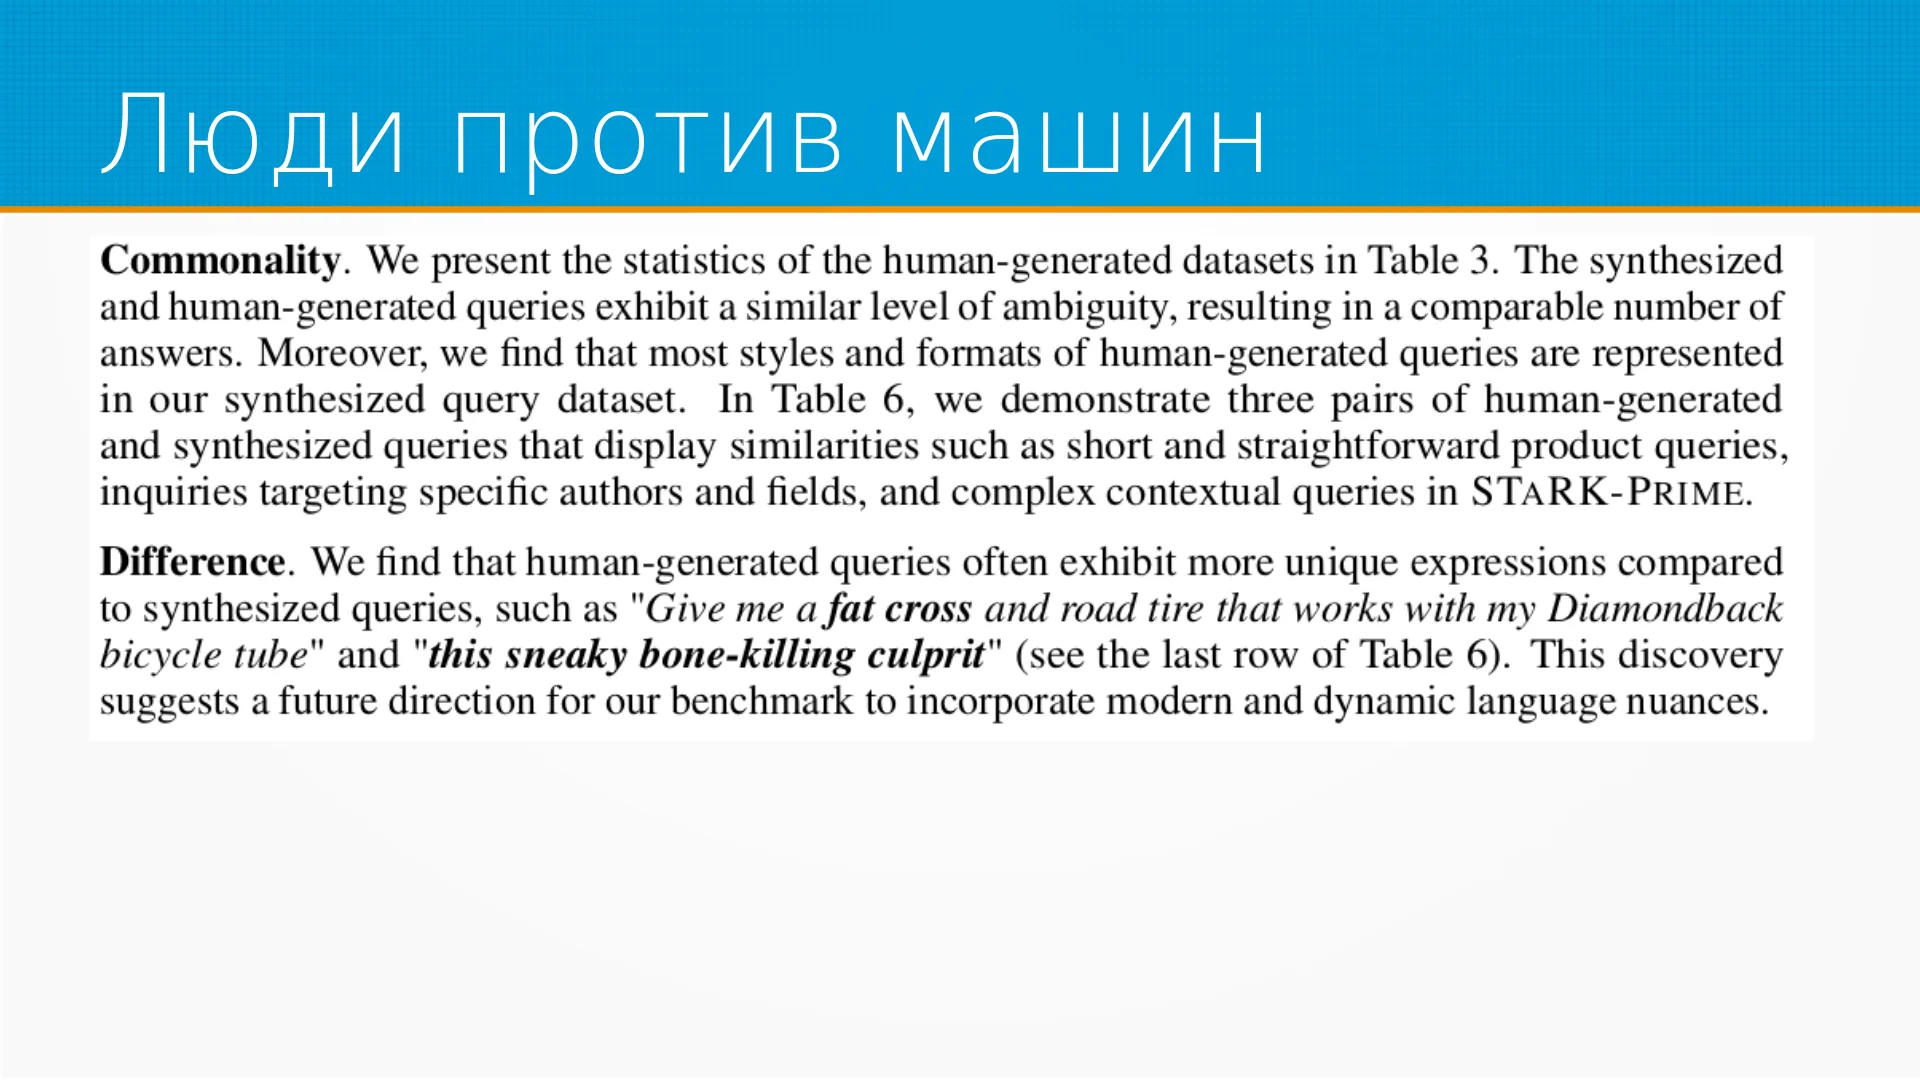
Сравнивали запросы, сгенерированные людьми, сгенерированные машинами. У людей получилось похоже. Единственное, что, а, люди гораздо более богато используют язык. Язык людей, он, а, разнообразнее и, я бы сказал, сочнее. Так-то, в общем запросы похожи и по длине, и по качеству.
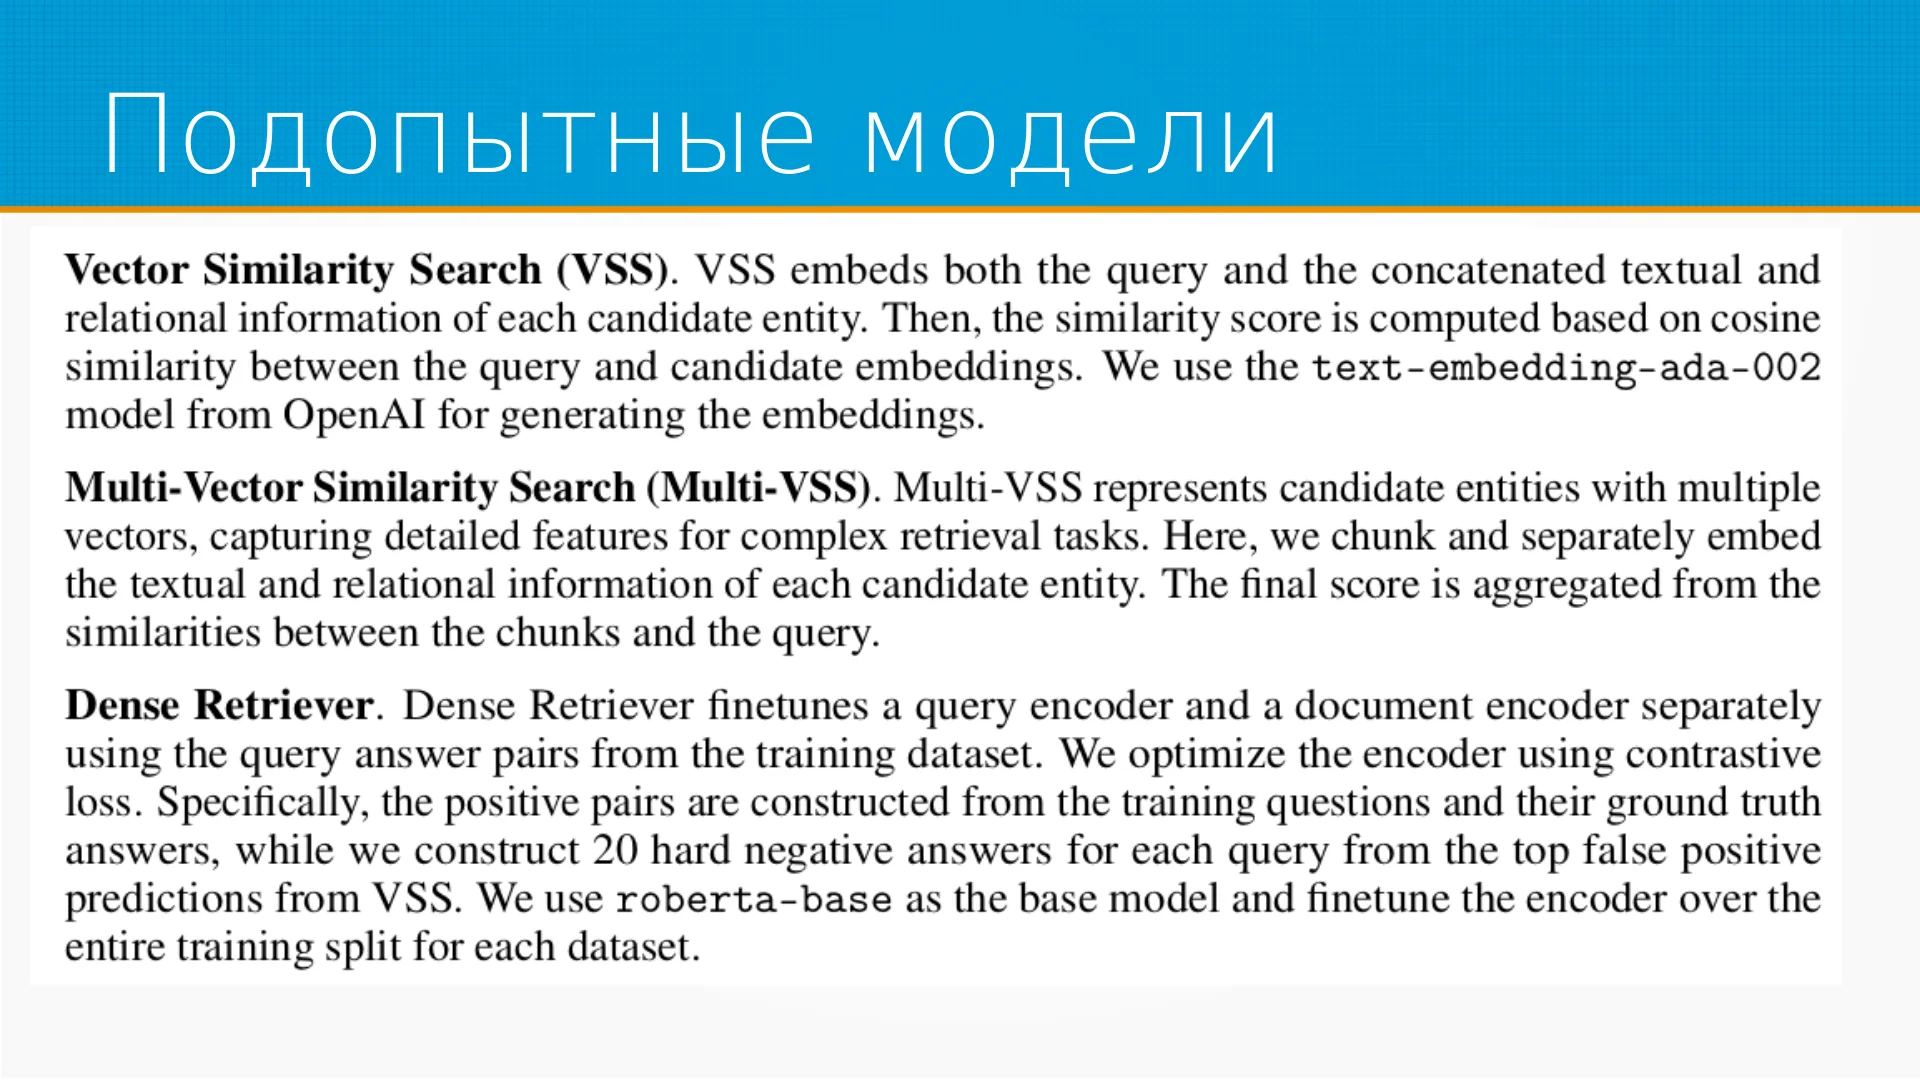
Для того, чтобы проверить, насколько хорошо на этих запросах, а, текущие, а, а, доступные любому грамотному инженеру модели ищут, они сделали пять моделей. Первый из них - это просто Vector Similarity Search. Мы берём, а, наше текстовое описание, берём, а, конкатенируем граф, делаем эмбеддинг, а, Chat GPT-2. Текст эмбеддинг Ada 002. И, а, потом просто по, а, векторной, а, по косинусной симилярити ищем, а, самые подходящие варианты. Несколько более сложная система Multi-VSS, а, режут текст на чанки, а, для каждого чанка считают эмбеддинг и, в общем, затем выполняют некоторый пуллинг. Например, находят самые подходящие чанки или средний эмбеддинг для чанков. Там, то есть, разные подходы.
Dense Retriever, они взяли Роберту. И Роберта была хуже всех, кстати. Обучили они Роберту. Роберта - это не вариант. Ещё они использовали, а, Question Answer GNN, то есть вопросно-ответную сетку на графах.
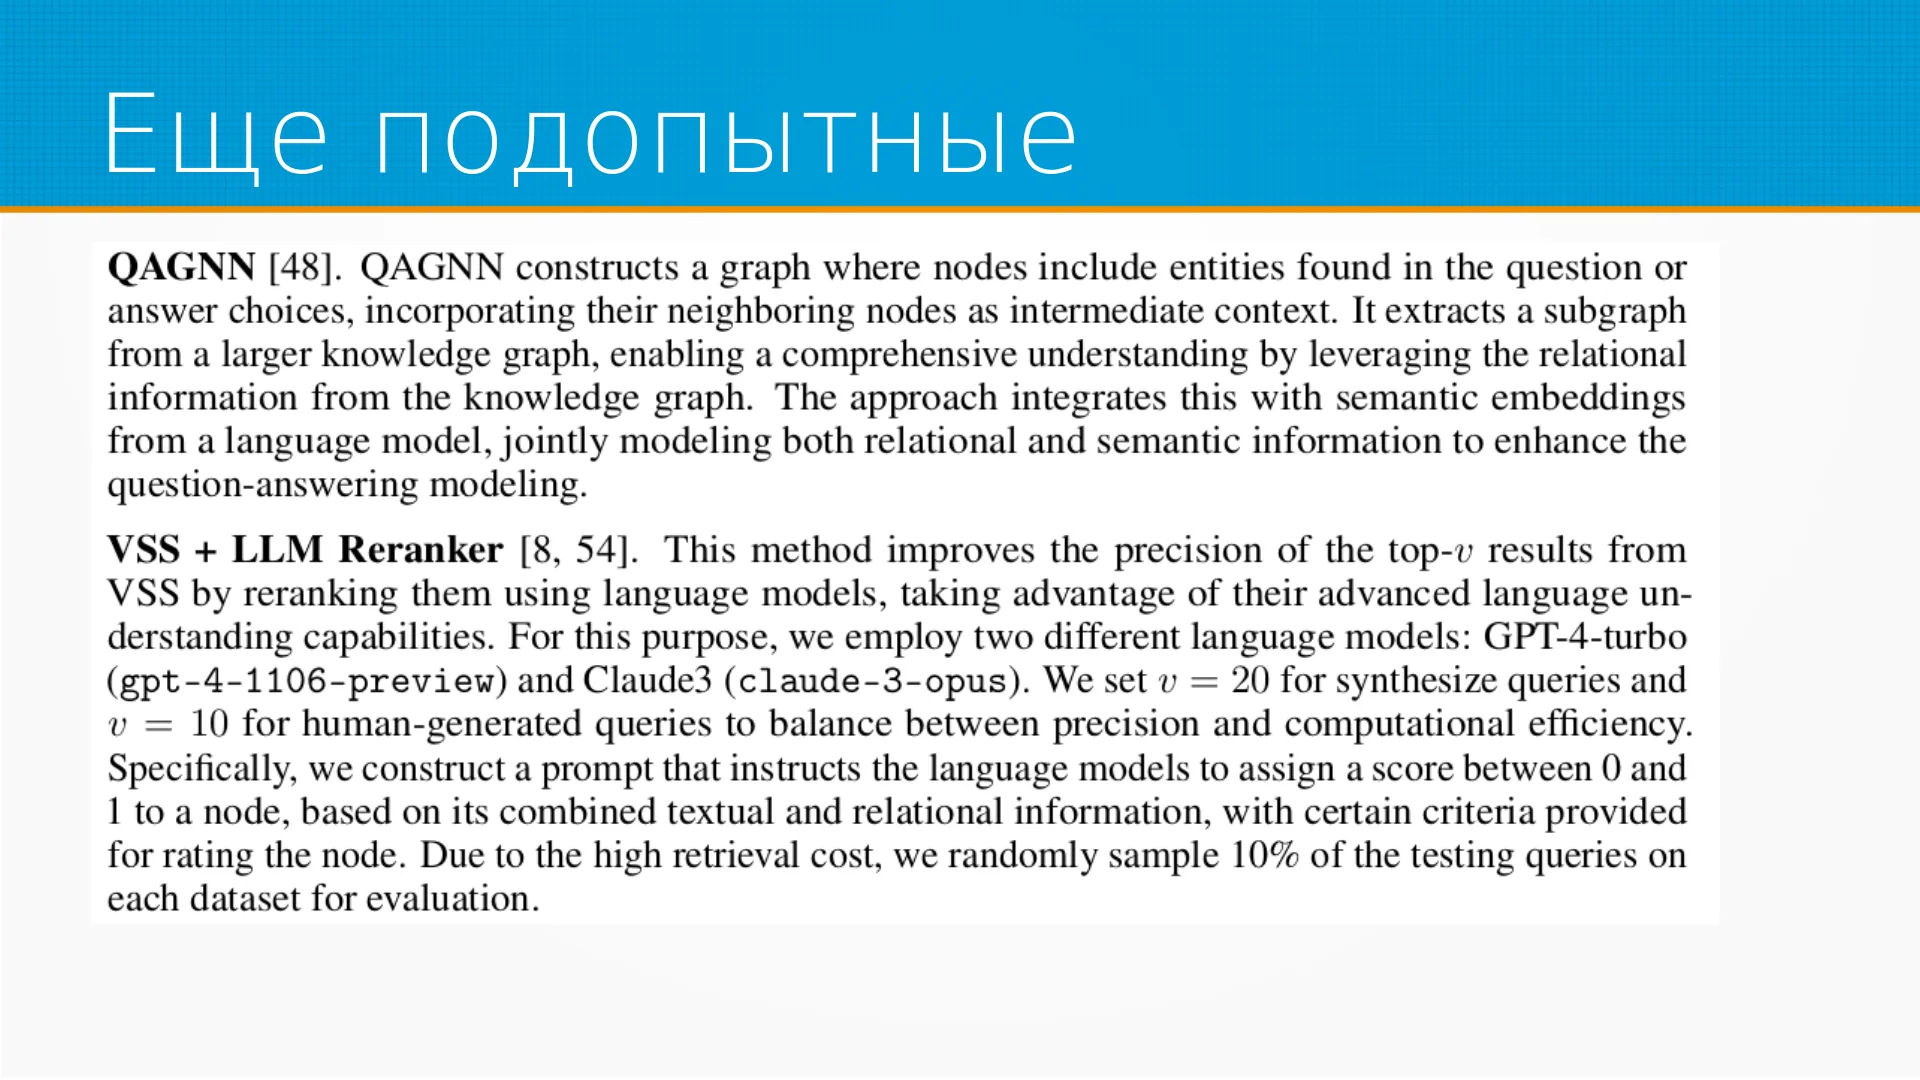
Работала она так себе. И лучше всего у них работал, работали модели с векторным поиском и переранжированием ЛЛМкой. Они сделали две модели переранжирования: одна на GPT-4 Turbo, а вторую на третьем клоде. И, в общем, а, единственная проблема была, что ЛЛМ реранкер работал медленно, поэтому они, а, на нём не все запросы прогоняли, а только 10%, потому что больно уж тупило.
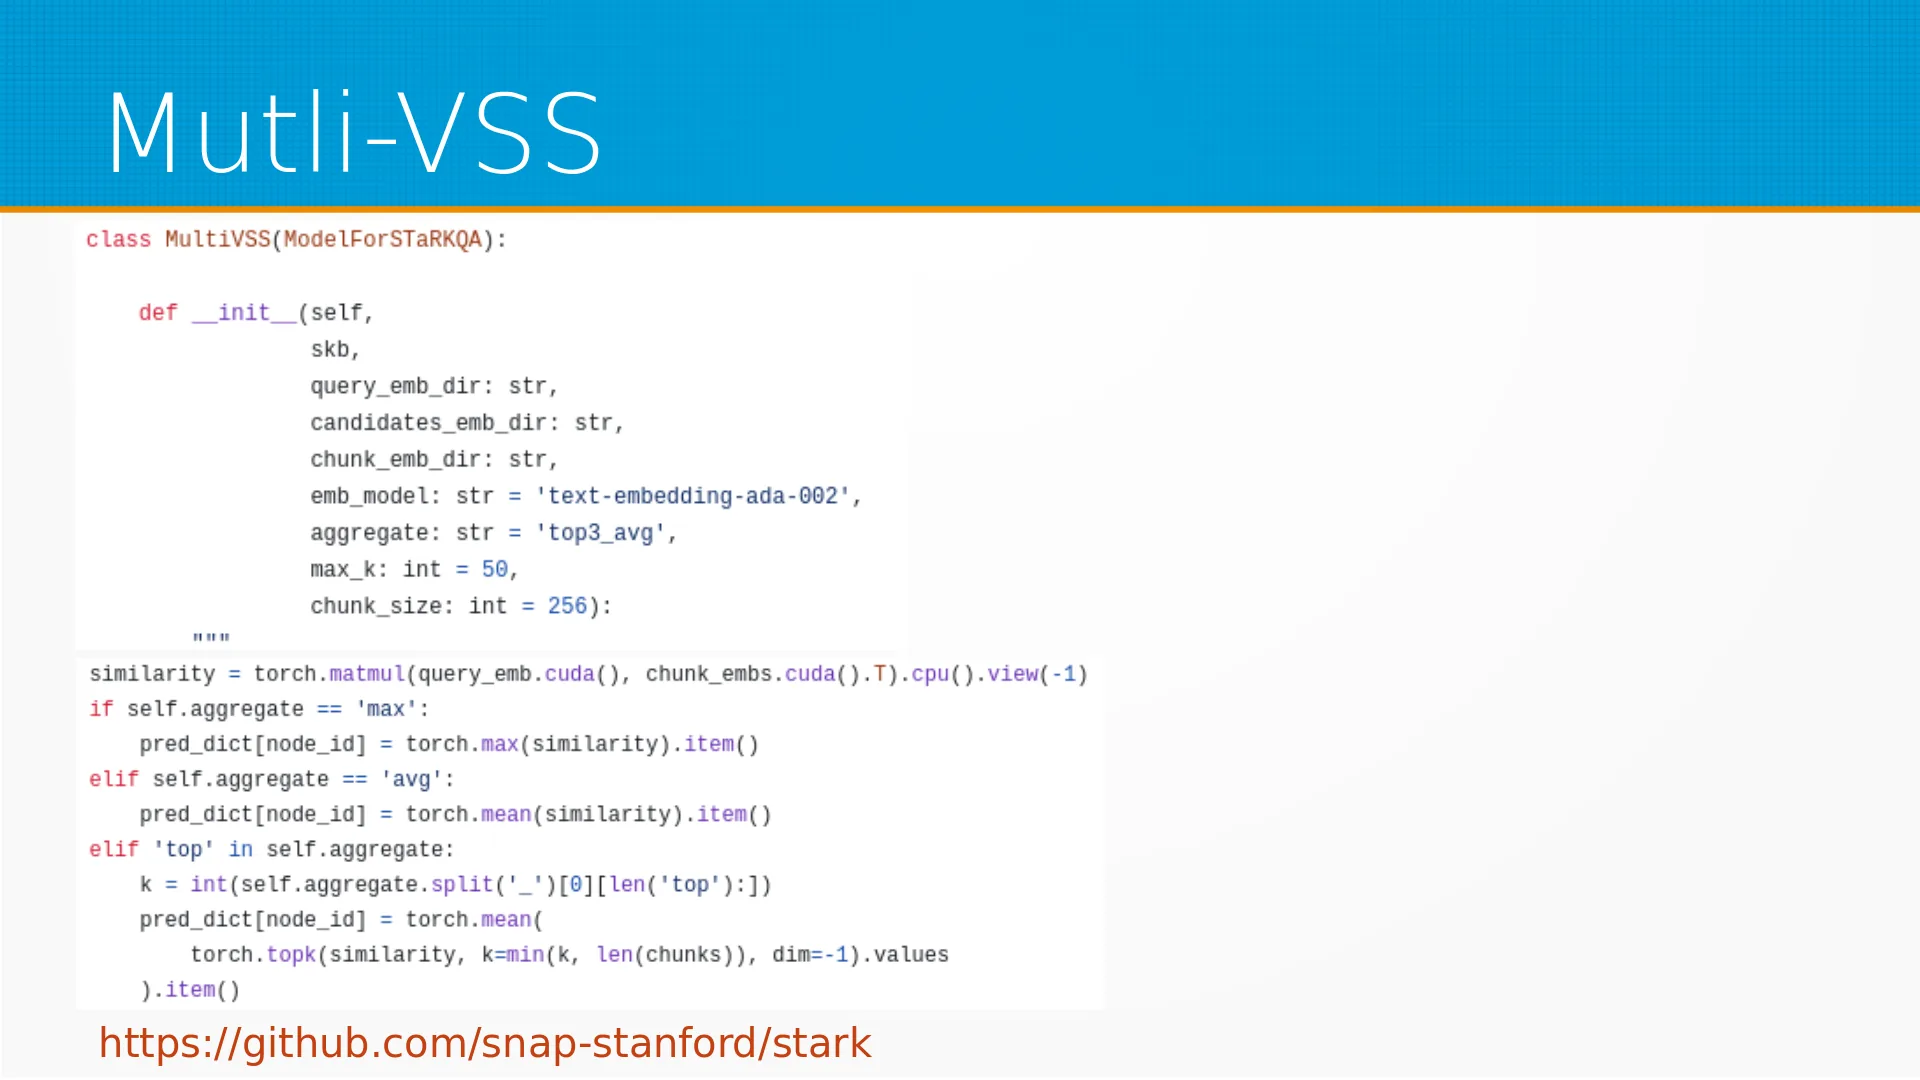
Мне самому стало интересно, как они делали Multi-VSS. Я полез в репозиторий, репозиторий есть с кодом. Они резали текст на чанки длиной в 256 токенов. Они брали не больше 50 этих самых чанков и делали эмбеддинги, опять же Ada 002. И агрегировали они интересно. Они смотрели все чанки поблизости к запросу, затем они находили три самых близких к запросу чанка и брали у них средний. Такая вот, в общем, хорошая, нормальная стратегия агрегирования.
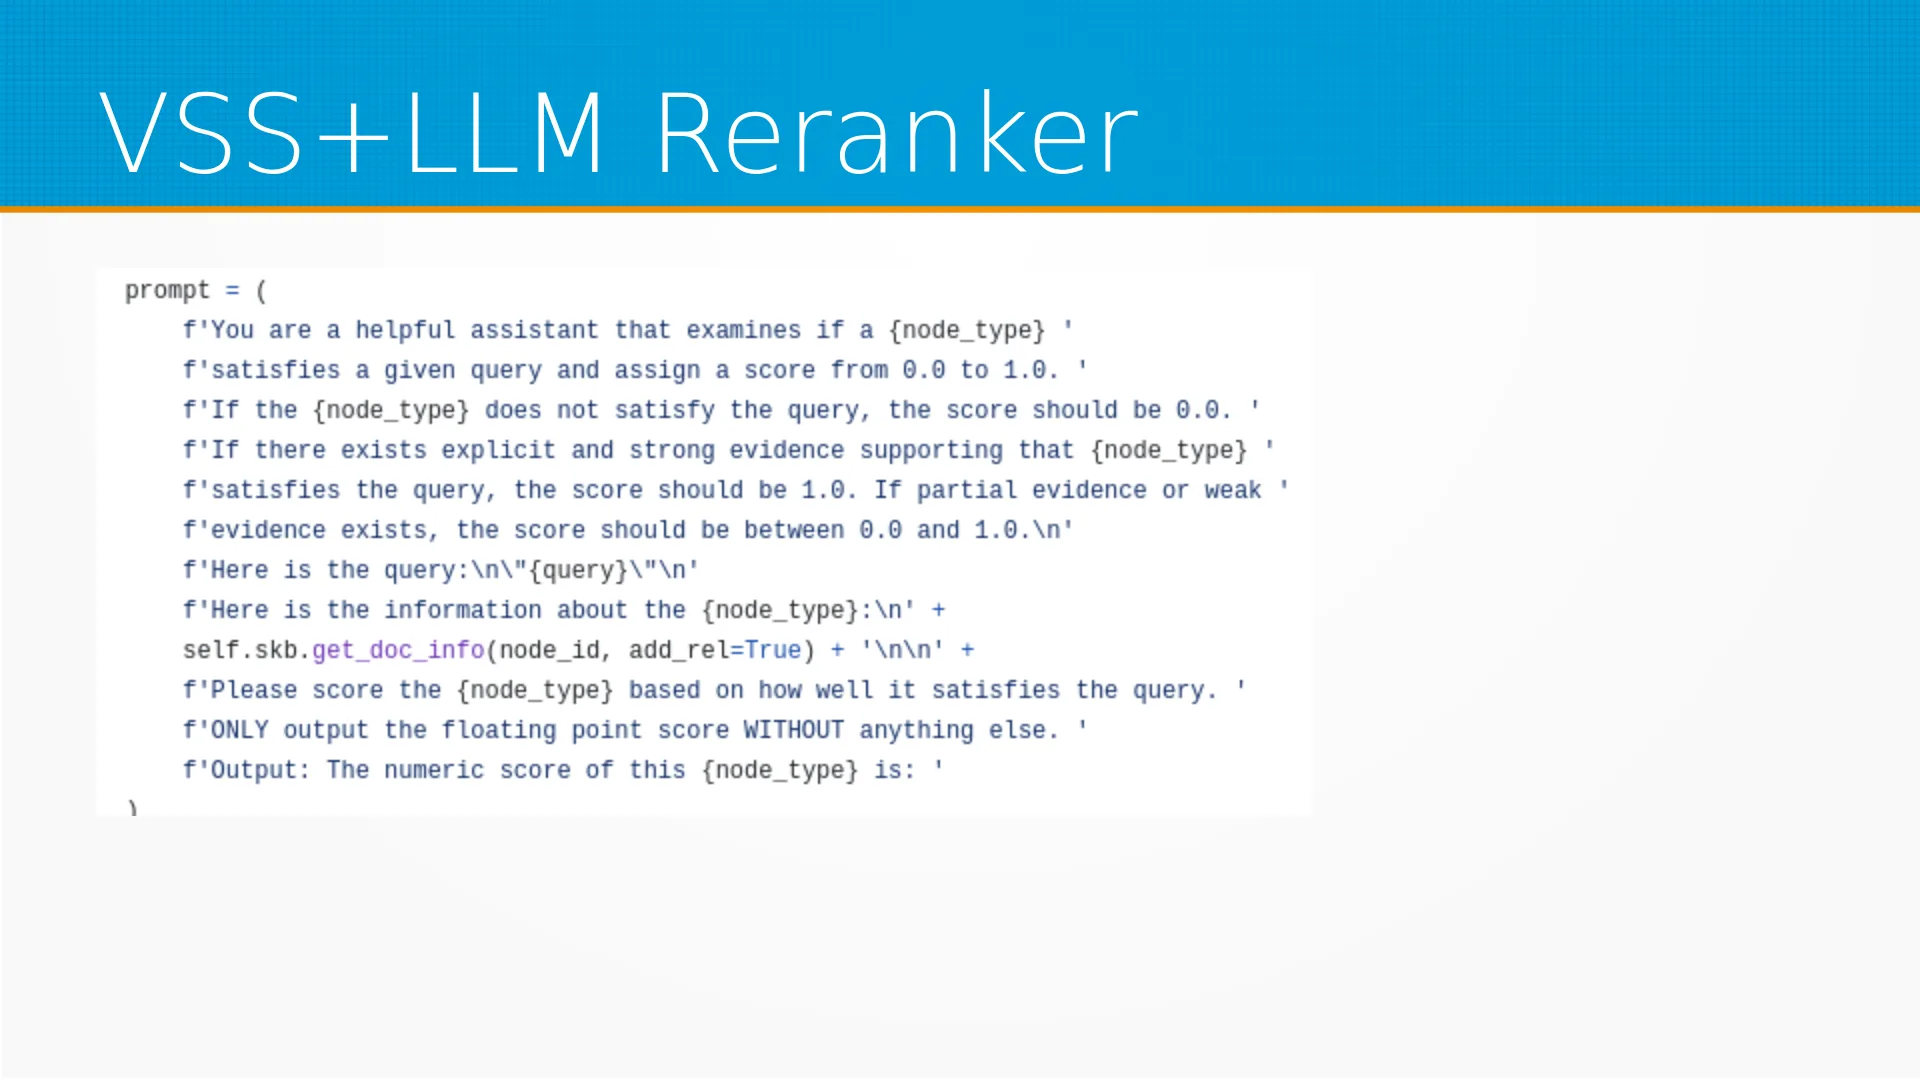
Переранжирование было тоже там никакого Rocket Science, то есть, они просто просили ЛЛМку оценить, а, насколько по шкале от нуля до единицы этот конкретный пример подходит под этот запрос. Удивительно, что такая несложная магия так хорошо работает. И что у них получилось?
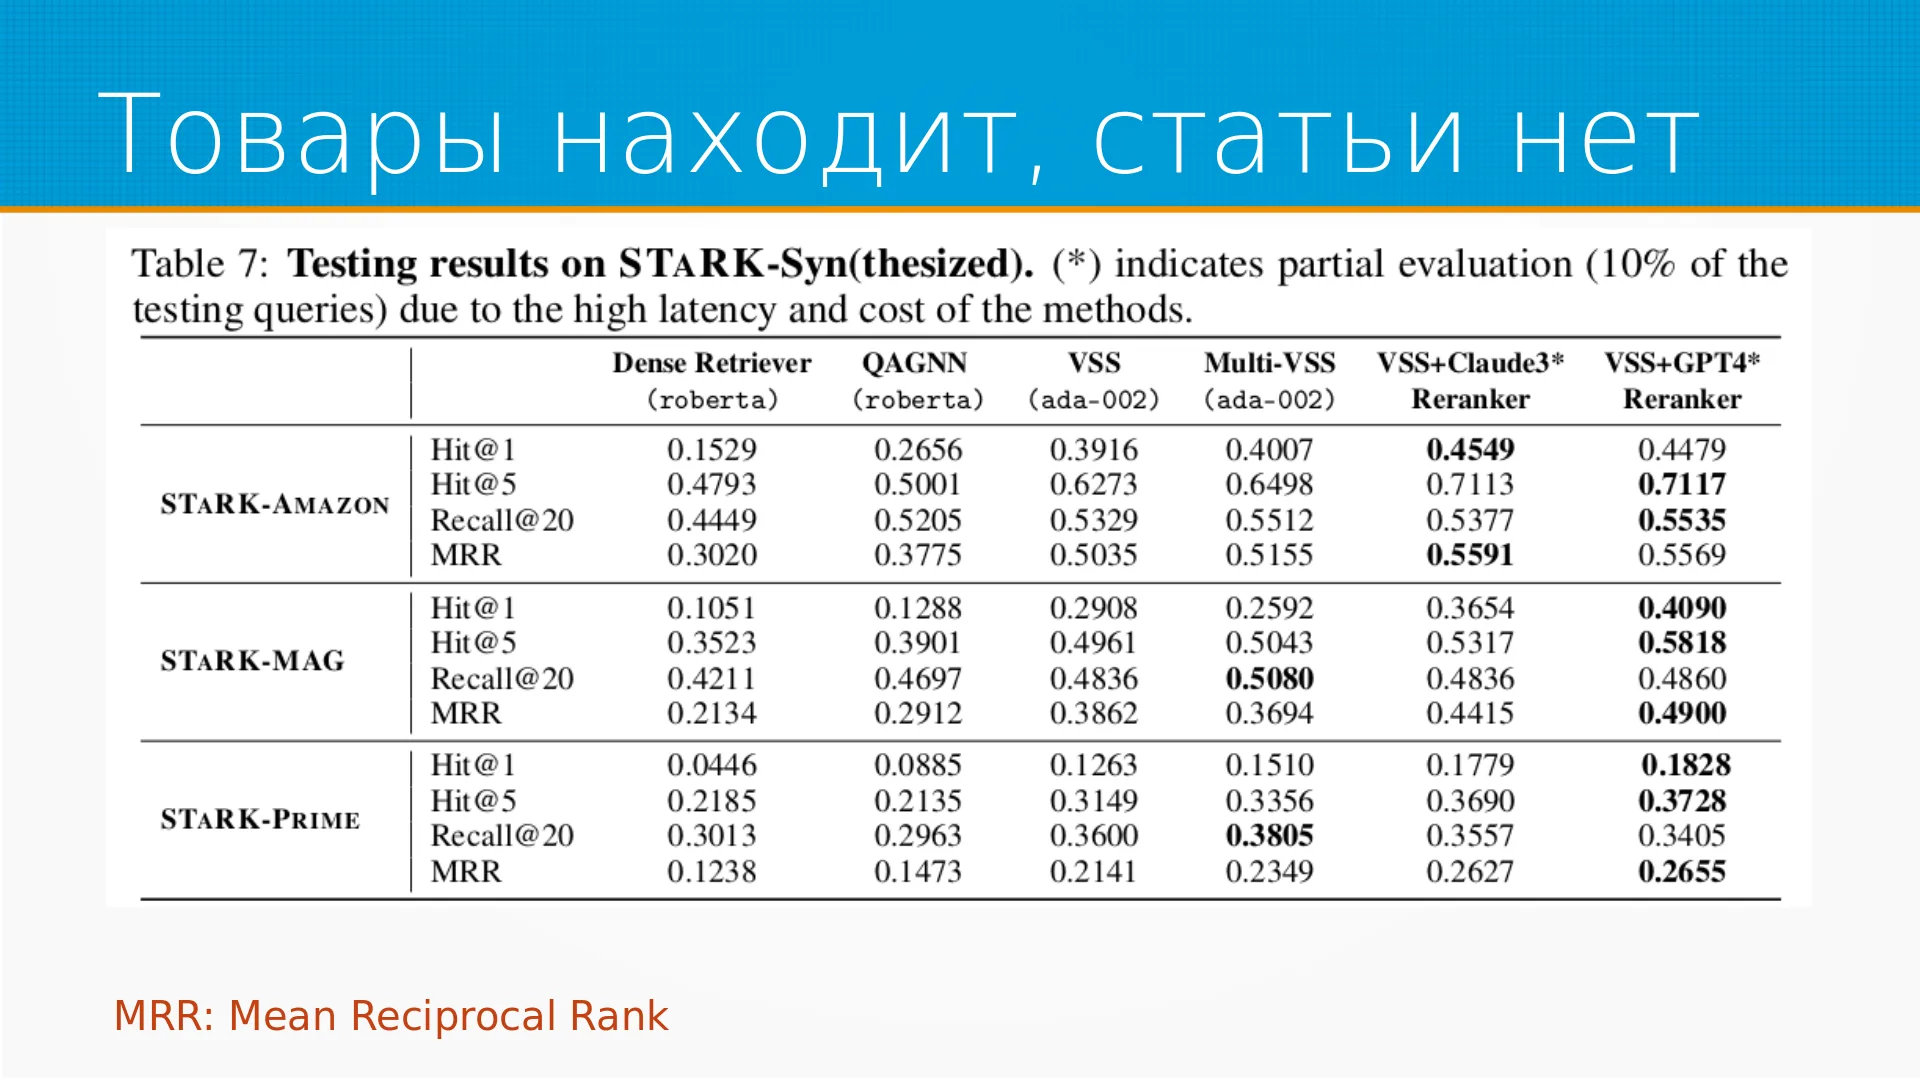
Они считали три метрики. Hit 1 и Hit 5 - это, а, находится ли их целевая сущность в топ-1 и в топ-5 результате. Также они считали Recall, поскольку там для некоторых вопросов было несколько вариантов ответа, то можно было считать Recall 20. И они считали MRR это, грубо говоря, обратный средний ранг. Когда он равен, например, а, 0,3, это значит, что в среднем примерно на третьей позиции у нас, а, находилось нужное нам значение. И мы видим, что Роберто работает примерно никак. QAGNN работает тоже так себе. Векторный поиск работает неплохо, особенно на товарных, на товарном поиске, потому что, а, скорее всего товарные описания их много было при обучении самих эмбеддингов.
Эту саму доменную область эмбеддер видел, и он её хорошо понимал, в отличие от там, скажем, точной медицины и научных статей. Multi-VSS всегда работает лучше, чем просто VSS. Почти всегда реранкер работает лучше, чем Multi-VSS, но на самом-то деле отрыв не очень большой. Я бы так сказал, что почти всегда нет смысла заморачиваться, если глядя в эту таблицу, учитывая, что тут на порядок медленнее работает с реранкером, что Multi-VSS, то есть, порезать на чанки и смотреть, а, на косинус симилярити, в общем, вполне рабочая стратегия оказалась.
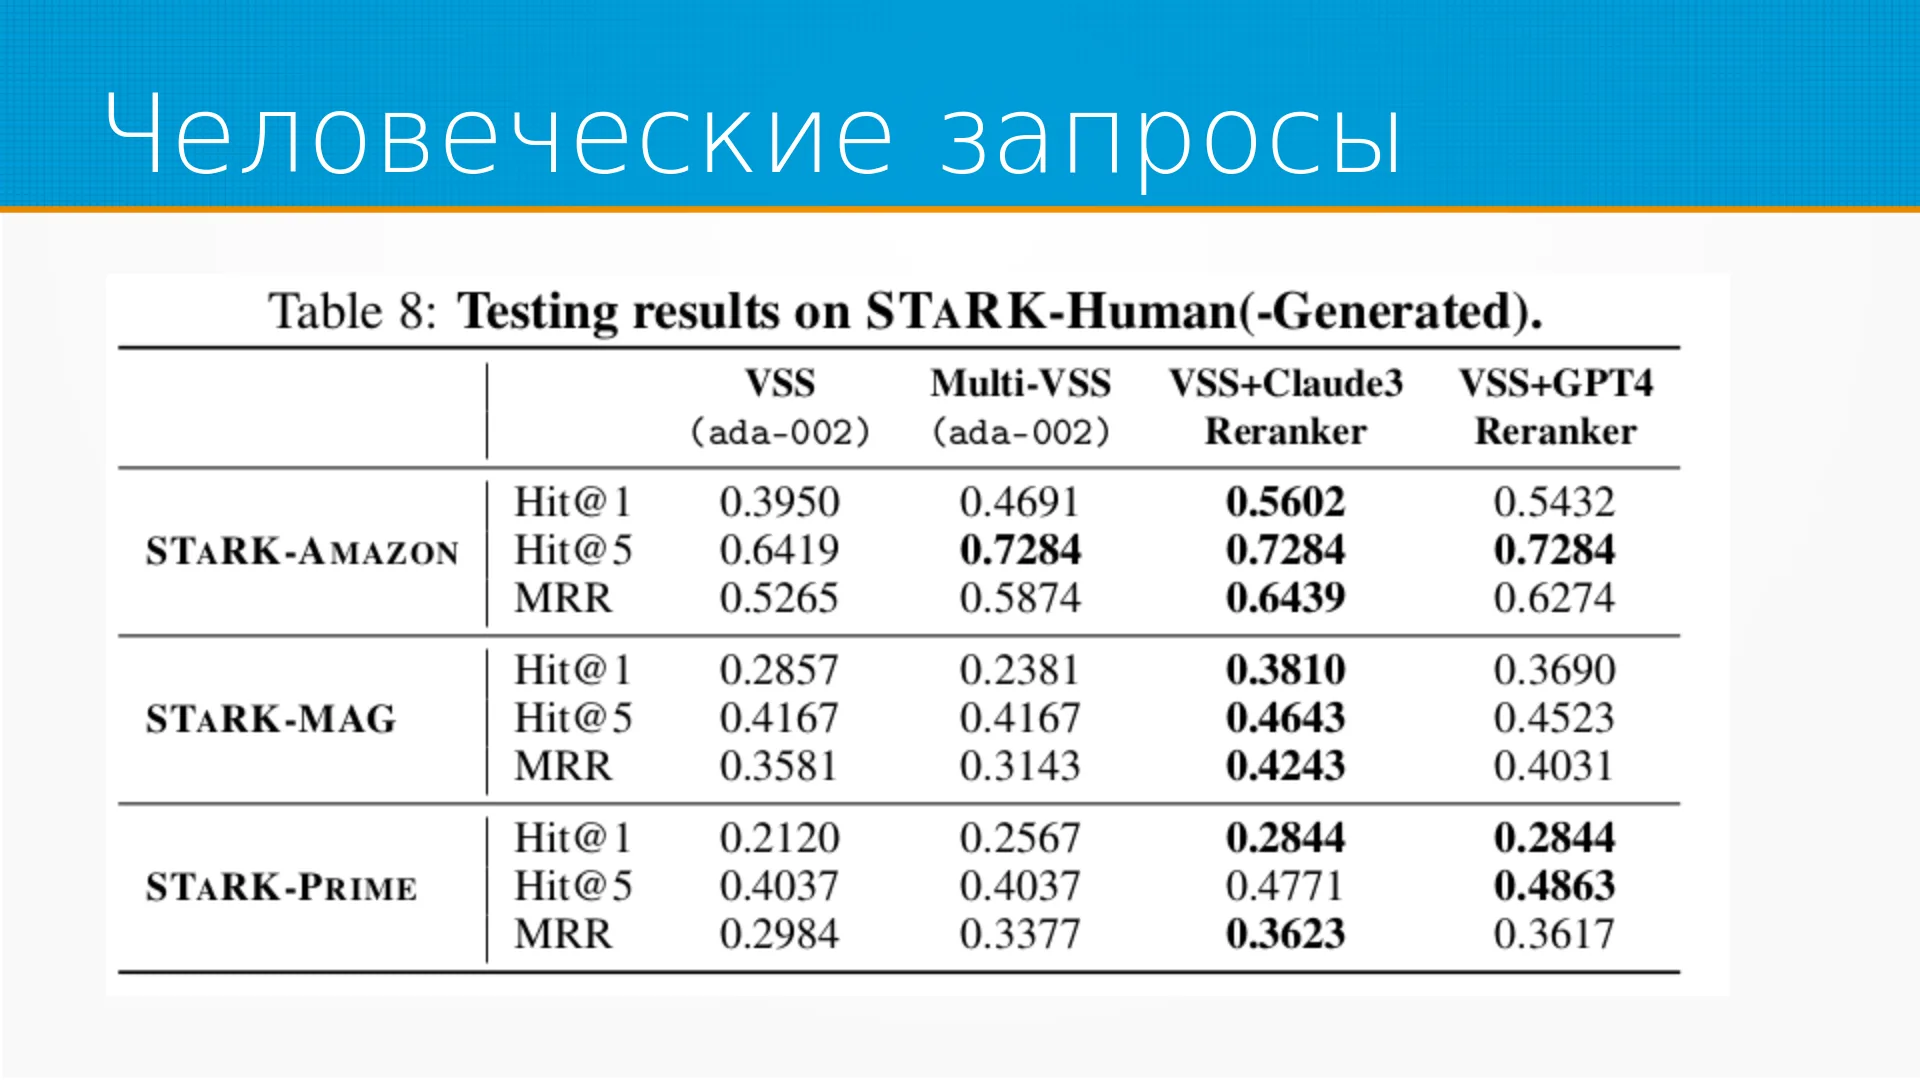
Что с человеческими запросами? С человеческими запросами, а, качество похожее. Оно чуть-чуть получше. Эмбеддеры ну, и вообще эти поисковики, они ищут лучше в текстах, которые написал человек, чем в текстах, которые написала машина. Но сами по себе результаты коррелируют. Они говорят: "Ну, мы об этом подумаем, может быть, что-нибудь сможем сделать".
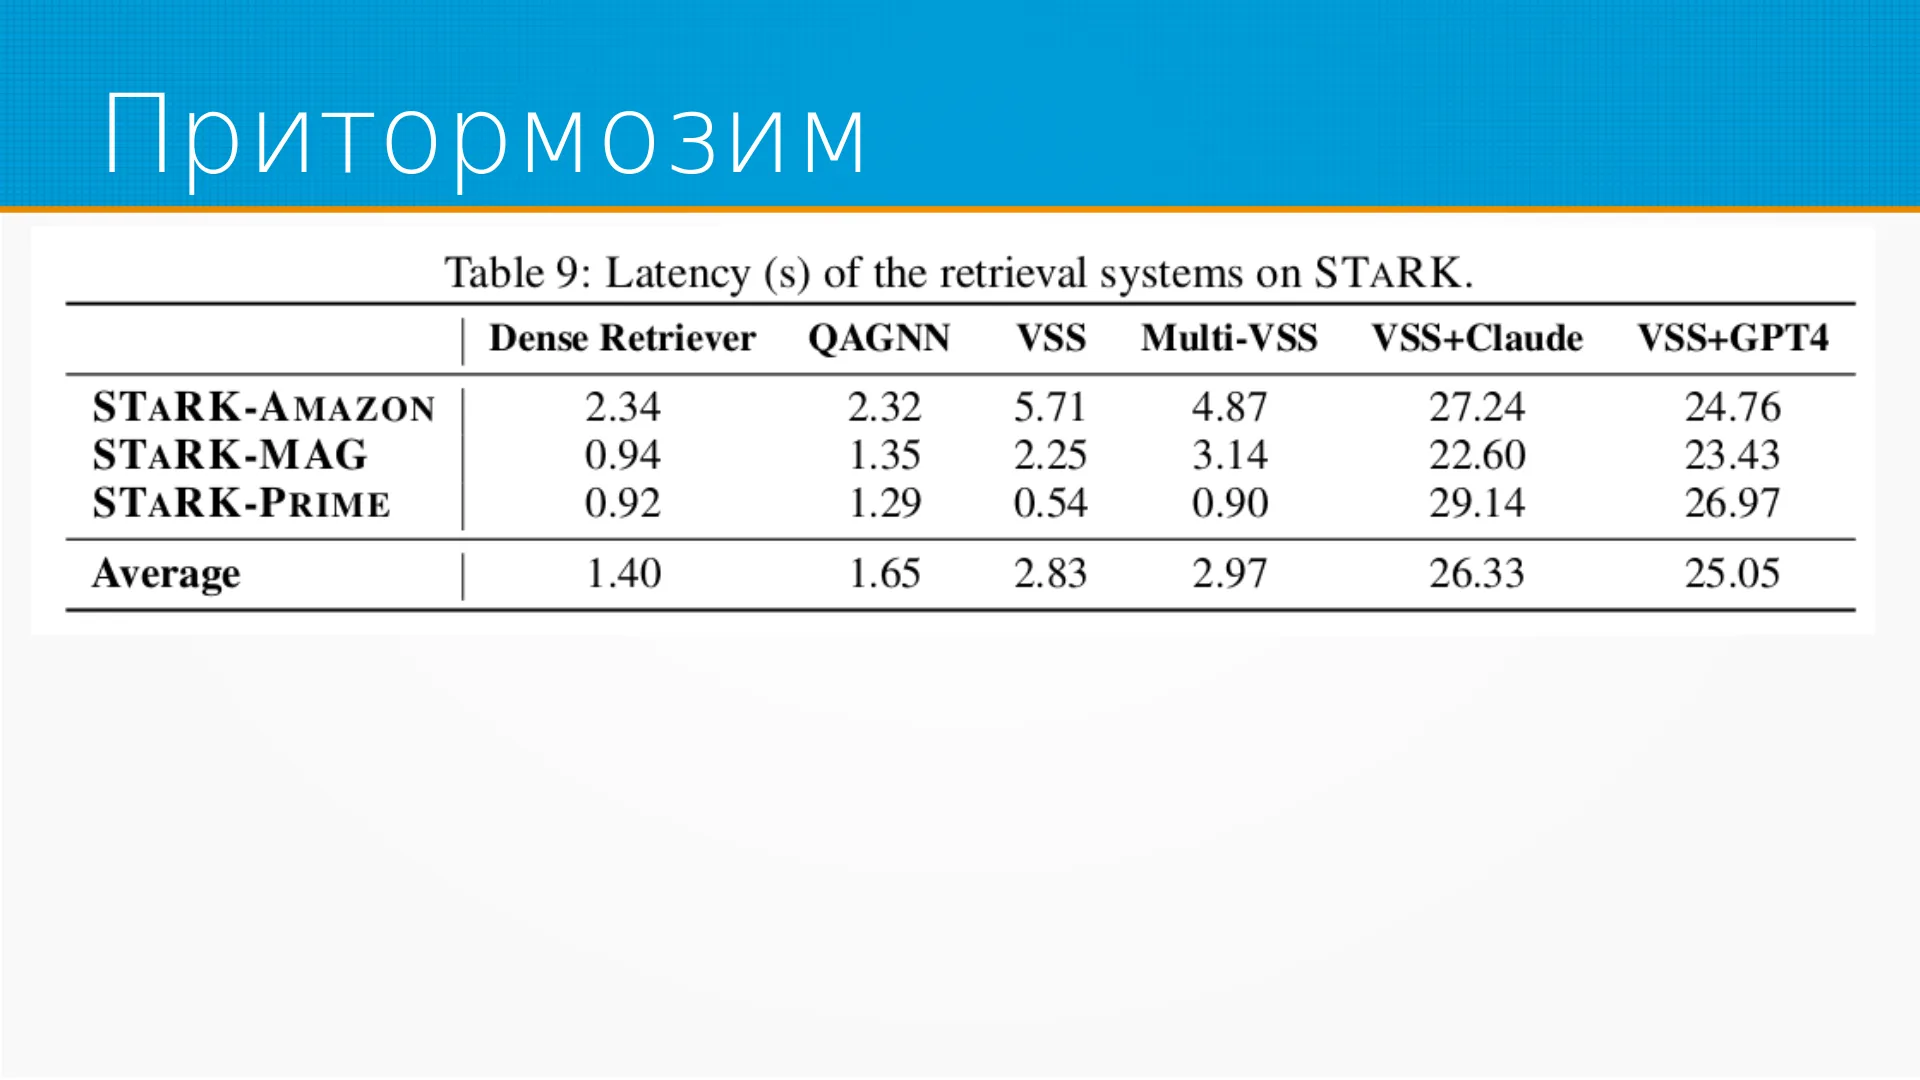
Реранкер работает очень медленно, а, а VSS и Multi-VSS, в общем, так у них живенько работало.
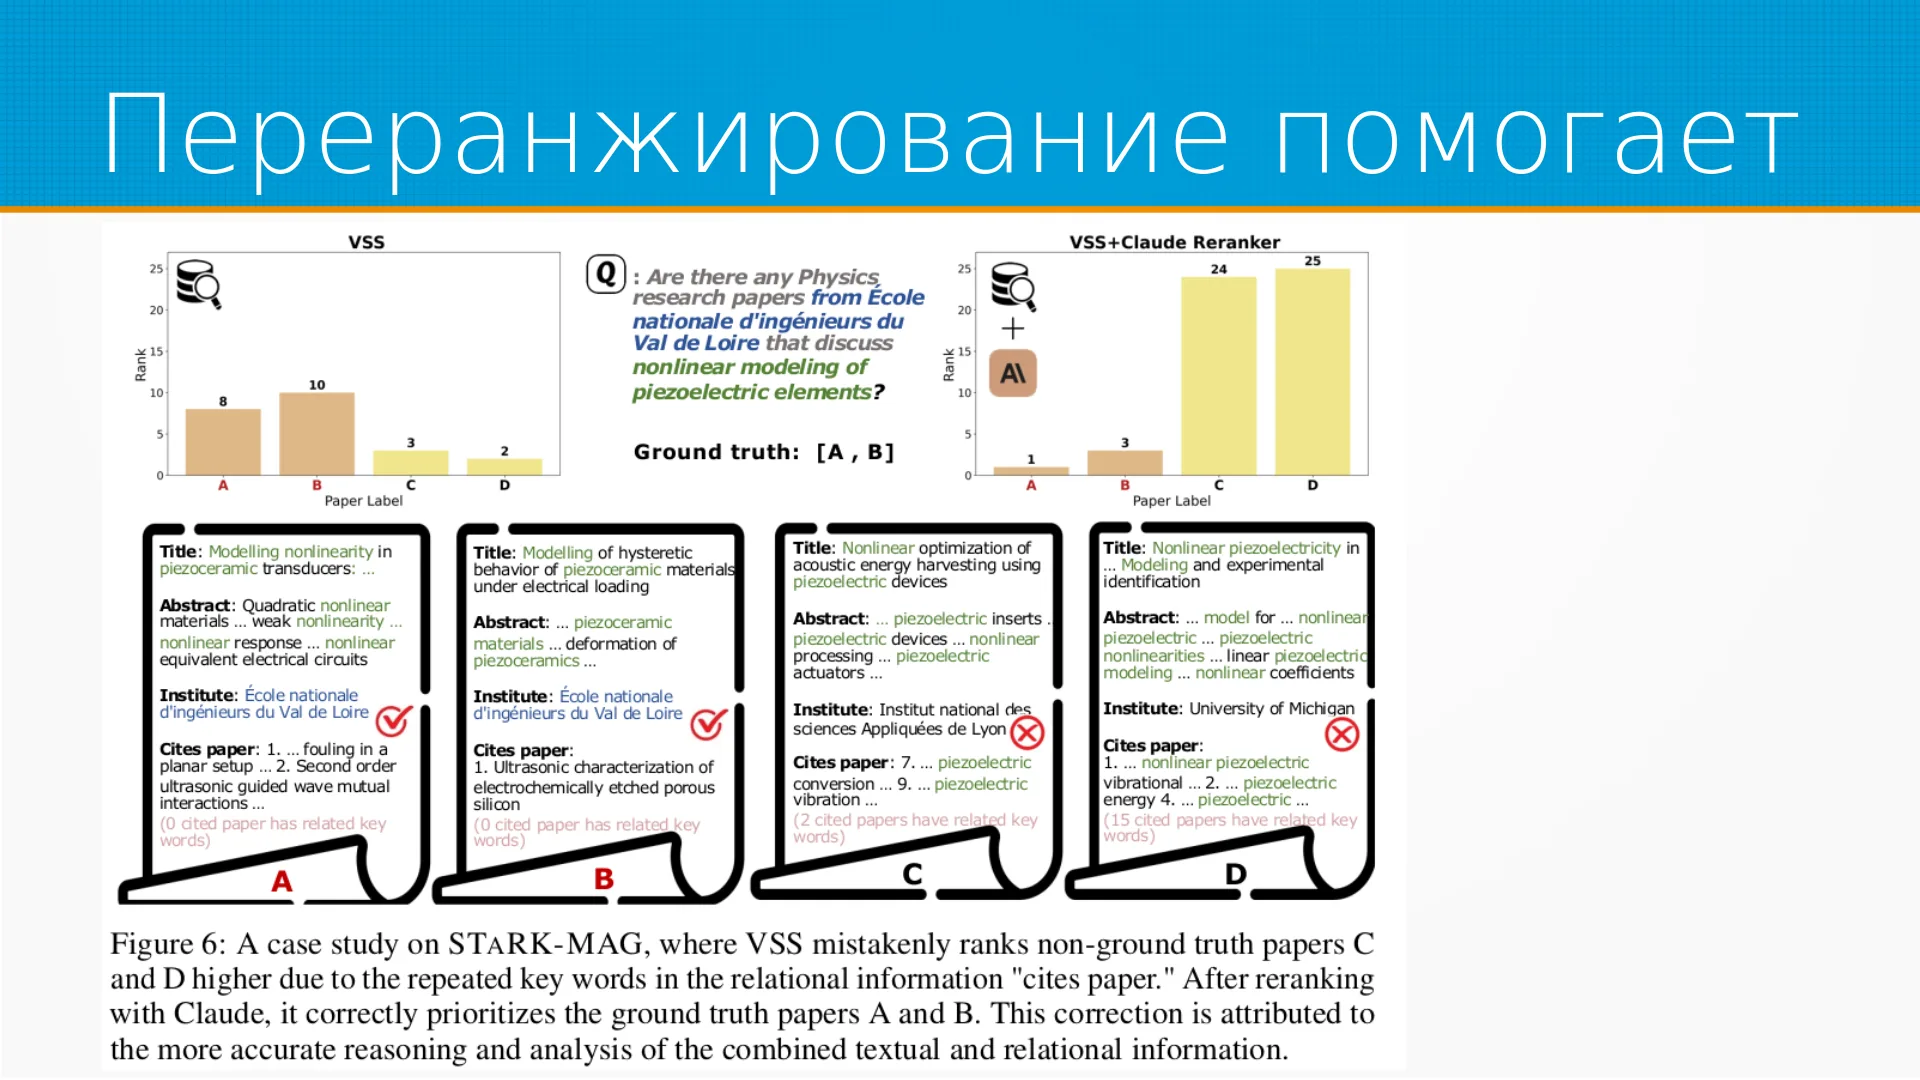
Переранжирование реально помогало у них. Они делали анализ ошибок. Они брали примеры, которые плохо находились векторным поиском, и смотрели, что же происходило при переранжировании. Переранжирование реально вытаскивало, а, примеры в правильном порядке. И вообще, так оно в жизни обычно и бывает, потому что векторный поиск обычно - это не про упорядочить, по моему опыту, это про отобрать шорт-лист, который ты дальше будешь как-нибудь переранжировать. Здесь они посмотрели. И в итоге что получилось? Они говорят, что вот, мы сделали STaRK бенчмарк который позволяет оценивать то, как с помощью ЛЛМк мы можем искать в полуструктурированных базах знаний.
Но я вижу эту статью немножко по-другому. На самом-то деле, они предложили хороший фреймворк для генерации Тестовых и обучающих датасетов на ваших данных.
Дмитрий: Если у вас есть текстовые данные и графы. На самом деле это большая проблема, а именно делать хорошую синтетику. То, что они сделали датасет, на котором у них их поиск не работает бог им судья. Вот то, что у них прямо хороший по шагам, надёжный и удобный в отладке способ генерировать датасеты, а из полуструктурированных данных, вот тут они молодцы. Они же предложили методики оценки качества этих данных и, в общем, хорошо отбрасывают неоднозначности, это прямо клёво. Вот у меня всё.
Ведущий: Спасибо большое. Если есть у кого-нибудь вопросы, то можно задать вслух или написать в чат. Пока думают, я спрошу.
Дмитрий: Угу.
Ведущий: В итоге они, а, граф сэмплировали только из графа товаров?
Дмитрий: Нет, нет, нет, у них для каждого датасета были графы. Вот здесь. И они сэмплировали граф товаров, по нему делали, сэмплировали граф вот этих вот Журнал публикаций научных из него и сэмплировали граф по вот этой структурной биологии.
Ведущий: Для каждого датасета свой граф был?
Дмитрий: Да, да, для каждого датасета был свой граф.
Ведущий: Ага. Тексты они хранили как вектора? Или они не использовали как бы тексты?
Дмитрий: Почему же? Они тексты использовали, но использовали их во-первых, как вектора, они их использовали. На самом деле они и граф как вектора использовали в векторном поиске. Во-вторых, они их как тексты использовали при переранжировании. Когда они делали переранжирование вот это вот, вот здесь вот. То они давали тексты, графы, говорят, что вот у нас есть вот такой вот такой у нас узел, так вот описанный, и подходит ли он под этот запрос, пожалуйста, оцени.
Ведущий: Угу. Может, у меня уже вечер чуть-чуть. Ещё для уточнения. В итоге что они хотят на Выход? Что они с чем оценивают, сравнивают?
Дмитрий: Они смотрят, насколько хорошо, то есть вообще они хотели сделать бенчмарк для оценки работы retrieval систем с LLM-ками на полуструктурированных данных.
Ведущий: Угу.
Дмитрий: Вот, чтобы можно было эти самые системы сравнивать и отлаживать. И, а, чтобы показать пример, как это, как этот бенчмарк считать, да, то есть, как оценивается. Они взяли, сделали четыре простых поисковых системы, таких незамысловатых. Четыре-пять, да, пять систем. И, а, каждый из них прошлись. По своему датасету и получилось, что ищут они плохо. Так, если вкратце.
Ведущий: Угу.
Дмитрий: Вот, то есть они говорят, нам бы что-нибудь надо покруче. На мой вкус, на самом-то деле не так и плохо ищет векторный поиск с реранкером. Опять же, они не сделали совершенно напрашивающуюся вещь, то есть у них вот есть а, векторный поиск целиком по тексту, векторный поиск по чанкам, по нарезанным, да, как вообще-то обычно и делают.
Ведущий: Угу.
Дмитрий: И дальше они сделали реранкер поверх векторного поиска. Вообще-то говоря, напрашивается реранкер поверх мульти-VSS вот этого, то есть порезанного на чанки. И качество должно было бы быть лучше. Почему они этого не сделали, непонятно. Как бы, всё есть, то есть одной строчкой в коде это делается.
Ведущий: Ищут они в итоге чанки или узлы в графе?
Дмитрий: Ищут узлы.
Ведущий: Узлы.
Дмитрий: Узлы. Да, и метрика у них как раз information retrieval классические.
Ведущий: Ага.
Дмитрий: Поисковые метрики.
Ведущий: Ага, а тексты просто для реранкера используют в таком случае?
Дмитрий: Да, тексты для реранкера используют. Ещё, конечно, напрашивался бы поиск с помощью какого-нибудь BM25 сюда в сравнение.
Ведущий: Угу.
Дмитрий: И кажется, что он был бы очень неплох. Вот, но они опять же этого не сделали. Код есть, можно повторить. Код там простой, хорошо читаемый.
Ведущий: Угу. Интересно.
Ведущий: Интересно. У меня ещё такой философский, может, туповатый вопрос. Насколько вообще можно доверять системам, которые под собой под капотом полностью сделаны на LLM-ках? Я смотрю, здесь LLM-ки тут помогали, там помогали, а в итоге мы же это тоже будем использовать для оценки LLM-ок.
Дмитрий: Это вообще крендец, если честно. Сегодня на дата-завтраке рассказывали про стартап, у которого есть совершенно шедевральные варианты, то есть, например, берётся а, презентация и по ней делается обучающий курс в несколько разделов. Просто LLM-ками пишется. И как бы я вот на этот уроборос смотрю, то есть и не понимаю, как им, в общем, всем не страшно, да? Вот, то есть мне давно страшно. Потому что LLM-ки учатся на текстах, которые сгенерировали LLM-ки, сейчас в интернете других текстов-то и нету уже почти.
Ведущий: Угу.
Дмитрий: Поэтому а, как бы возникает интересная мысль, а если мы LLM-ки будем учить на своём собственном выходе, к чему она сойдётся? Мы скоро узнаем.
Ведущий: Угу.
Дмитрий: Буквально через несколько лет.
Ведущий: Как раз вопрос, что страшного для вас?
Дмитрий: Что страшного для меня? Всё-таки, а, хотелось бы, а тут есть же такая штука, что когда, а, появился Google и Яндекс, люди, во-первых, а, быстро научились писать поисковые запросы, то есть они изменили способ Думать, да, то есть человеку нужно что-нибудь спросить у Гугла или у Яндекса, и он это переформулирует в некоторый промт, то есть промты начали писать не сейчас, а 20 лет назад, когда поисковики появились в широком доступе, да? Во-вторых, люди и мыслить стали чуть-чуть по-другому. Когда появились, например, роботы, которые общаются в чате, роботы, которые отзваниваются и так далее и тому подобное, а люди же стали говорить друг другу фразами из вот этих вот скриптов обзвонов.
Сейчас это, наверное, уже трудно отследить, я просто помню, как это появилось, это было, наверное, лет 10 назад, когда, а, у моих знакомых, у моей мамы там, например, да, появились какие-то фразочки, которые, а, я до этого слышал только в скриптах обзвонов. Вот эти вот языковые модели не только они учатся на наших текстах, но ведь наши дети на их этих текстах учатся. Есть куча образовательных стартапов, где студентов учит языковая модель, да? И, а, есть опять же а, наблюдение, а, Юрия Кашницкого, что, если я правильно помню автора наблюдения, что, а, хороший, мм, а, ровный, яркий текст - это сейчас такая же вот, а, роскошь.
Это писали руками, а не LLM-кой, да? Как вот есть фабричная еда, которую мы покупаем в столовой, есть там, скажем, бабушкин суп. Есть целое поколение, которое просто не готовит и питается фабричной едой, и вообще не видит в этом ничего странного, то есть люди от 35 лет и младше многие, особенно если у них дома детей нет, то они так и делают. Но вот мы к тому же самому приходим и с том, на чём основана наша цивилизация с языком. Вот, с текстом. Вот, это ответ на вопрос, почему мне немножко страшновато. С другой стороны, я уже старенький, умру, всего этого не увижу.
Поэтому
Ведущий: Вот меня в этом контексте удивляет, что довольно, как мне показалось, может, это у меня такое ощущение возникло, довольно мало ручной валидации проведено.
Дмитрий: Почему же мало? Они целых 274 запроса руками. Сделали. Это, поверьте мне больше, чем обычно делают при генерации данных синтетики с помощью ЛМК. Я в последнее время насмотрелся, что ЛМками просто генерируют датасеты, на которых учат модели же, да, и потом разводят руками, почему так плохо получилось. Это просто общий подход. Очень дорого датасеты брать. И опять же, видите, мы раньше брали датасеты из людей, которые сами-то не учились на ЛМках, и теперь, когда люди учатся на ЛМках, мы фактически берём это то же самое, только немножко немножко так вот
Из зала: С другого ракурса.
Дмитрий: С другого ракурса. Но есть ещё оптимизм в ту тему, что есть разная языковая среда, то есть есть английские ЛМки, есть русские ЛМки, и до тех пор, пока мы все говорим на разных языках, мы будем друг друга обогащать, и, в общем, всё будет хорошо. Вообще ЛМки хорошо генерируют данные синтетику. Они действительно хорошо генерируют данные. Если посмотреть на то, какие запросы здесь были сгенерированы, да, вот, то вот эти вот синтезированные запросы, они очень похожи на то, как люди действительно формулируют вопросы. Правда, похожи.
Из зала: Угу. Я на это тоже обратила внимание.
Дмитрий: И с точки зрения людей, которые генерируют датасеты ЛМками, они, в общем у них естественные аргументы, что он же работает. Причём хорошо работает.
Из зала: Да. Интуитивно кажется, что где-то это чуть-чуть нечестно.
Дмитрий: Да, кажется, что тут есть какая-то подколка, но не очень понятно, какая.
Из зала: Угу.
Из зала: Так.
Дмитрий: Это всё к философам, я инженер.
Ведущий: У кого-нибудь ещё есть вопросы или комментарии?
Из зала: У меня такой вопрос немножко, немножко к статье, немножко нет. Получается, вот ну не знаю, просто, может быть, мне нет спросить. Сегодня просто встретила статью, которая оценивает, насколько разнообразные вот варианты генерации кода от ну, от ЛМки. И здесь они как-то вообще примерно оценивают, насколько похоже, то есть нужны ли им тут разнообразные данные или они какие-то однотипные получаются, и как-то это может сломать вообще всё.
Дмитрий: Вот они оценивали. We find that human queries often exhibit more unique expressions. Они говорят, что да нам нужно больше золота, там, нам нужно в наш наш бенчмарк добавить больше современного и динамичных языковых нюансов. По-русски говоря, поднять температурку у модельки. Всё. В наше время добавить языковых нюансов. Есть же непрекращающиеся попытки написать детектор, допустим текста. И там отметились все. Например АИРИ отметился тем, что они говорят: "А давайте мы топологию текста изучим, да?" То есть, идеи мы любим туда прикрутим. Первые попытки достаточно успешные в начале были: "А давайте мы посмотрим на то, как распределены слова, то есть, насколько равномерно или неравномерно, что у людей неравномерно выбрасываются слова, а у модельки равномерно". Всё это вот, на самом деле, корректировкой температуры решается.
По имеющейся у меня информации, фиг отличишь хорошо сгенерированный текст от плохо написанного. Единственное, что всё это, конечно, справедливо для английского. И почему мне эта статья ещё понравилась, потому что датасетов-то на русском не очень много, и их приходится генерировать, и качество их оставляет желать. Тут хороший такой пайплайн генерации датасетов, если у вас есть граф. Граф обычно есть.
Из зала: Когда как.
Дмитрий: Не, ну вот в моём мире, там, где в мире товарных каталогов и так далее, граф есть.
Из зала: Да.
Дмитрий: В мире научных статей граф есть.
Из зала: Интересно, что они от Википедии отходят, от графа Википедии.
Дмитрий: Они вот этот вот тезис, который я тут озвучил, они, на самом деле, его не сказали. Они так про него проехали чуть-чуть, что вот, все используют отношения из Википедии.
Дмитрий: Вот, но ведь действительно, если посмотреть, отношения из Википедии, они неявно в языке уже есть. Если у вас просто достаточно большой языковой корпус, большинство отношений из Википедии есть в нём внутри. С данными корпоративными, они обычно структурированы по-другому. Там есть какой-нибудь свой смысл, какая-нибудь своя точка зрения, какой-нибудь свой сленг, какая-нибудь своя добыча или что-нибудь ещё в смысле, какой-нибудь устоявшееся словоупотребление. И добыча мазута. И вы на Википедии не получите универсального графа. Всё равно он в каждой области чуть-чуть свой.
Из зала: Угу.
Дмитрий: И получается, что если мы делаем поиск по графу из Википедии, мы, на самом деле, читерим. Модель уже видела эти отношения, просто не в виде графа, а в виде текстовых утверждений. Тут тут мы заставляем её работать. Мы говорим: "А вот предположим, что в тексте вот этих отношений нет, которые есть в графе. Попробуй-ка ты всё равно их использовать".
Из зала: Интересно.
Дмитрий: И получается фигово, да.
Из зала: Вообще такой интересный тезис, он мне впервые попался, что они становятся бесполезными в этом мире.
Дмитрий: Вот, вообще, а вот у этой Гермионы, у неё куча именно работ по графам.
Из зала: Угу.
Дмитрий: Вот хороших прямо. Я вот статью разбирал и понял, что часть из них я потом сам тоже ещё раз поразбираю. Прямо прикольные. Я даже не думал, что кто-то так серьёзно и хорошо, интересно занимается графами знаний и поиском.
Из зала: Интересно.
Дмитрий: Вот, да. И у Юры, конечно, лаба огонь. Чего уж там. Я посмотрел на работы всех этих детей, прямо вот. Честное слово, любая была бы гордилась бы любым из первых шести вот этих детей.
Из зала: Угу.
Дмитрий: Вот, а они у неё там все. И у неё ещё есть, кроме них. Так.
Ведущий: Так. Кажется, что, наверное, нет больше вопросов. Но я думаю, что если что, всегда можно задать в чате, пообщаться.
Дмитрий: Да, я всегда тут. Ладно.
Ведущий: Спасибо вам большое за доклад. Всем спасибо, что подключились. Всем хорошего вечера тогда.
Из зала: Хорошего вечера.