В Open Data Science лаборатории прочитал лекцию про регулярные выражения в Python.
Регулярные выражения - швейцарский нож для обработки текста. Примеры, решаемые регулярными выражениями:
- проверка текста на совпадение с маской
- поиск текста по шаблону (извлечение всех адресов электронной почты из текста документа)
- подготовка текста (замена и удаление спецсимволов)
- анонимизация (замена телефонов, номеров кредитных карт, IP-адресов и email)
- токенизация (разбиение на токены)
- разбор строк по шаблонам
- простое извлечение фактов (построение признаков)
Обновленные слайды можно скачать тут regex.pdf
Текстовая расшифровка доклада (автоматическая, еще не вычитана):
Дмитрий: Ага. Презентацию видно же, да?
Из зала: Да, да, всё хорошо.
Дмитрий: Ага. Сколько-то, я не знаю сколько. Я не вижу сколько отсюда, у меня не видно отсюда. Так вот, а, лекция про регулярные выражения.
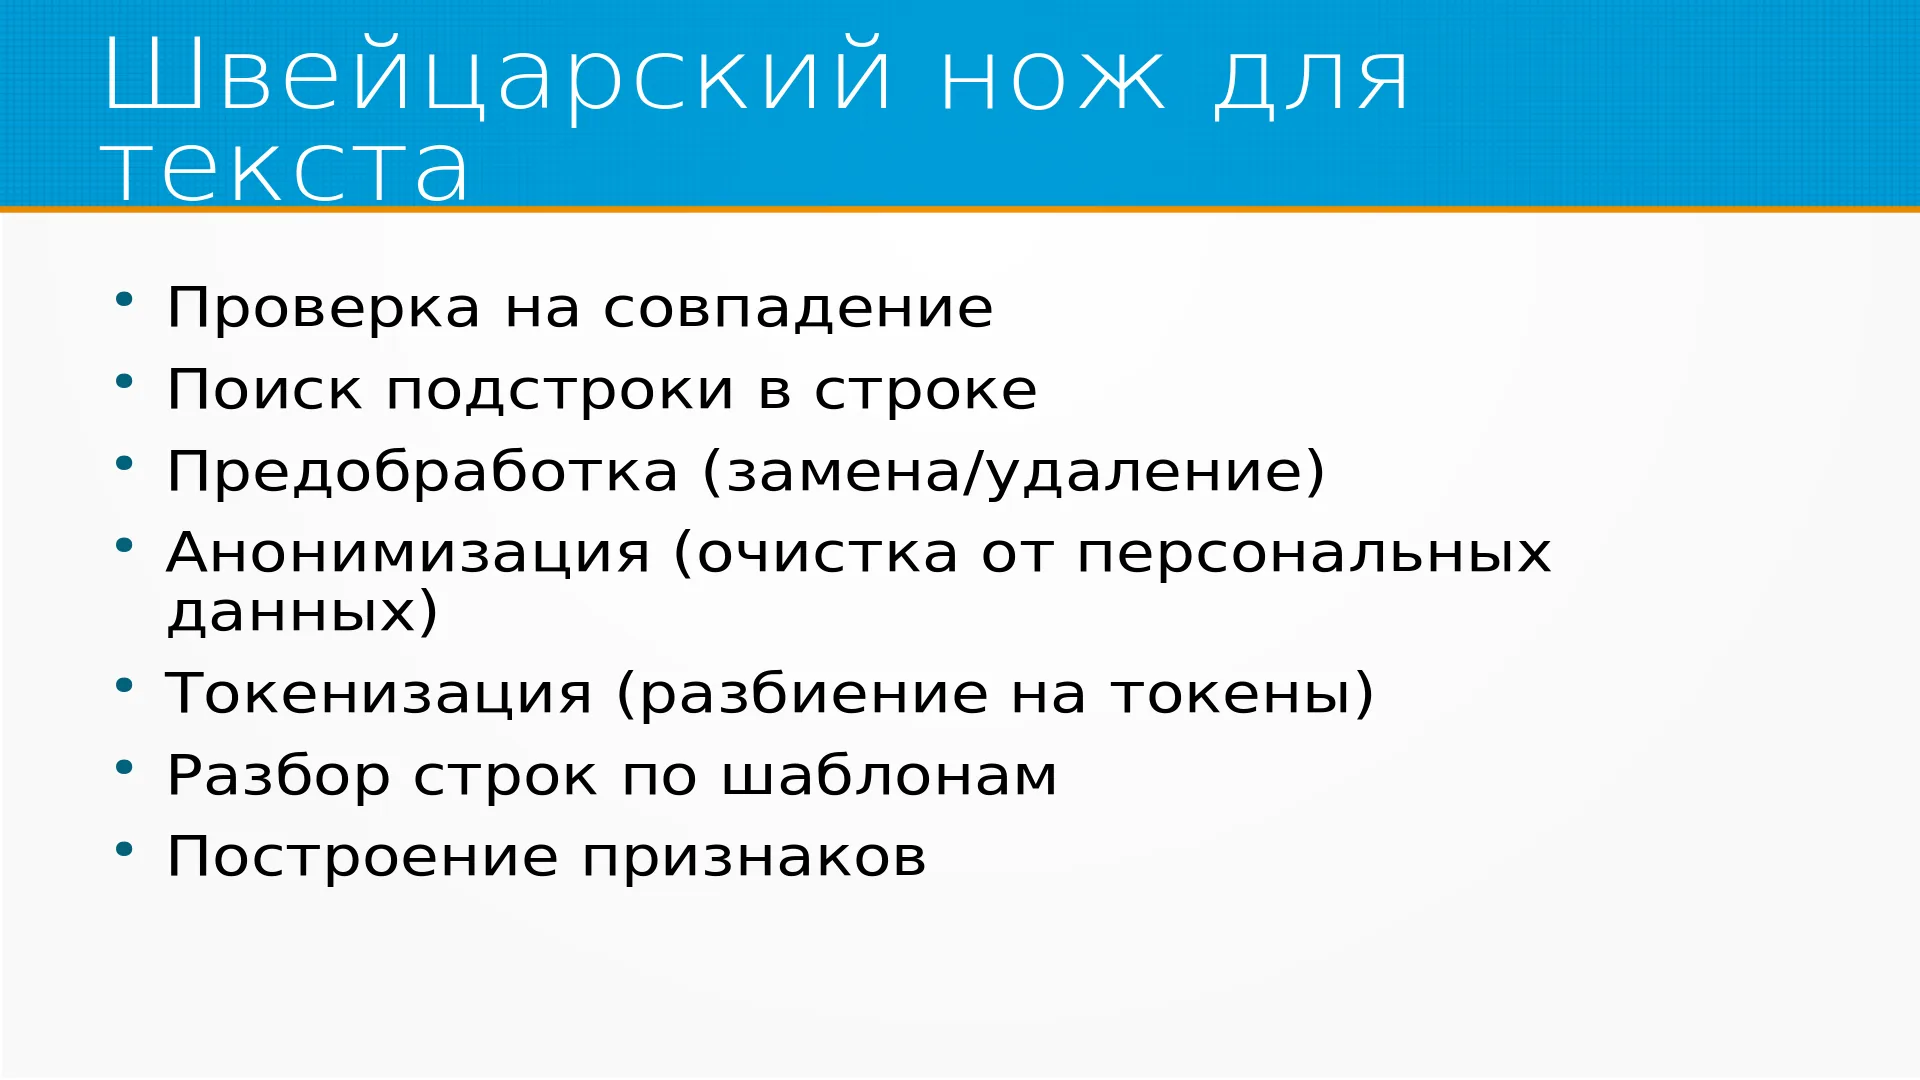
И что, собственно, такое регулярные выражения? Регулярные выражения — это такой швейцарский нож для текста, который позволяет делать кучу всяких прикольных вещей с текстом быстро и сравнительно легко. Вот, у них есть то недостатки, что регулярные выражения вы раз написали и фактически уже отредактировать не сможете, потому что никто, включая вас, не поймёт, что же там написано. Но в целом они такие вот удобные. Что можно делать регулярными выражениями? Можно проверять строки на совпадение с шаблоном, можно искать подстроку в строке, какую-то предобработку делать, то есть удаление спецсимволов, нормализацию текста, анонимизацию, удалять емейлы, ИНН, номера карточек. Токенизацию, например, токенизация в PyTorch сделана через регулярные выражения. Разбор строк по шаблонам, логи всякие там и так далее.
И построение признаков для моделей тоже нормально делается через регулярки, извлечение признаков из текста.
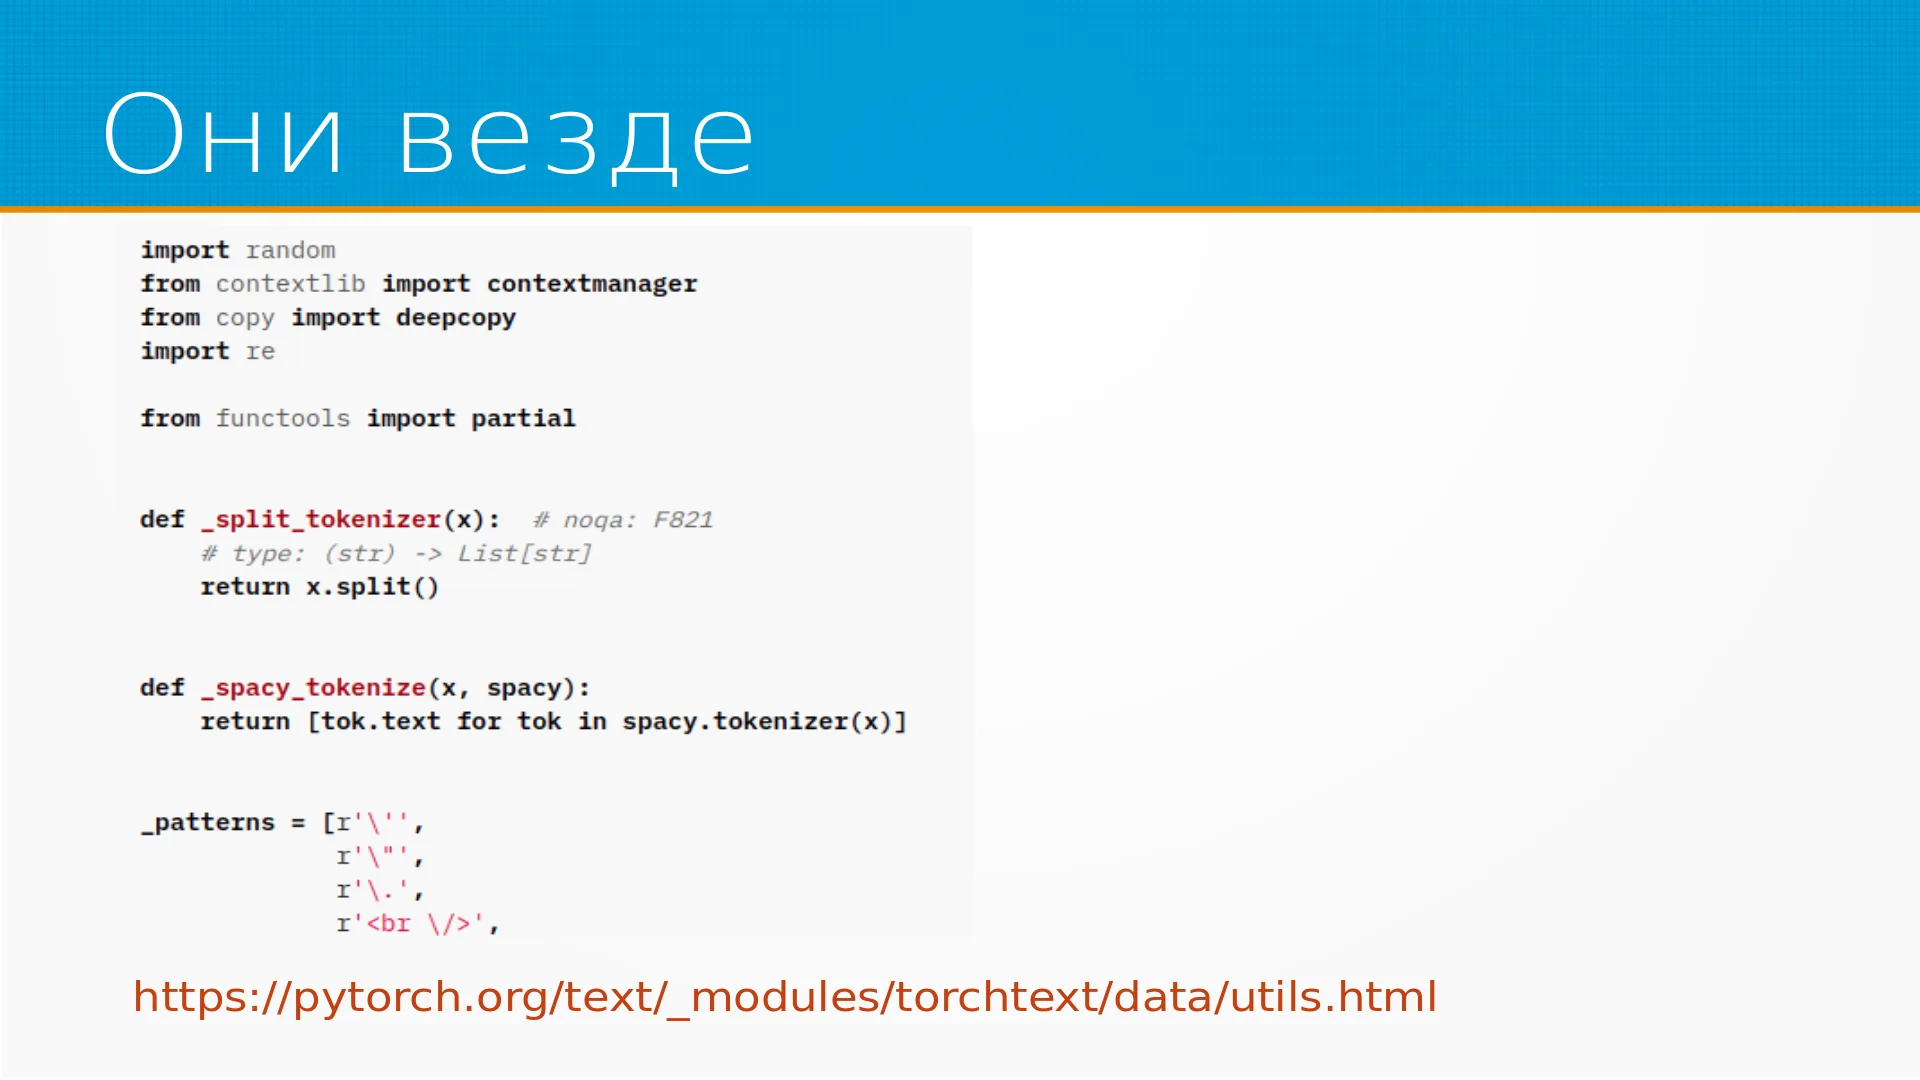
Сейчас. Регулярки везде. Вот, например, это из PyTorch.
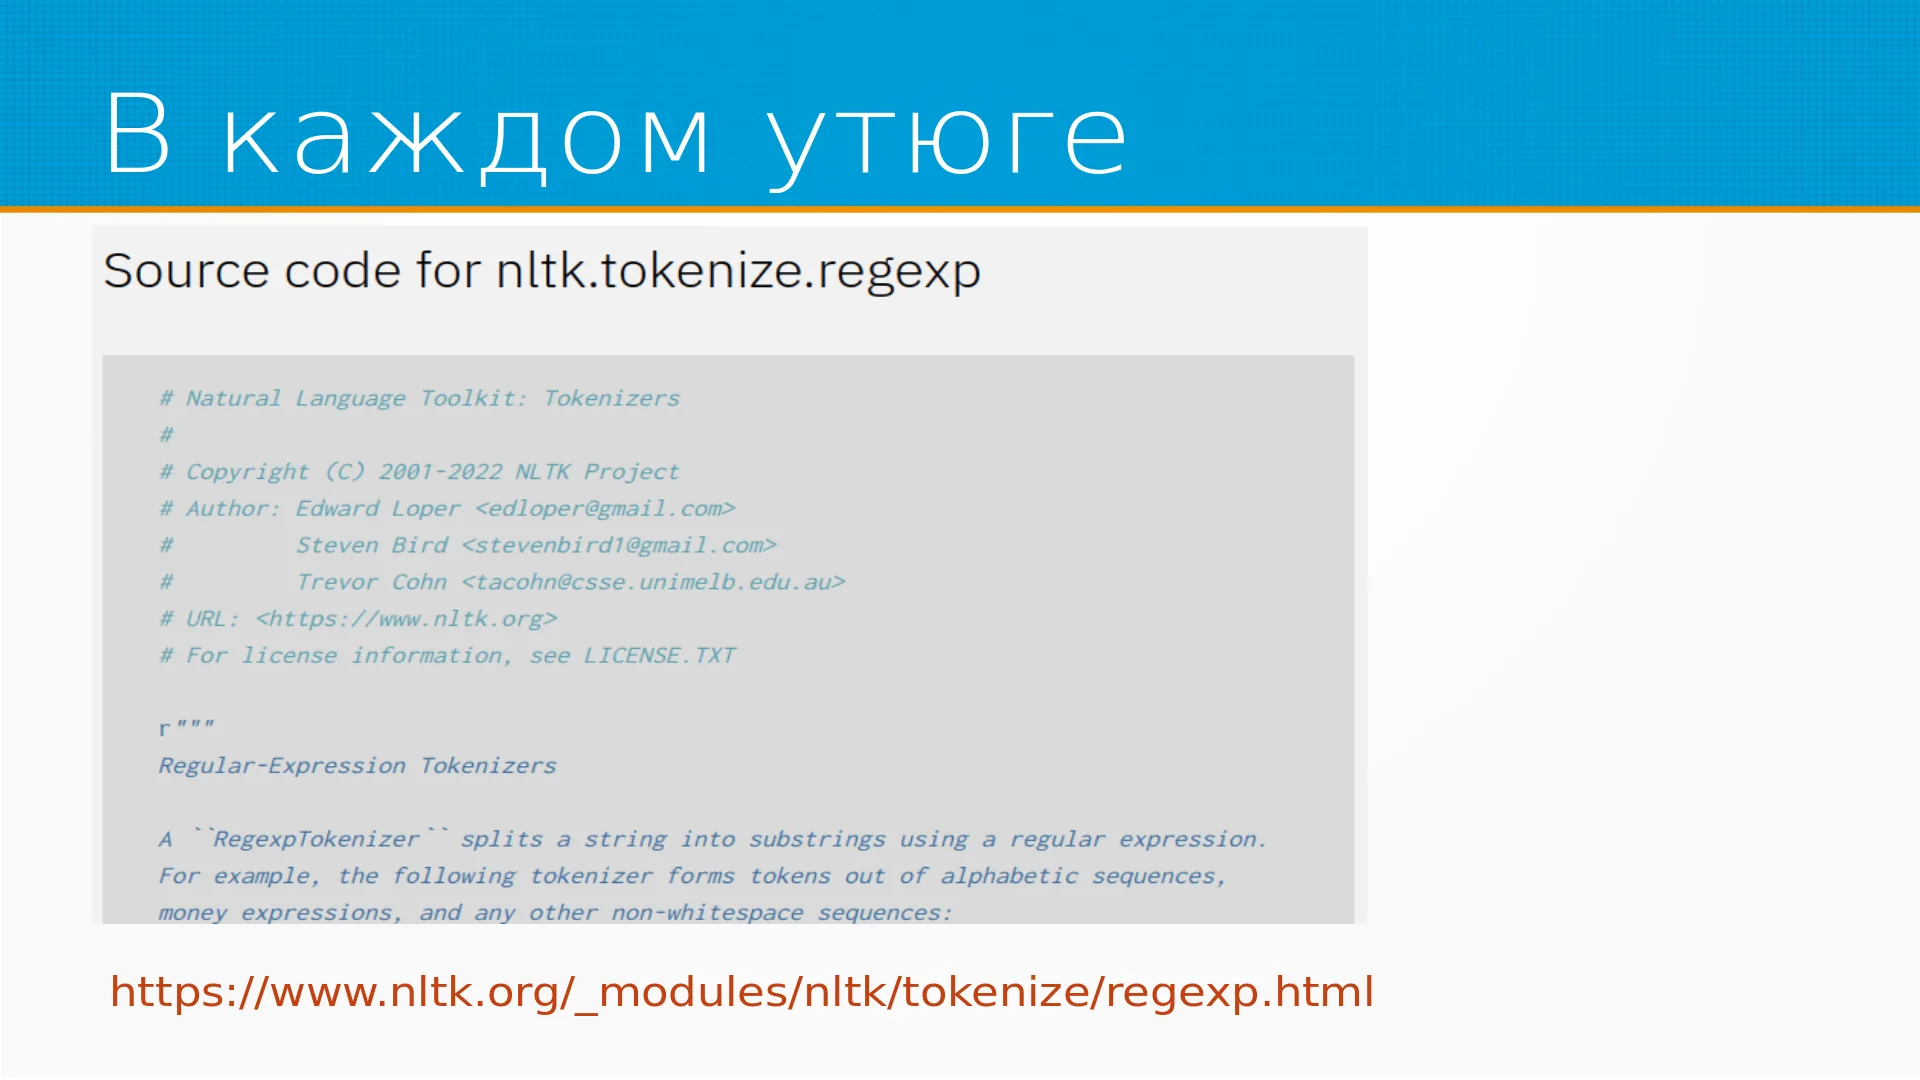
Здесь у нас в NLTK токенизатор на регулярках построен. Везде, практически в любом инструменте, в котором обрабатывается текст, сидят внутри регулярки.
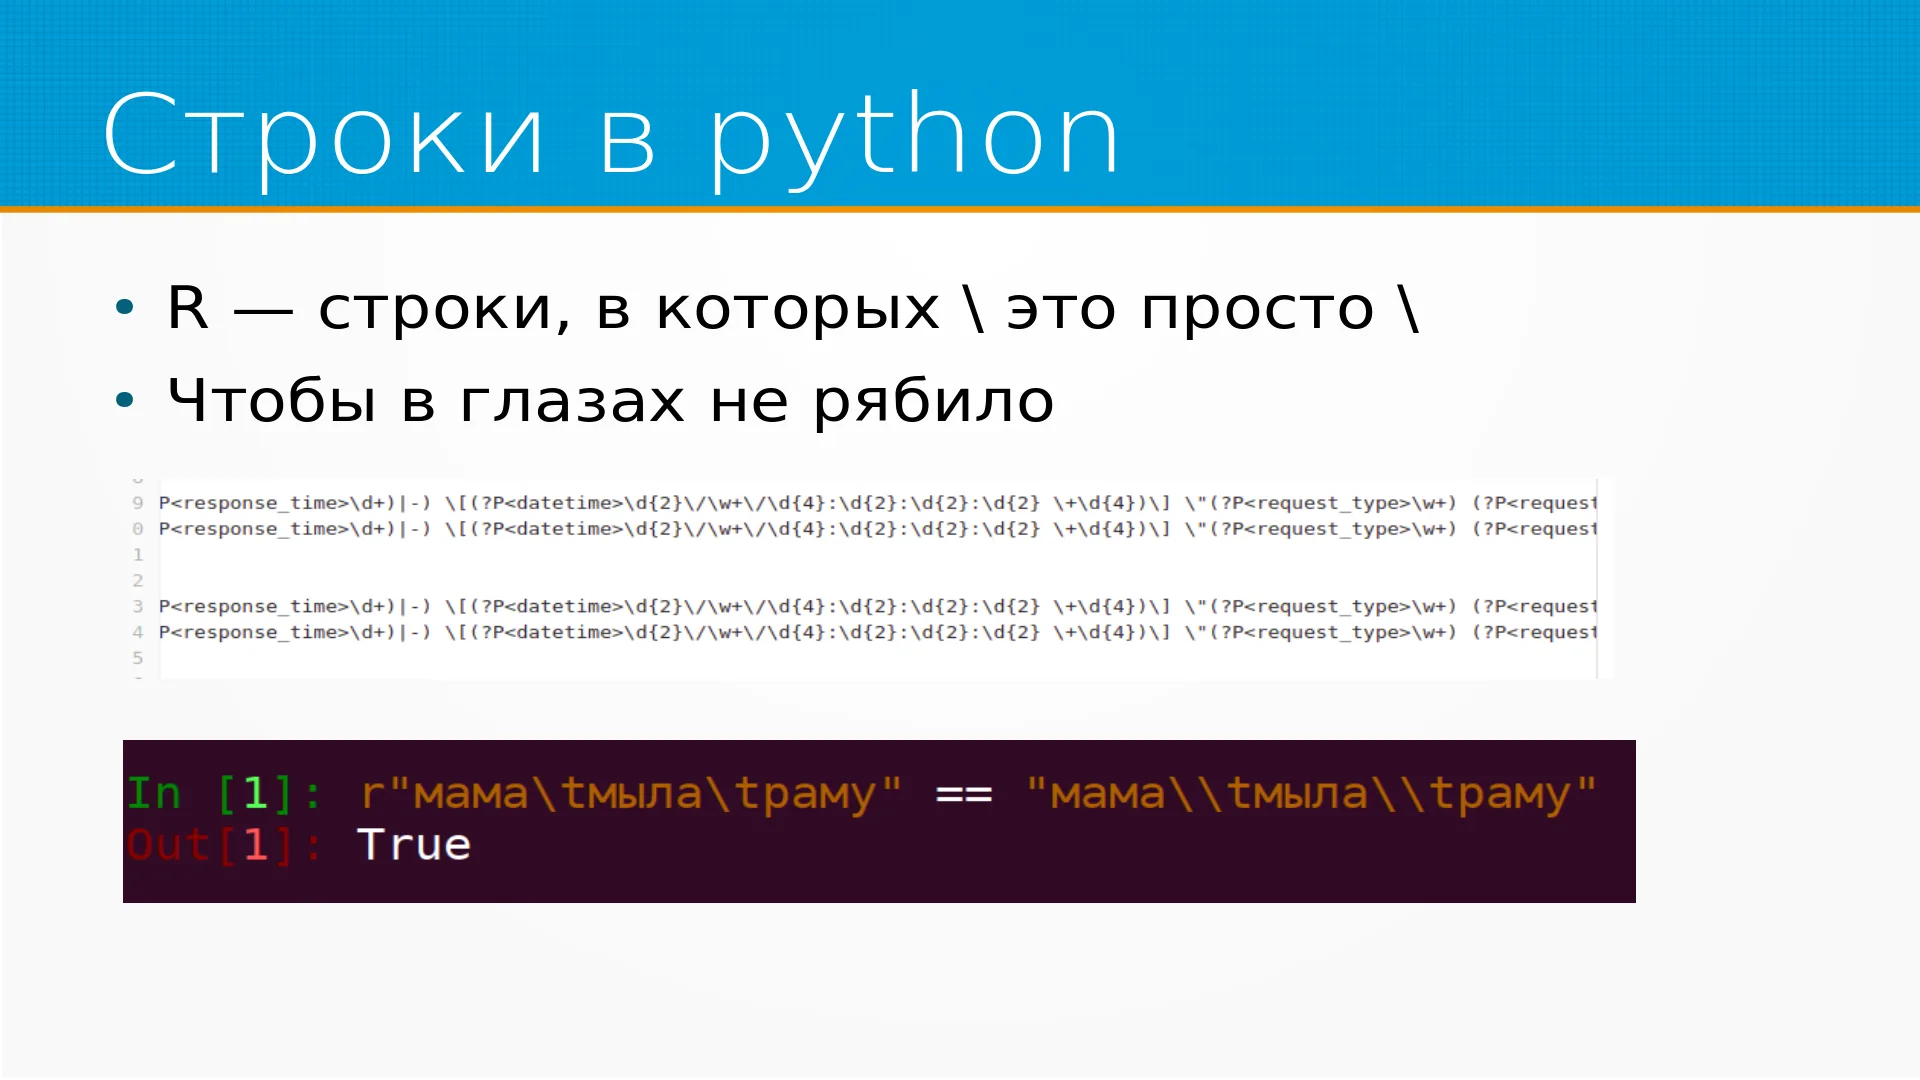
Прежде чем переходить как раз к регулярным выражениям, а, разберём строки. Дело в том, что в регулярных выражениях очень много используется обратные кавычки, обратные слэши. И если использовать обычные питоновские строки, в глазах будет рябить, потому что каждая слэш надо будет отслэшивать ещё одним слэшем. И есть хорошая привычка, если вы пишете регулярное выражение, то сразу использовать питоновские R-строки, где слэши, обратные слэши не разворачиваются. Вот, пример регулярных выражений с прода, это я сегодня скопировал, скриншот сделал, вот какие они. И видно, что слэш там через одного. Поэтому дальше мы везде используем R-строки, в которых ну вот, чем отличается R-строка от обычной, я на примере нарисовал. Там не надо два раза писать слэш, чтобы вставить один.
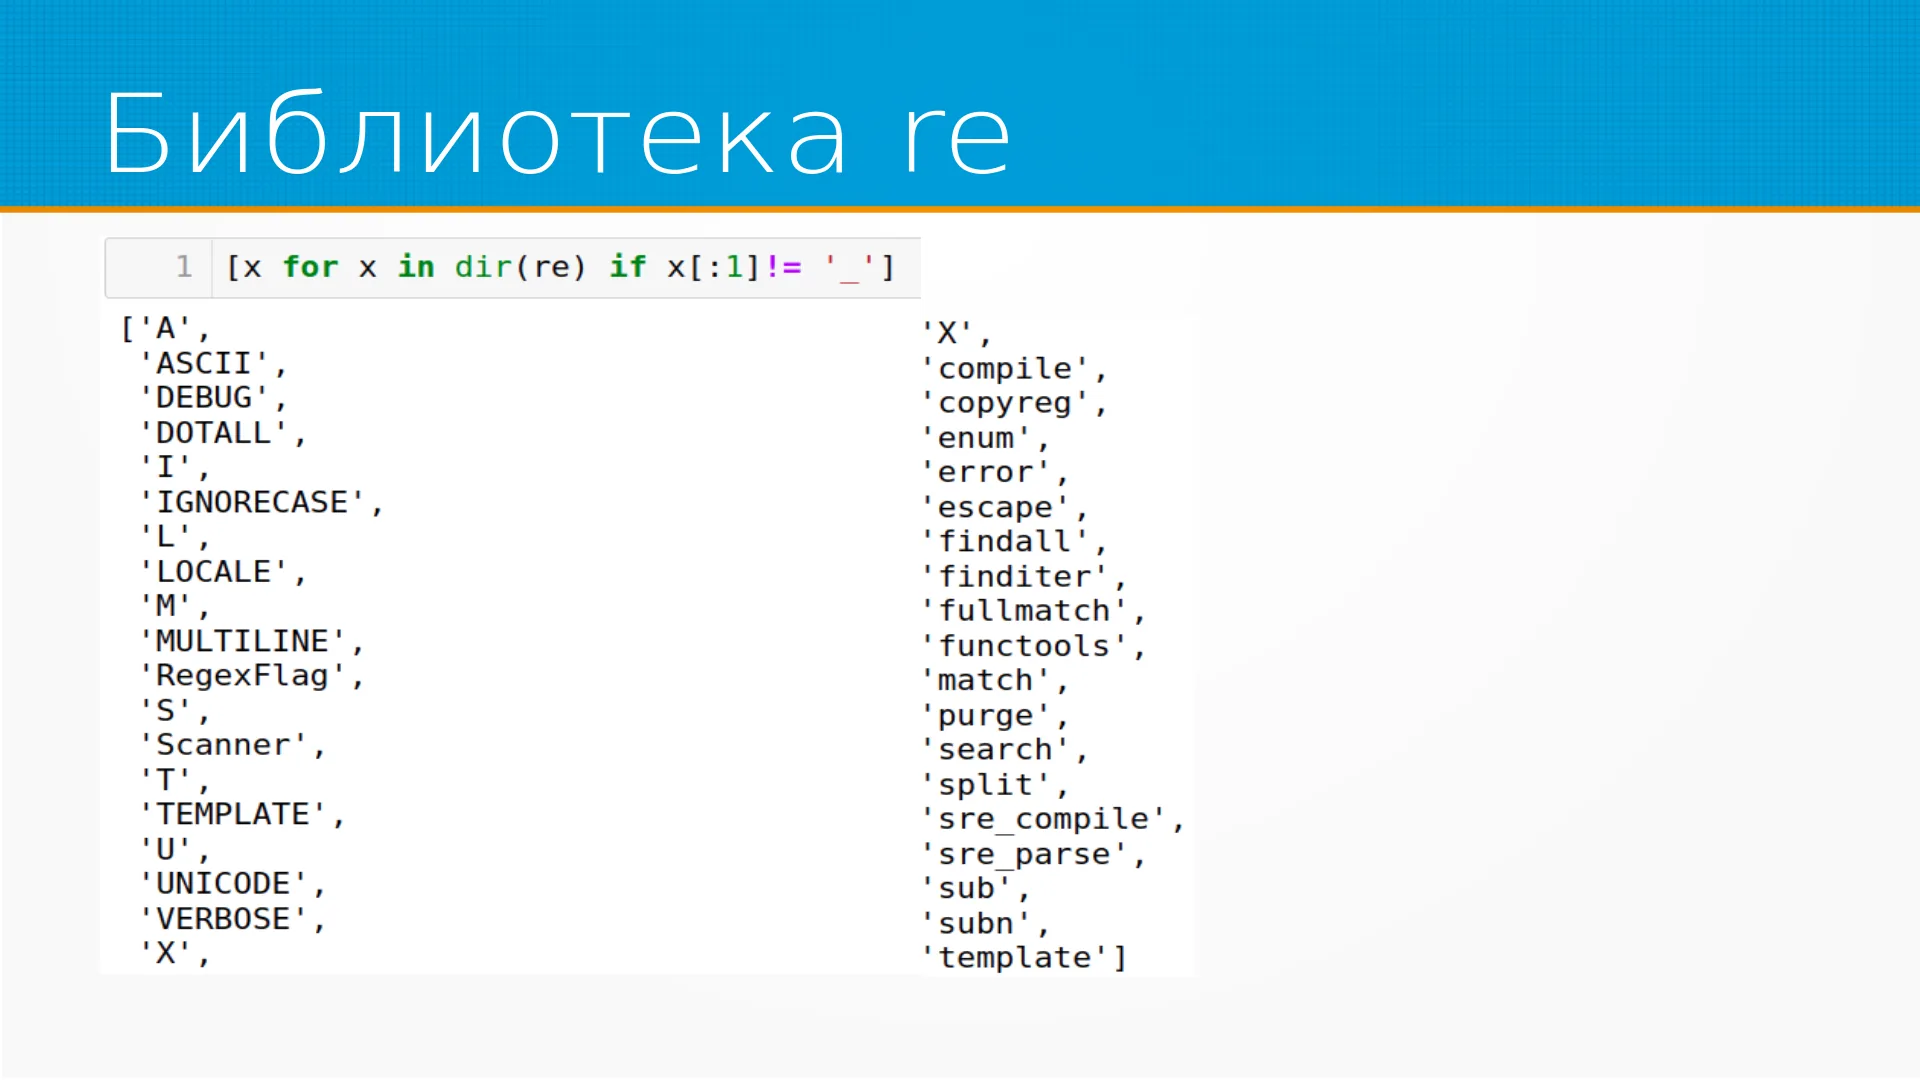
Сама библиотека re, она встроена в Python, её не надо устанавливать специально. С разными версиями Python идут разные версии re, в частности, вот эта вот, которую я рассматриваю, это для 3.9. В 3.10 есть небольшие доработки, но они не принципиальные, всё, что работает в 3.10, в 3.9 тоже работает.
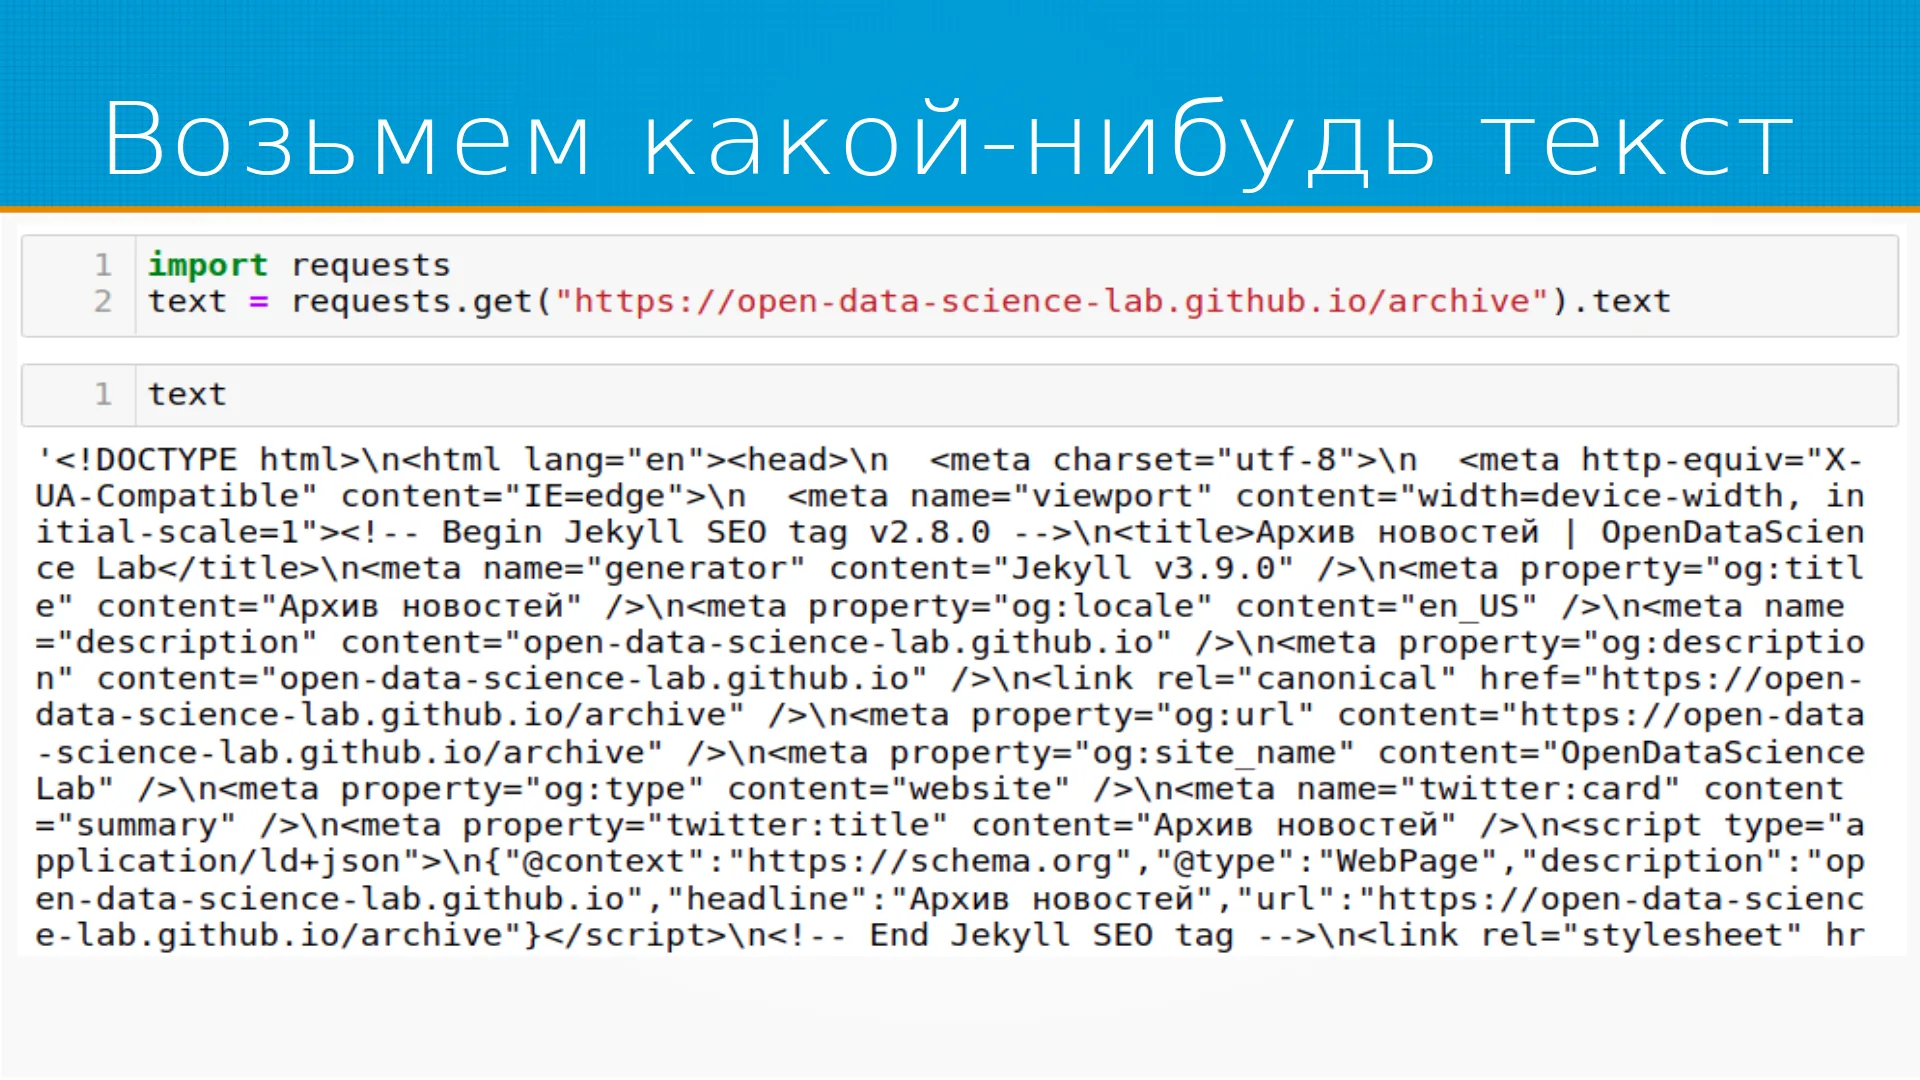
Для того, чтобы дальше работать, надо взять какой-нибудь текст. Я взял текст со списка, со страницы анонсов лаборатории.
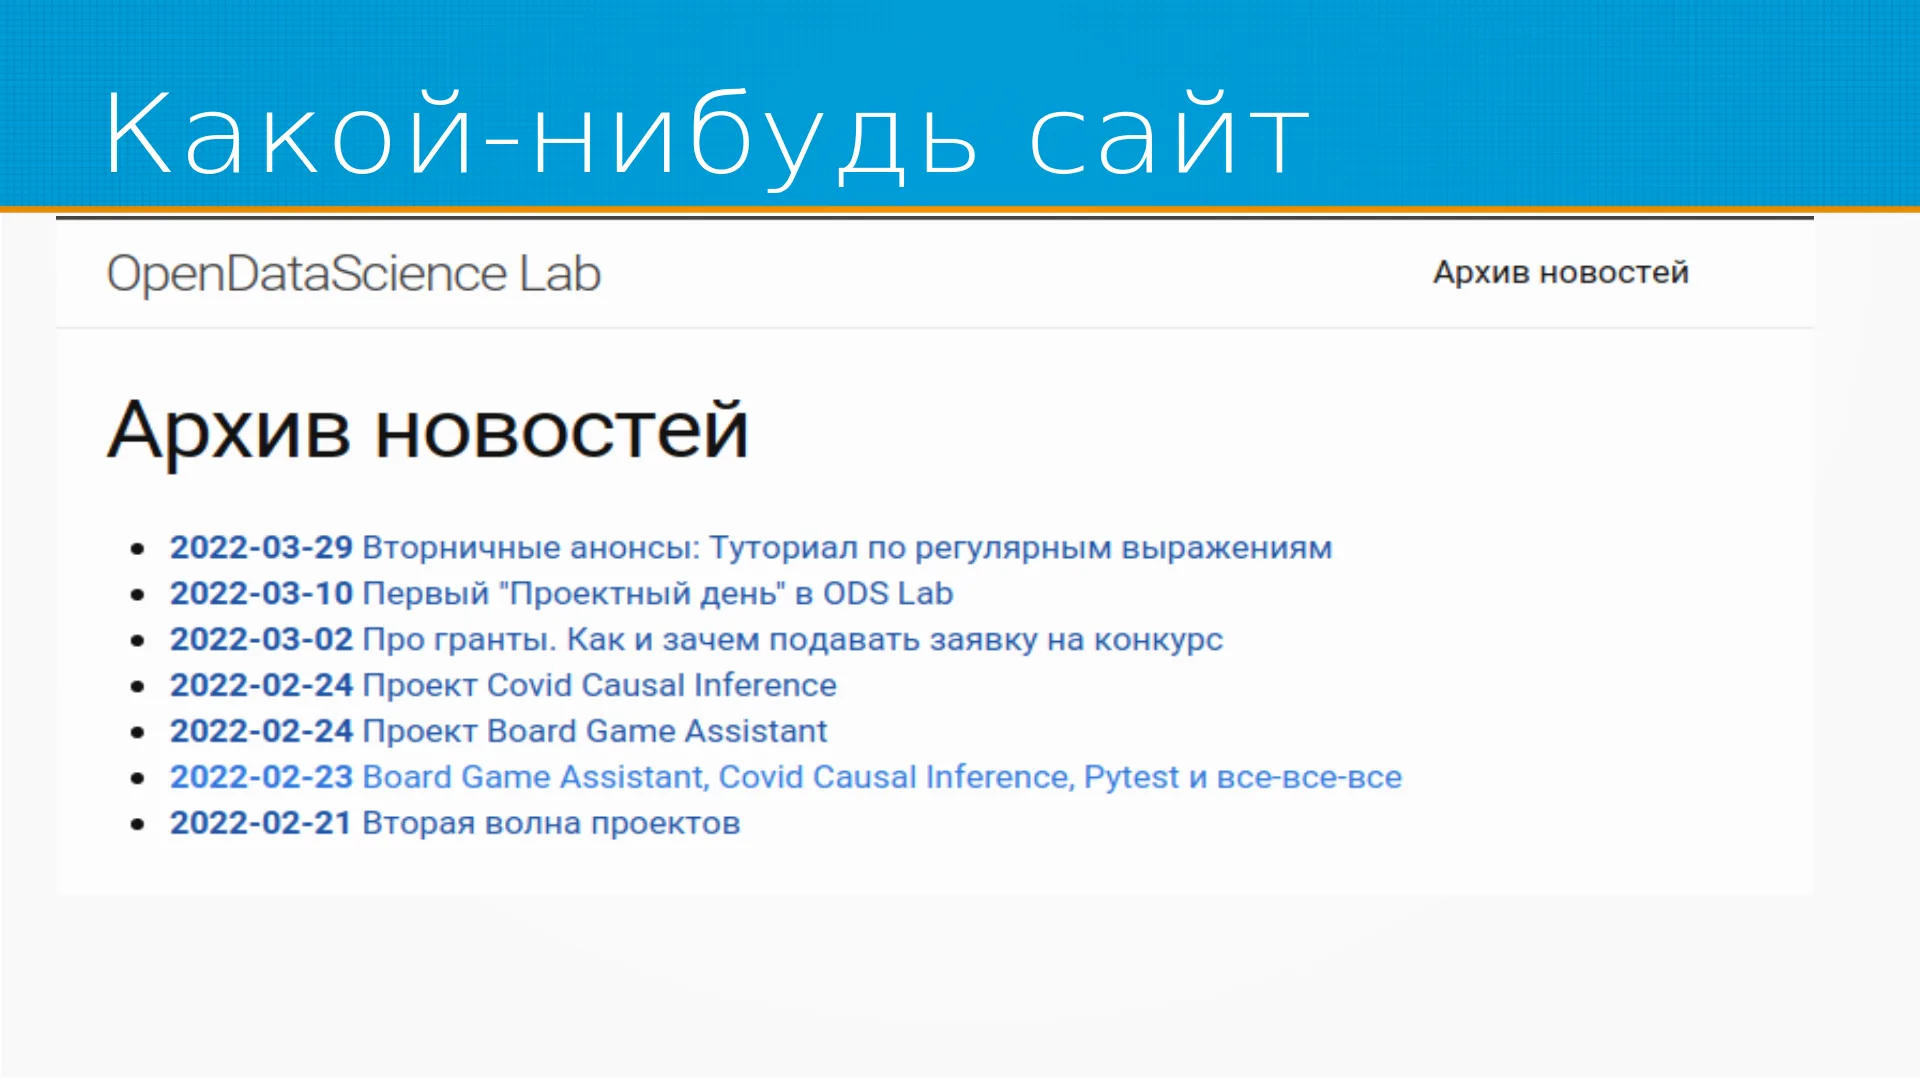
Выглядит он примерно вот так. В тексте он так, а внешне он выглядит вот так. Видим, что у нас тут есть дата анонса, список анонсов, заголовок.
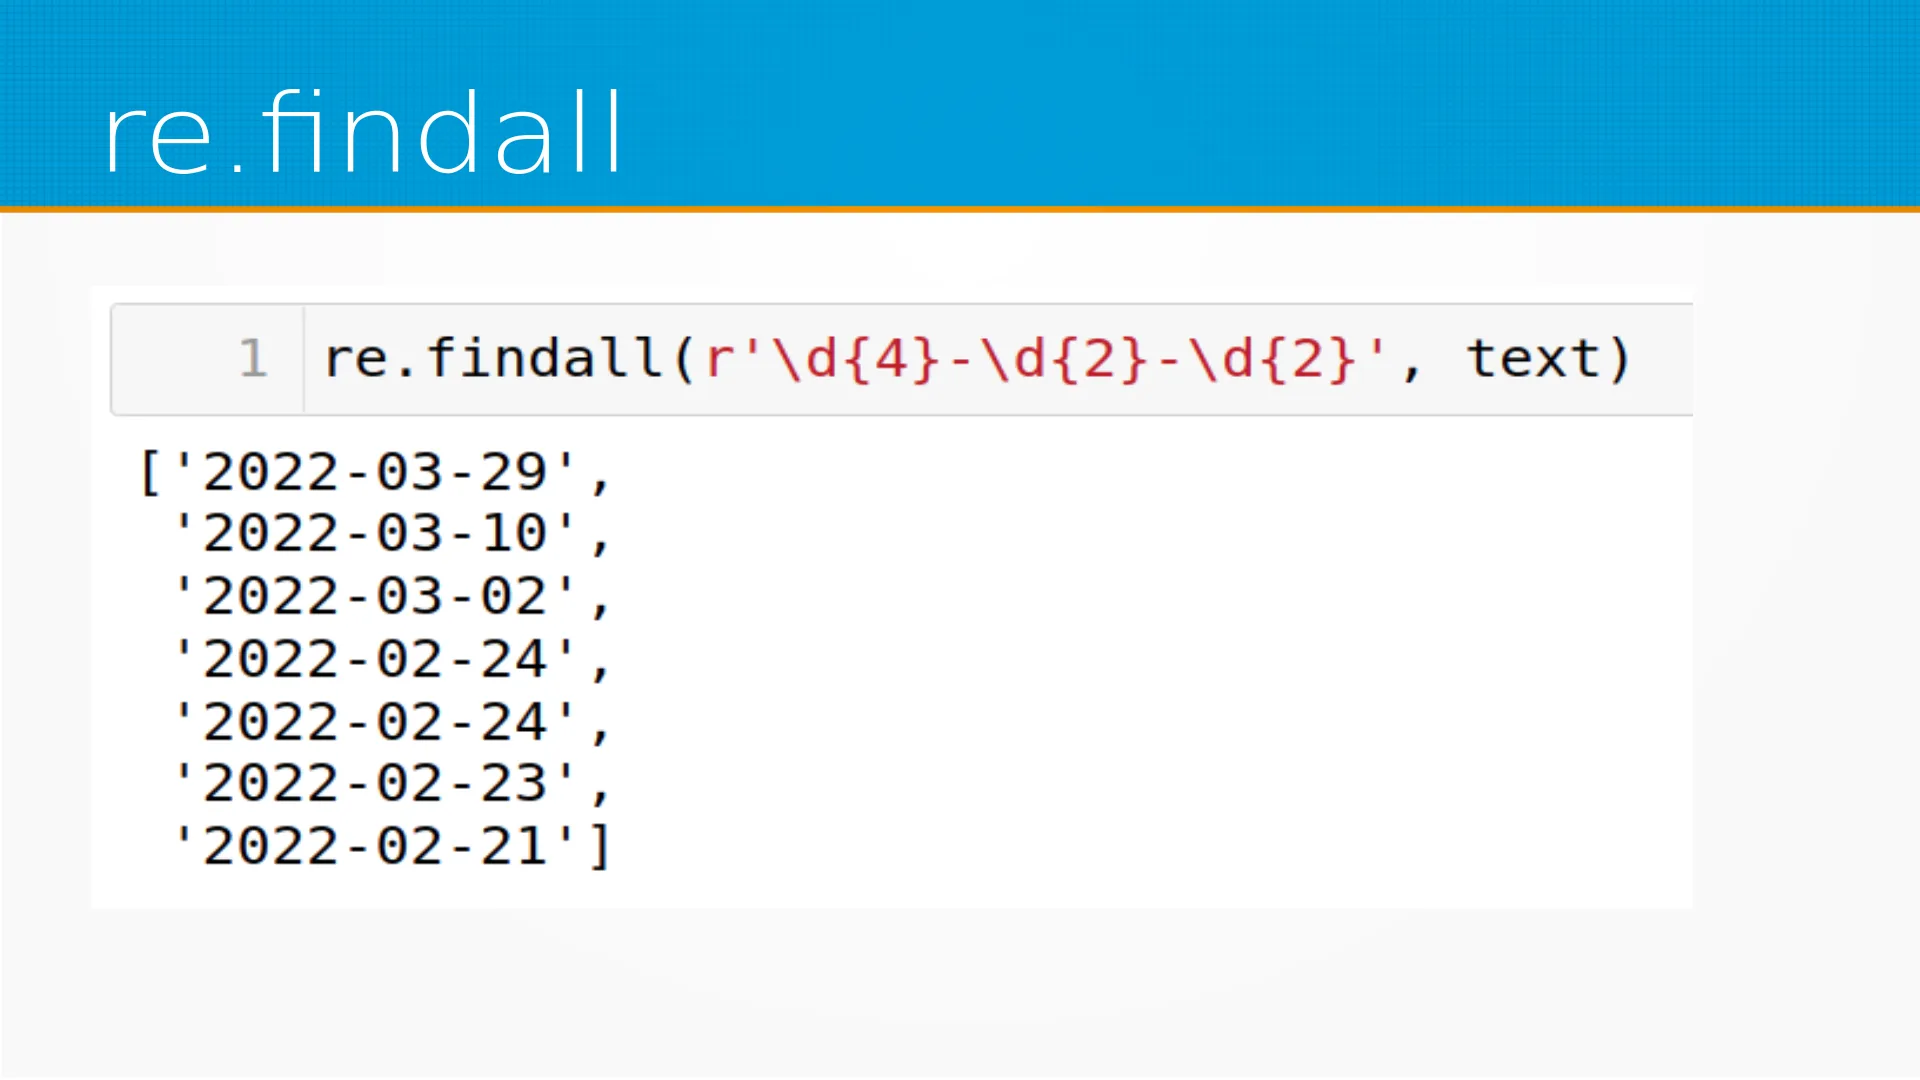
И давайте найдём все анонсы, все даты анонсов на странице. Мы берём наш текст, берём библиотеку re, и ищем регулярным выражением, пока неважно, что оно означает, находим все даты анонсов. Вот они. Что тут происходит у нас? Косая D - это любое, любая цифра. Четыре - это значит, что цифра должна быть повторена четыре раза. Дефис означает дефис. Затем две цифры, повторённые два раза, и ещё раз две цифры через дефис. И, а, библиотека re проходит по тексту, ищет все такие совпадения и выводит их в виде списка. Внутри она строит конечный автомат, который идёт по тексту, но это пока неважно.
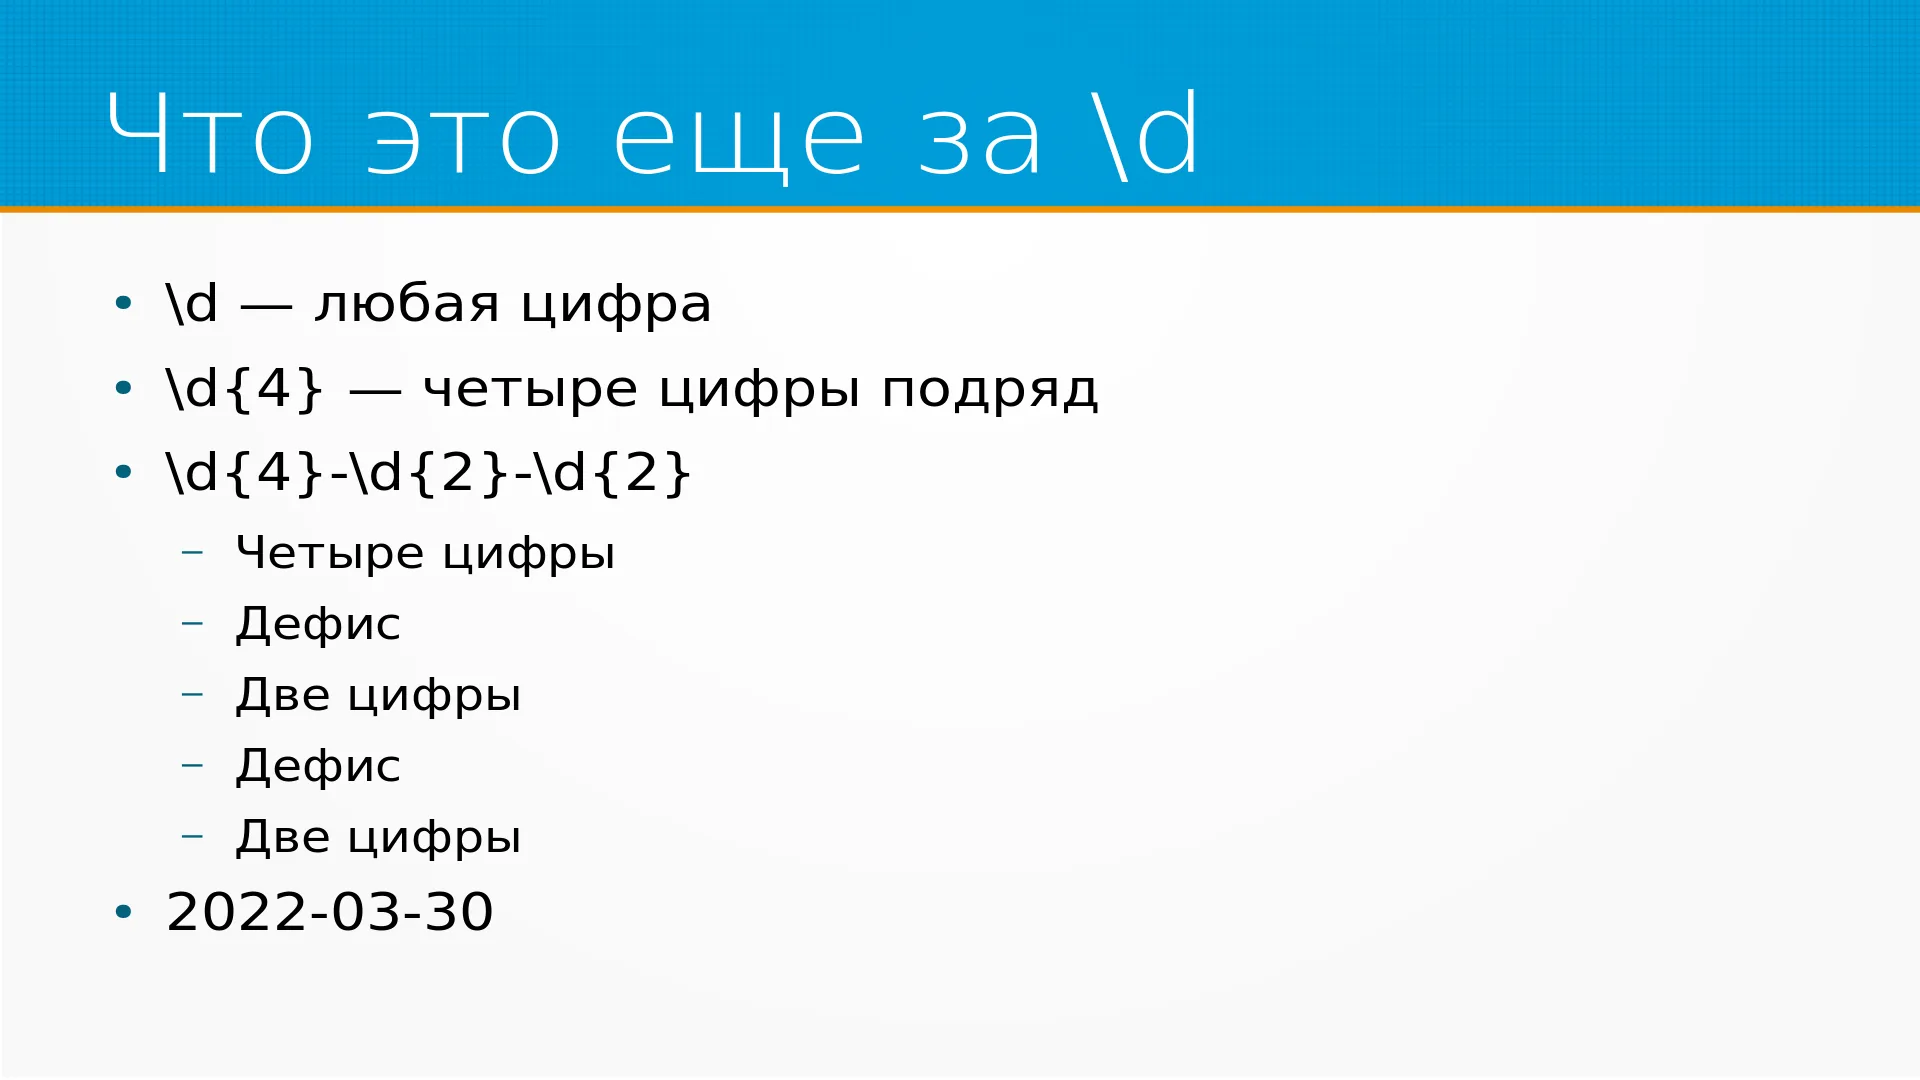
Как я уже говорил, D, косая D - это специальный символ, обозначающий, класс символов, обозначающий любую цифру. И вот тут, в принципе, разобрано это, как оно выглядит.
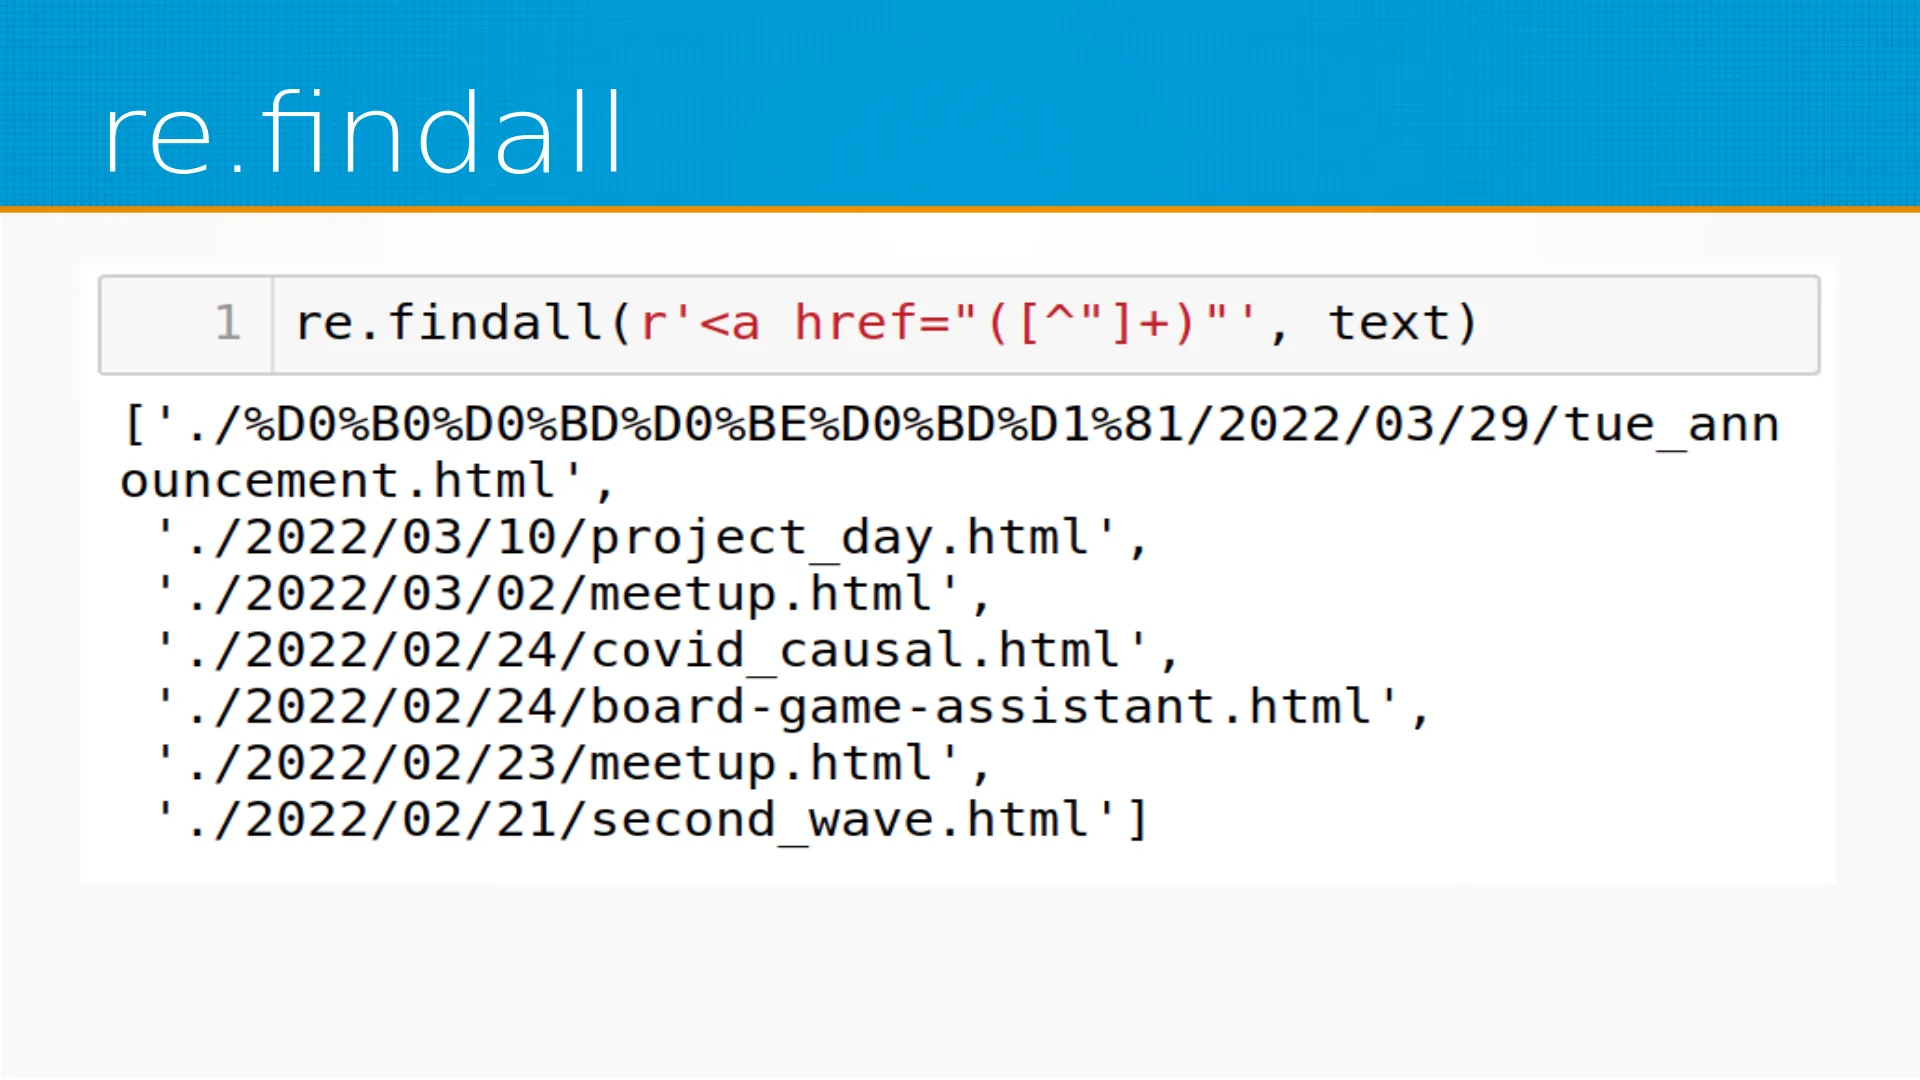
Вот таким регулярным выражением мы можем вытащить все ссылки из текста. Всё, что начинается с открывающей угловой скобки, А, пробел, href равно, кавычка, и затем в скобках текст ссылки, кавычка закрывается.
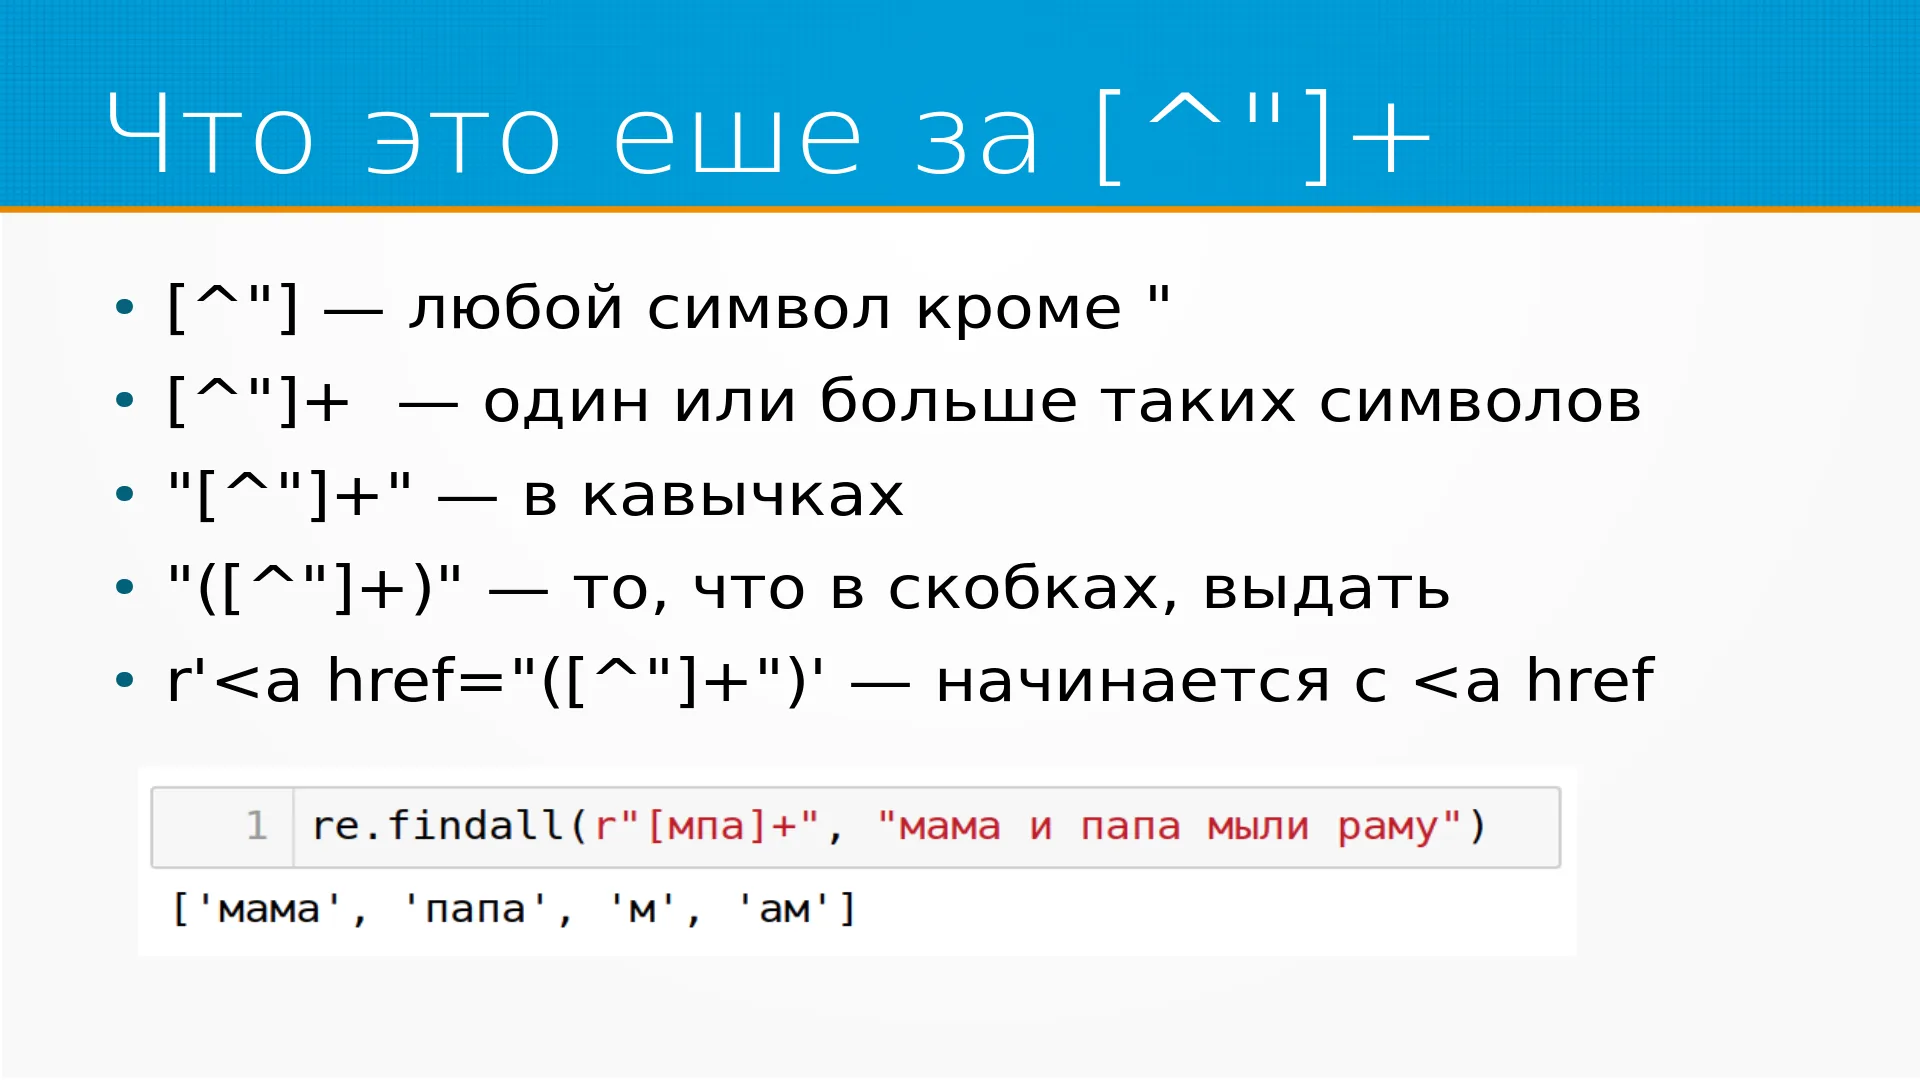
Получаем вот такой список. И как это регулярное выражение устроено? В квадратных скобках у нас крышечка и за ней кавычка. В квадратных скобках у нас указывается класс символов. Есть предопределённые классы символов, такие как косая D, которые обозначают любые цифры, но мы можем определить другой класс символов, перечислив их в квадратных скобках. Например, а, если бы в кавычках были АБВГД, то это совпадало бы с любой буквой А, Б, В или Г, или Д, неважно. Если же символьный класс начинается с кавычки, то это отрицание символьного класса. Кавычка крышечка, кавычка совпадает с любым символом, кроме кавычки. Плюс означает, что таких символов у нас один или больше. И таким образом мы, получается, что строим выражение, которое вытаскивает все ссылки.
Вот, например мы объявляем символьный класс МПА, и он совпадает с мама, папа, а также с м в слове мыли и ам в слове рама.
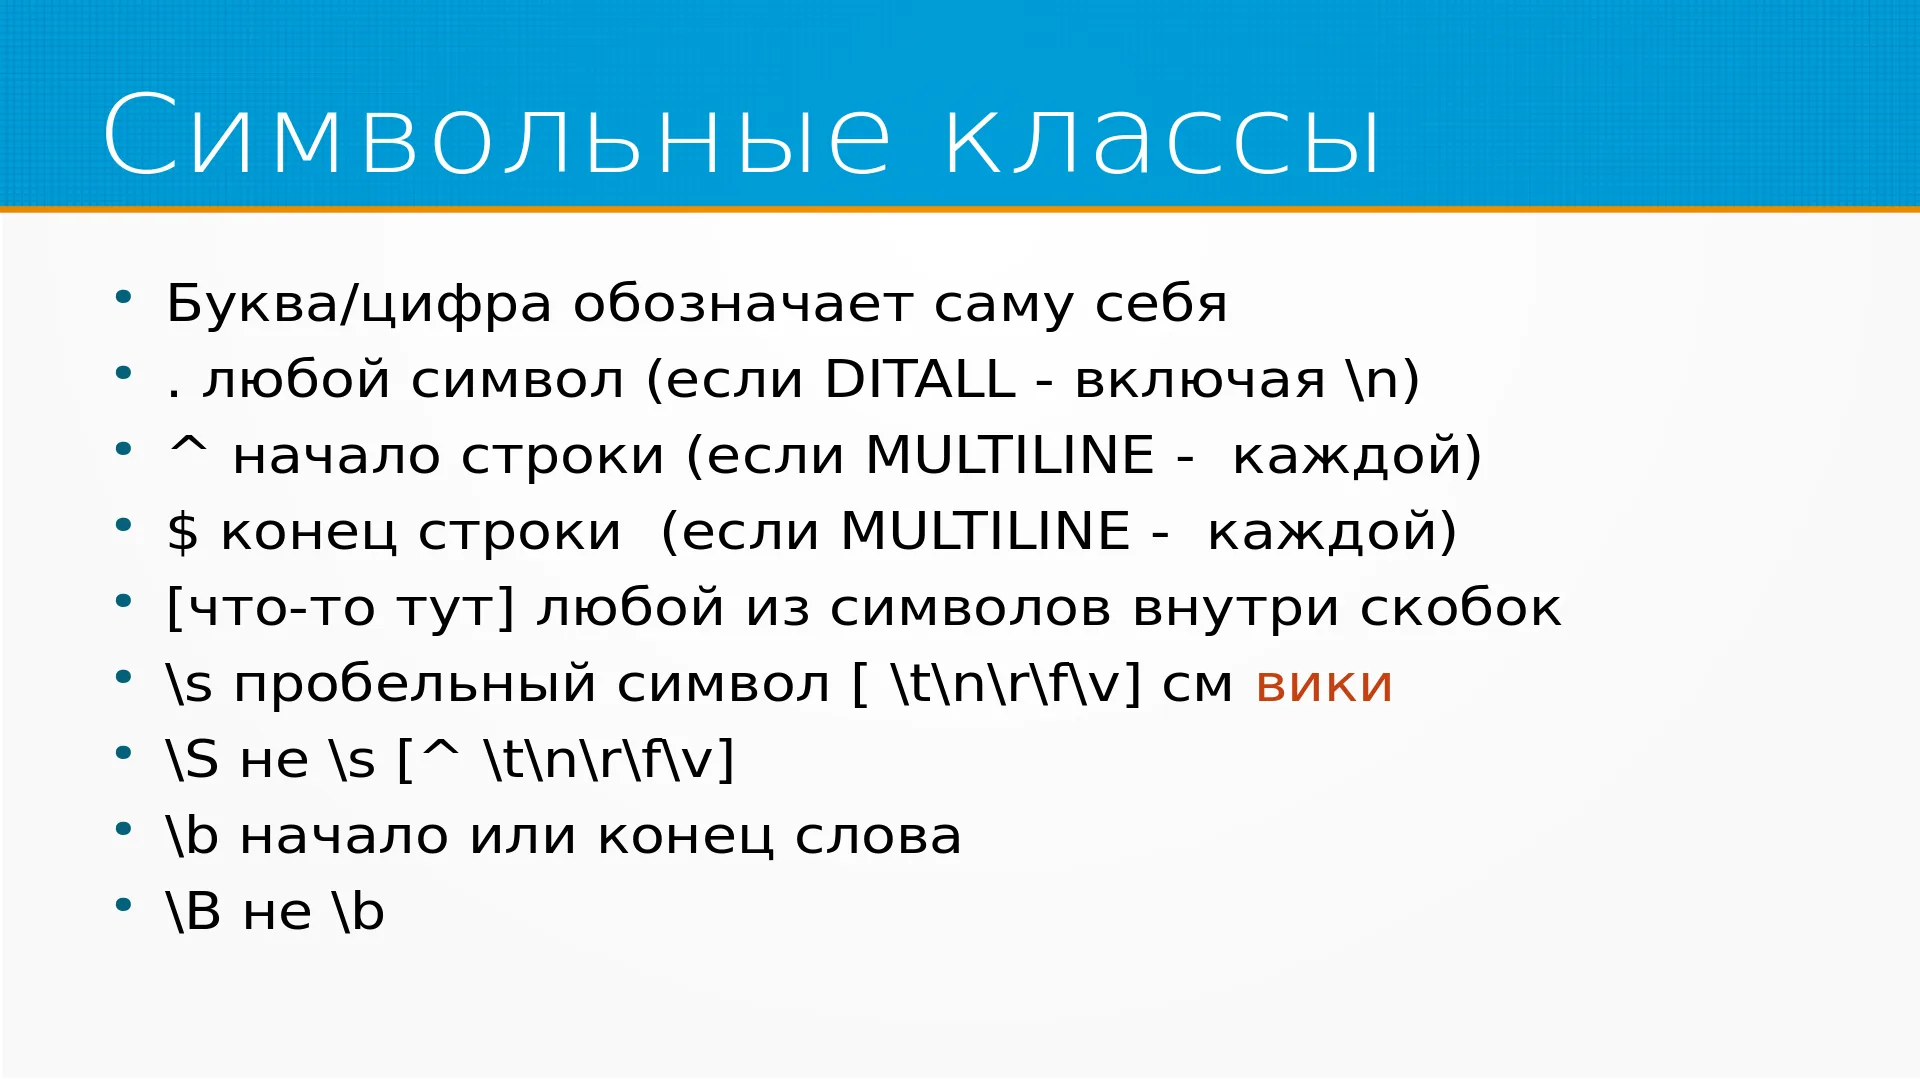
Как строятся символьные классы? Буква или цифра обозначает саму себя. Точка обозначает любой символ. Если тут название флага неправильно написано, если указан флаг dot all, то точка совпадает также с переводом строки, а по умолчанию она с переводом строки не совпадает. Открывающая крышечка совпадает с началом строки, причём, если установлен флаг multiline, то с началом каждой строки. Доллар совпадает с концом строки, то есть, если multiline, то с каждой строки. И есть специальные символы, они все строятся примерно одинаково. Маленькая буква означает какой-нибудь класс, например, маленькая буква S - это пробельные символы, Tab, новая строка, пробел. Большая буква S латинская означает всё, что не маленькая буква S, отрицание класса.
Маленькая буква B обозначает пустой символ перед началом или перед концом слова. Большая буква B означает всё, что не маленькая буква B.
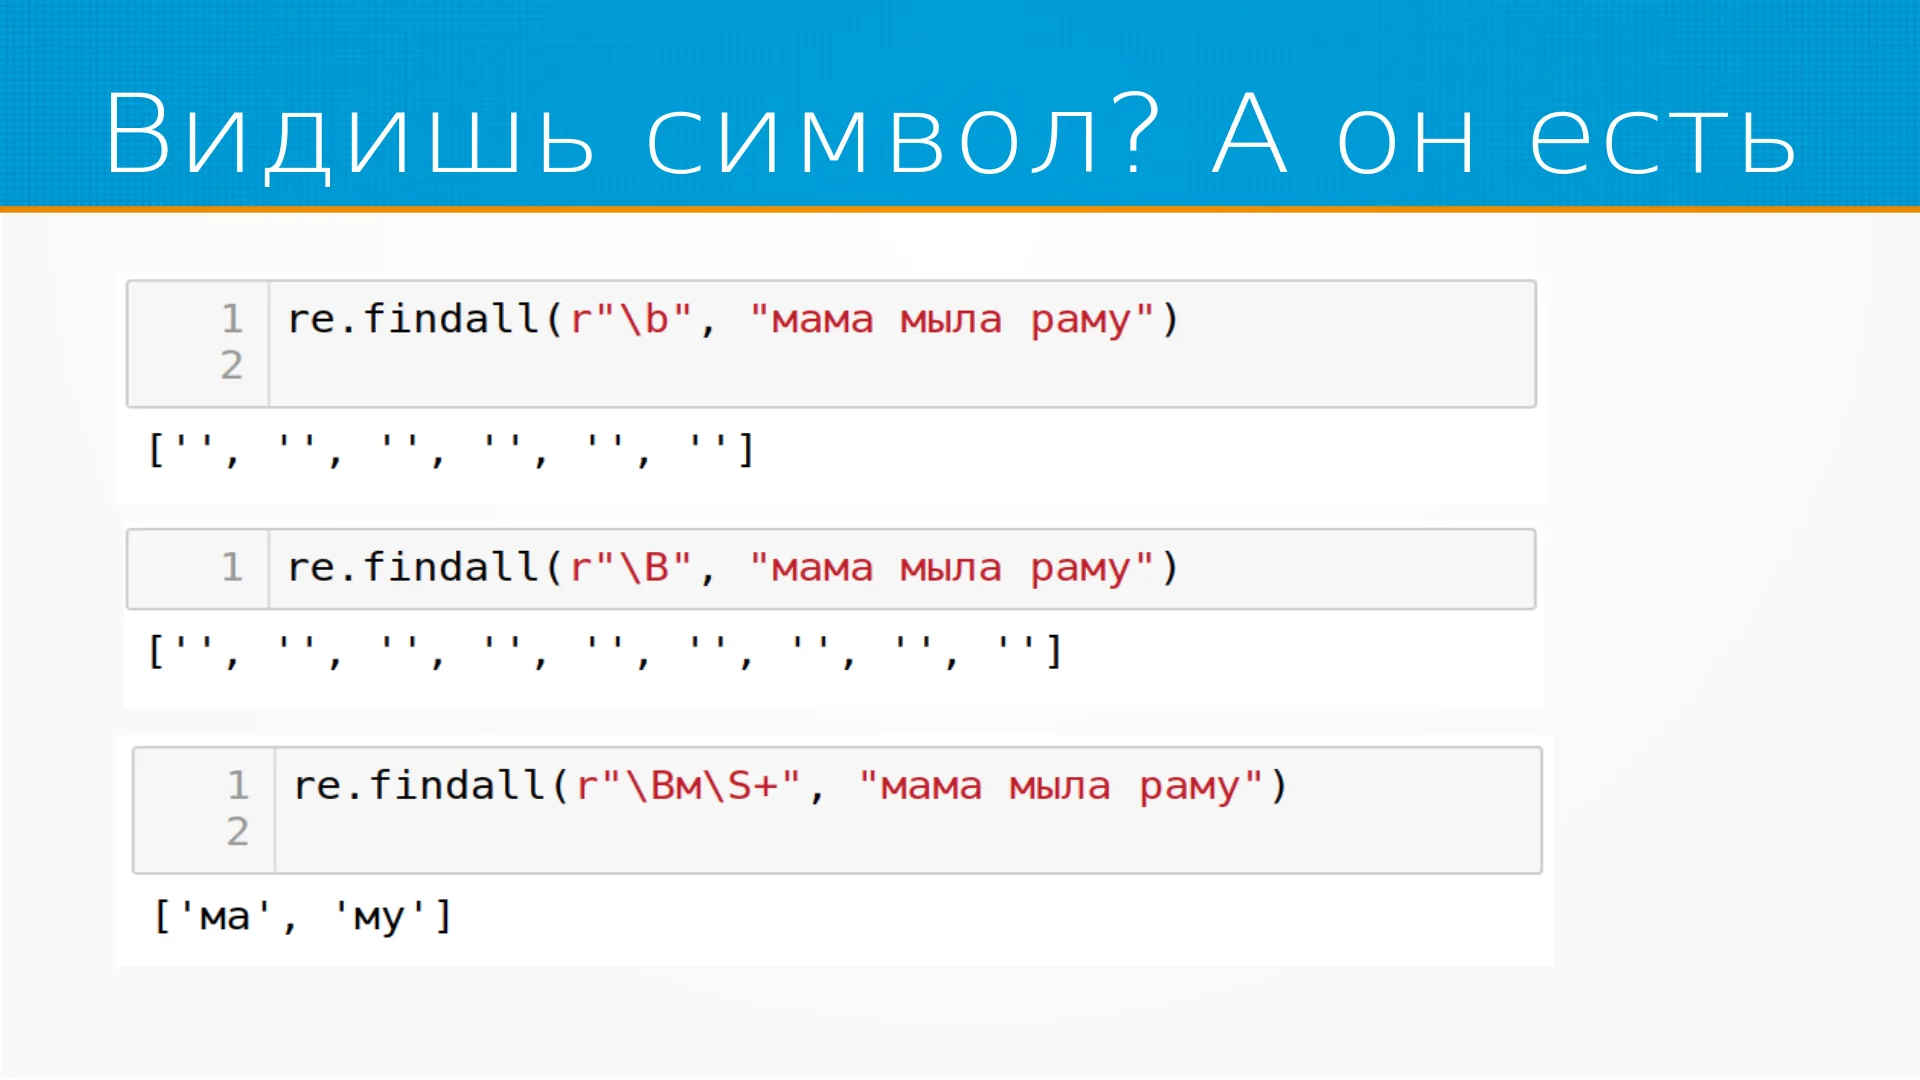
С, вот это достаточно странный символ, но он позволяет лучше понять, как регулярки, в принципе, работают. В слове мама мыла раму символ косая маленькая B совпадает с, класс косая маленькая B совпадает в шесть раз. Перед словом мама, после слова мама, перед словом мыло, после слова мыло, перед словом рама и после слова рама. Символ B большая совпадает везде внутри слова мама три раза, внутри слова мыло три раза и внутри слова рама три раза. Там, где не, не в начале и не в конце слова. Для чего такое может быть странное нужно? Вот, например, регулярное выражение, которое вытаскивает, а, что-нибудь, что начинается с маленькой буквы М, не находится в начале слова, и некоторое количество непустых пробелов.
Оно совпадает с ма в слове мама, со вторым ма, причём, и с му в слове раму. Как это образуется, как это получается? У нас большая B совпадает с между М и А, но за ним идёт А, стало быть, она правило не срабатывает. Регулярное выражение переходит к следующей букве и пытается применить его заново. Между А и М у нас есть не начало слова, потом идёт М, потом идёт некоторое количество непустых символов, один или больше. И вот у нас ма совпало. Таким, после того, как оно совпало, оно двигает опять указатель дальше и находит му совпавшее. Ма и му.
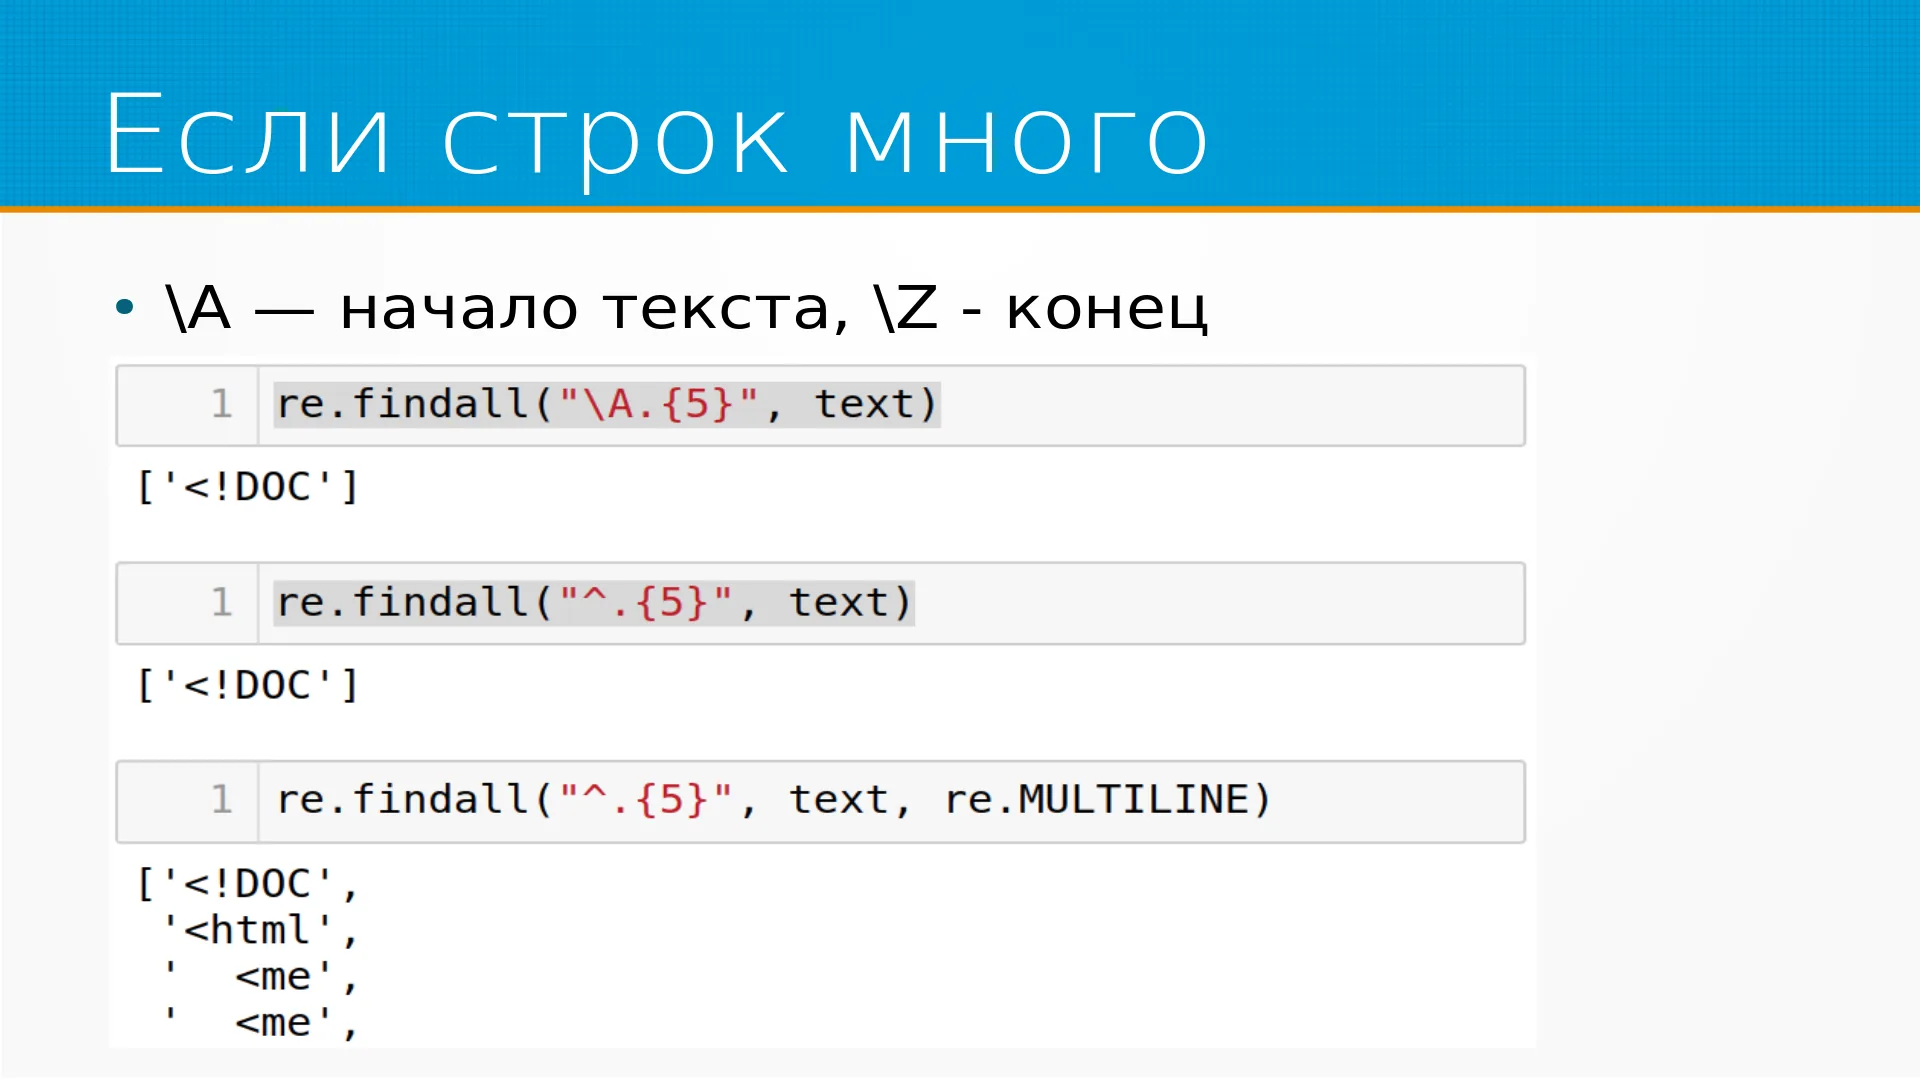
Пока, в общем, ничего сложного. Если у нас многострочный текст, то нам удобно было бы отличать начало текста, конец текста, а также начало каждой строки и конец каждой строки. И вот тут, например, re.findall находит пять символов в начале текста. С косой А. С точкой он находит в начале текста, если у нас не установлен флаг multiline, а если установлен, то он находит пять символов в начале каждой строки. После, перед каждым переводом строки у нас опять символов из текста вытаскивается. Напомню, что сам по себе текст у нас выглядит вот так. Угу.
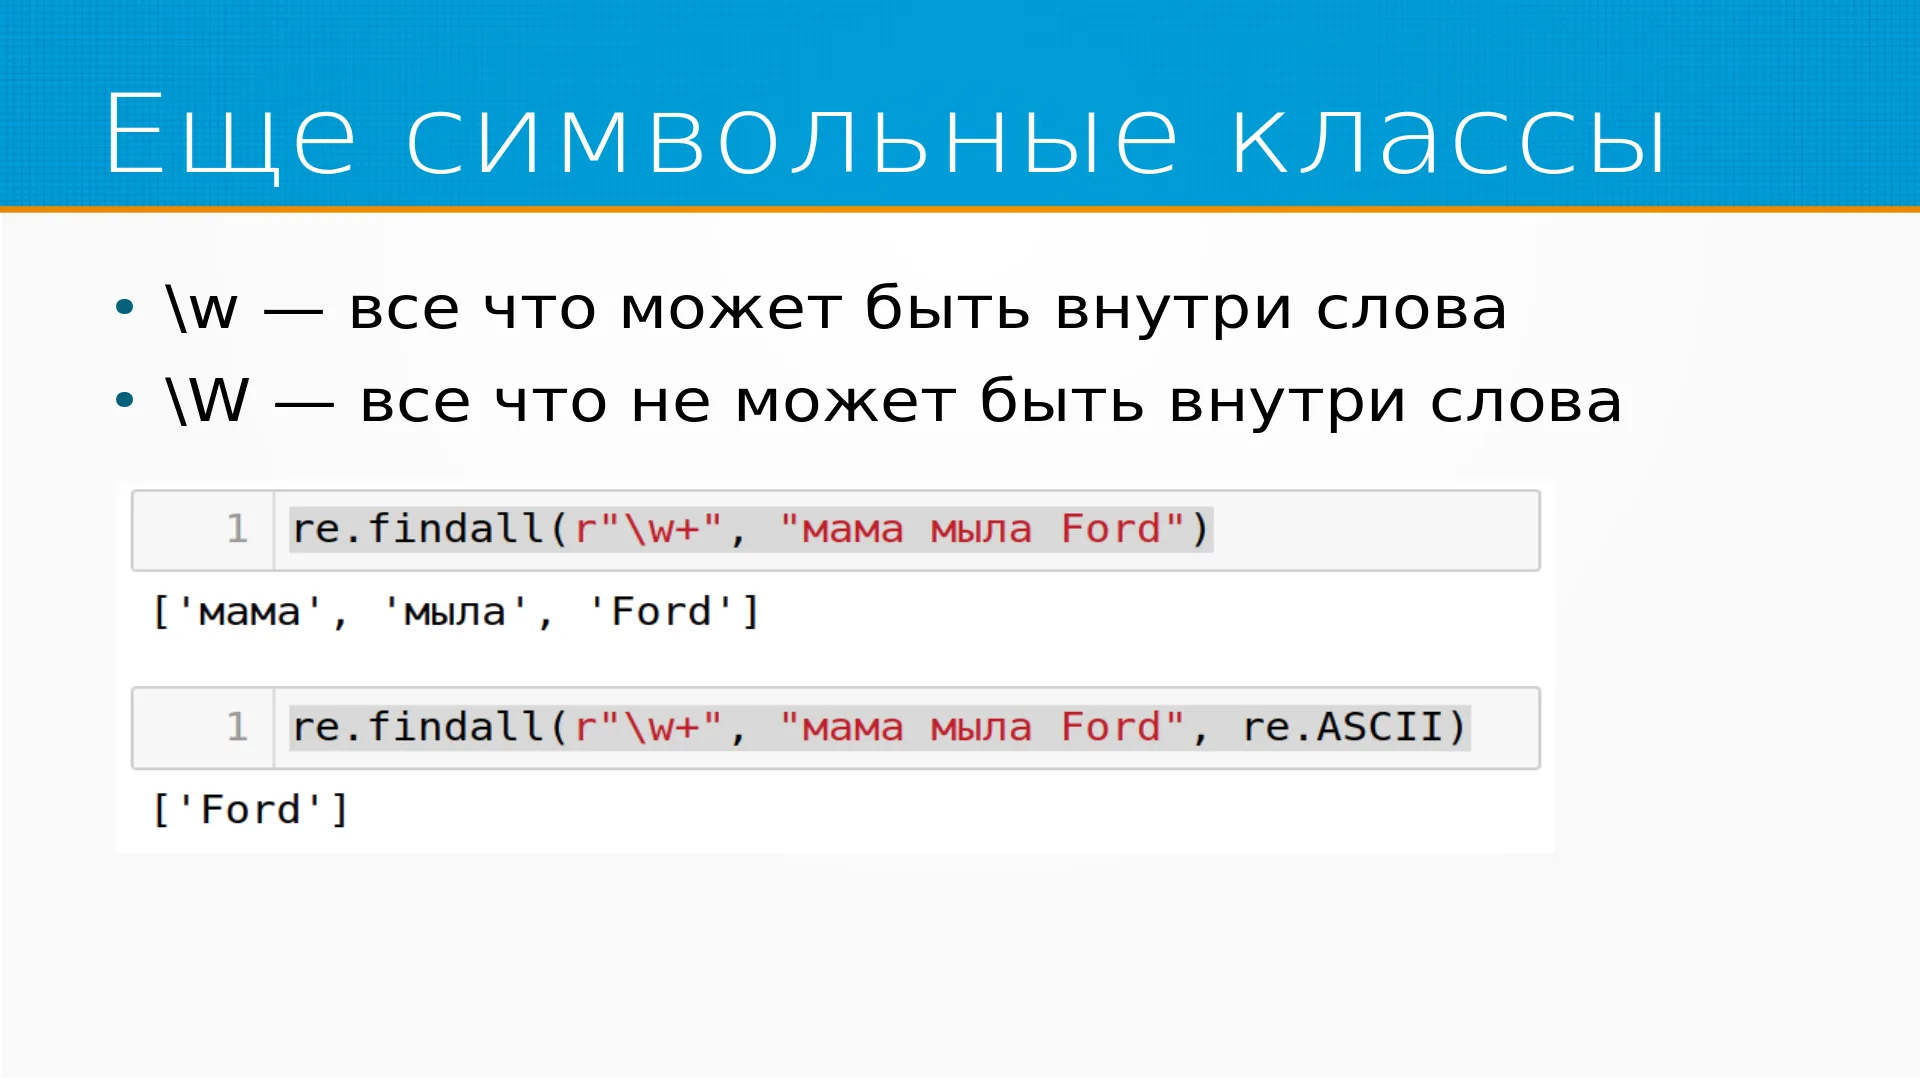
Идём дальше. Ещё символьные классы косая W маленькая - всё, что может быть внутри слова, и W большое - всё, что не может быть внутри слова. Внутри слова может быть буквы или цифры. При этом имеет значение в какой кодировке буквы или цифры. Различаются регулярные выражения, которые работают для Юникода, по умолчанию в третьем Питоне регулярные выражения работают с Юникодными строками. Также регулярные выражения, которые работают только с ASCII-ными строками, то есть с подмножеством Latin-1. И вот мы видим, что если флаг стоит re.UNICODE, который стоит по умолчанию, то у нас находит регулярное выражение три слово: мама, мыло и форт. Если стоит флаг ASCII, то у нас находится только слово форт, потому что с точки зрения регулярных выражений в ASCII-кодировке мама и мыло - это не содержит символов, которые могут быть внутри слова.
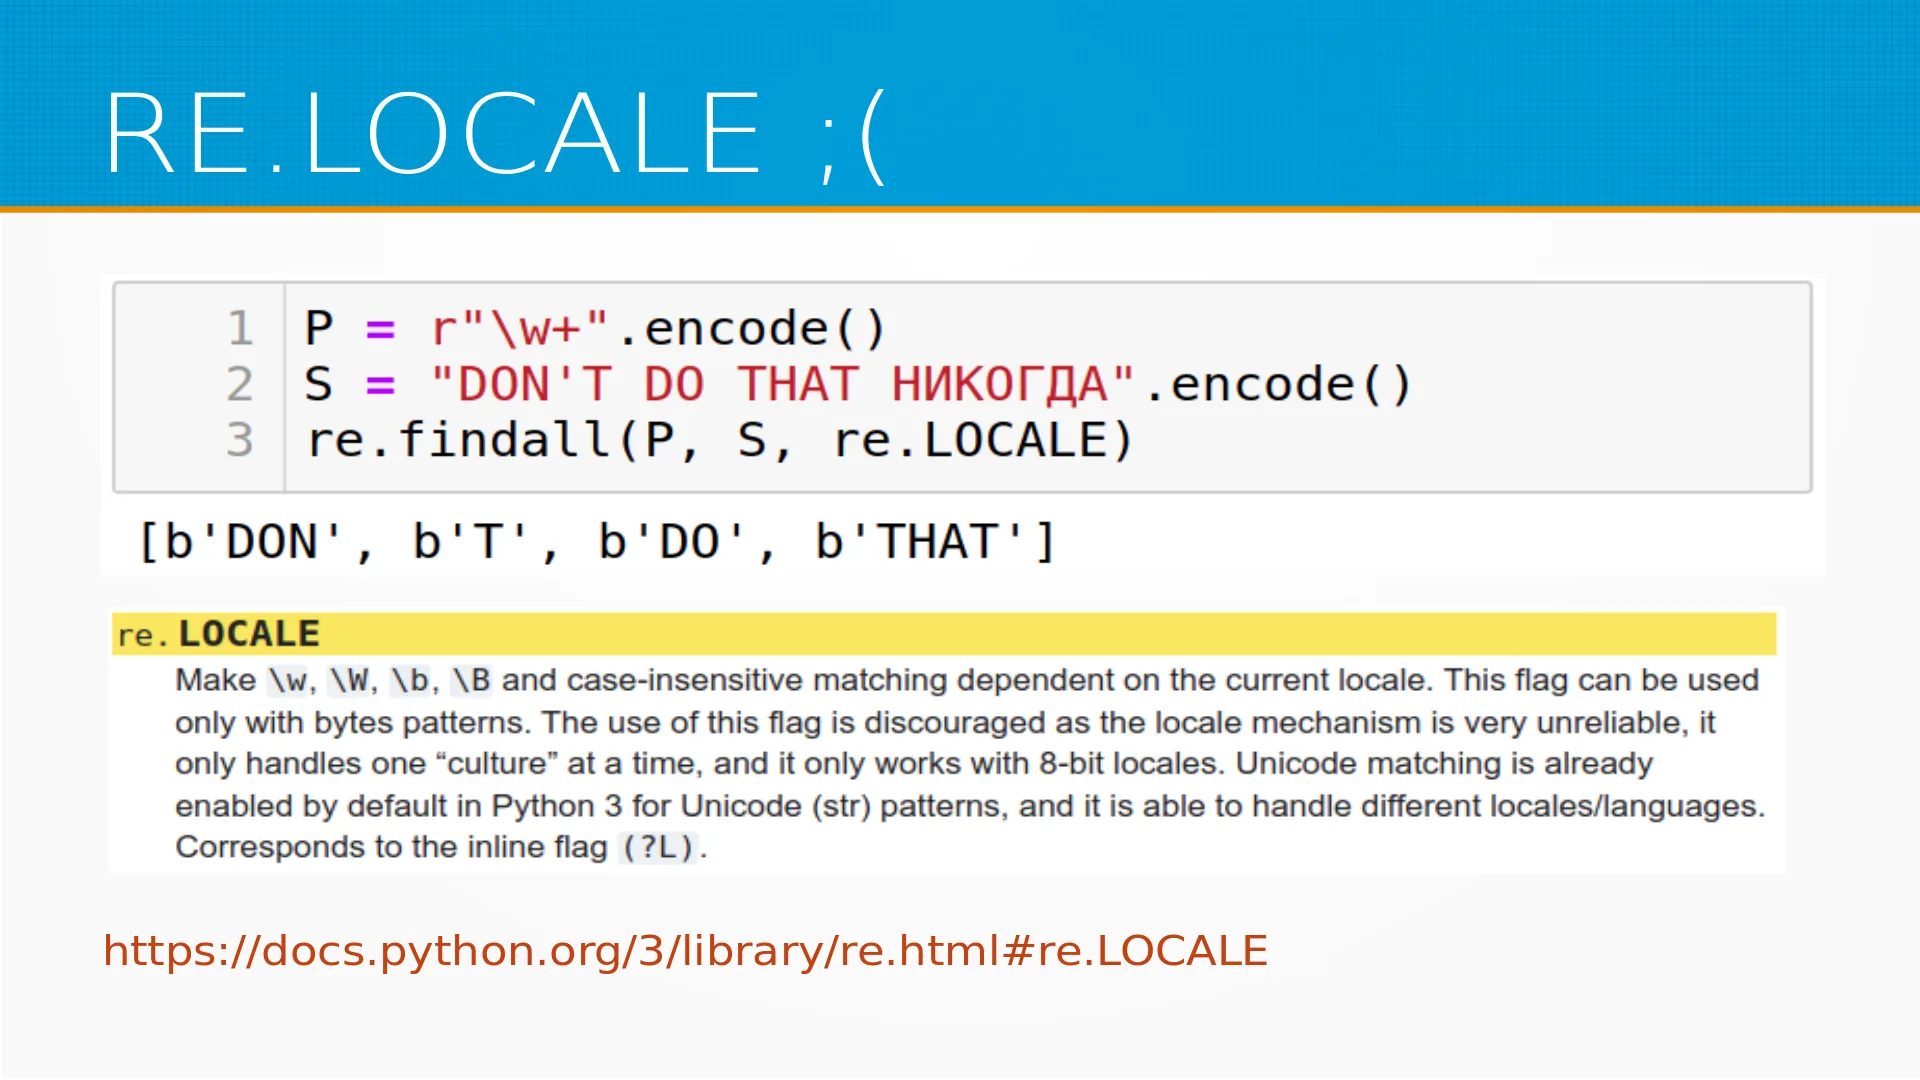
Есть ещё, а, флаг re.LOCALE, который говорит буквально следующее, что используйте текущую локаль. Не Юникодную, не ASCII-ную, а текущую. Но его не надо никогда использовать. Почему? Потому что он работает вовсе не так, как вы ожидаете. Он, во-первых, не работает со строками, он работает с байтовыми последовательностями. Во-вторых, он игнорирует вашу локаль, которую вы пытаетесь установить, и, в принципе, ничем, а, поведение его от ASCII не отличается, кроме того, что вы работаете с байтами. В большинстве случаев re.LOCALE вам не нужен и не пригодится.
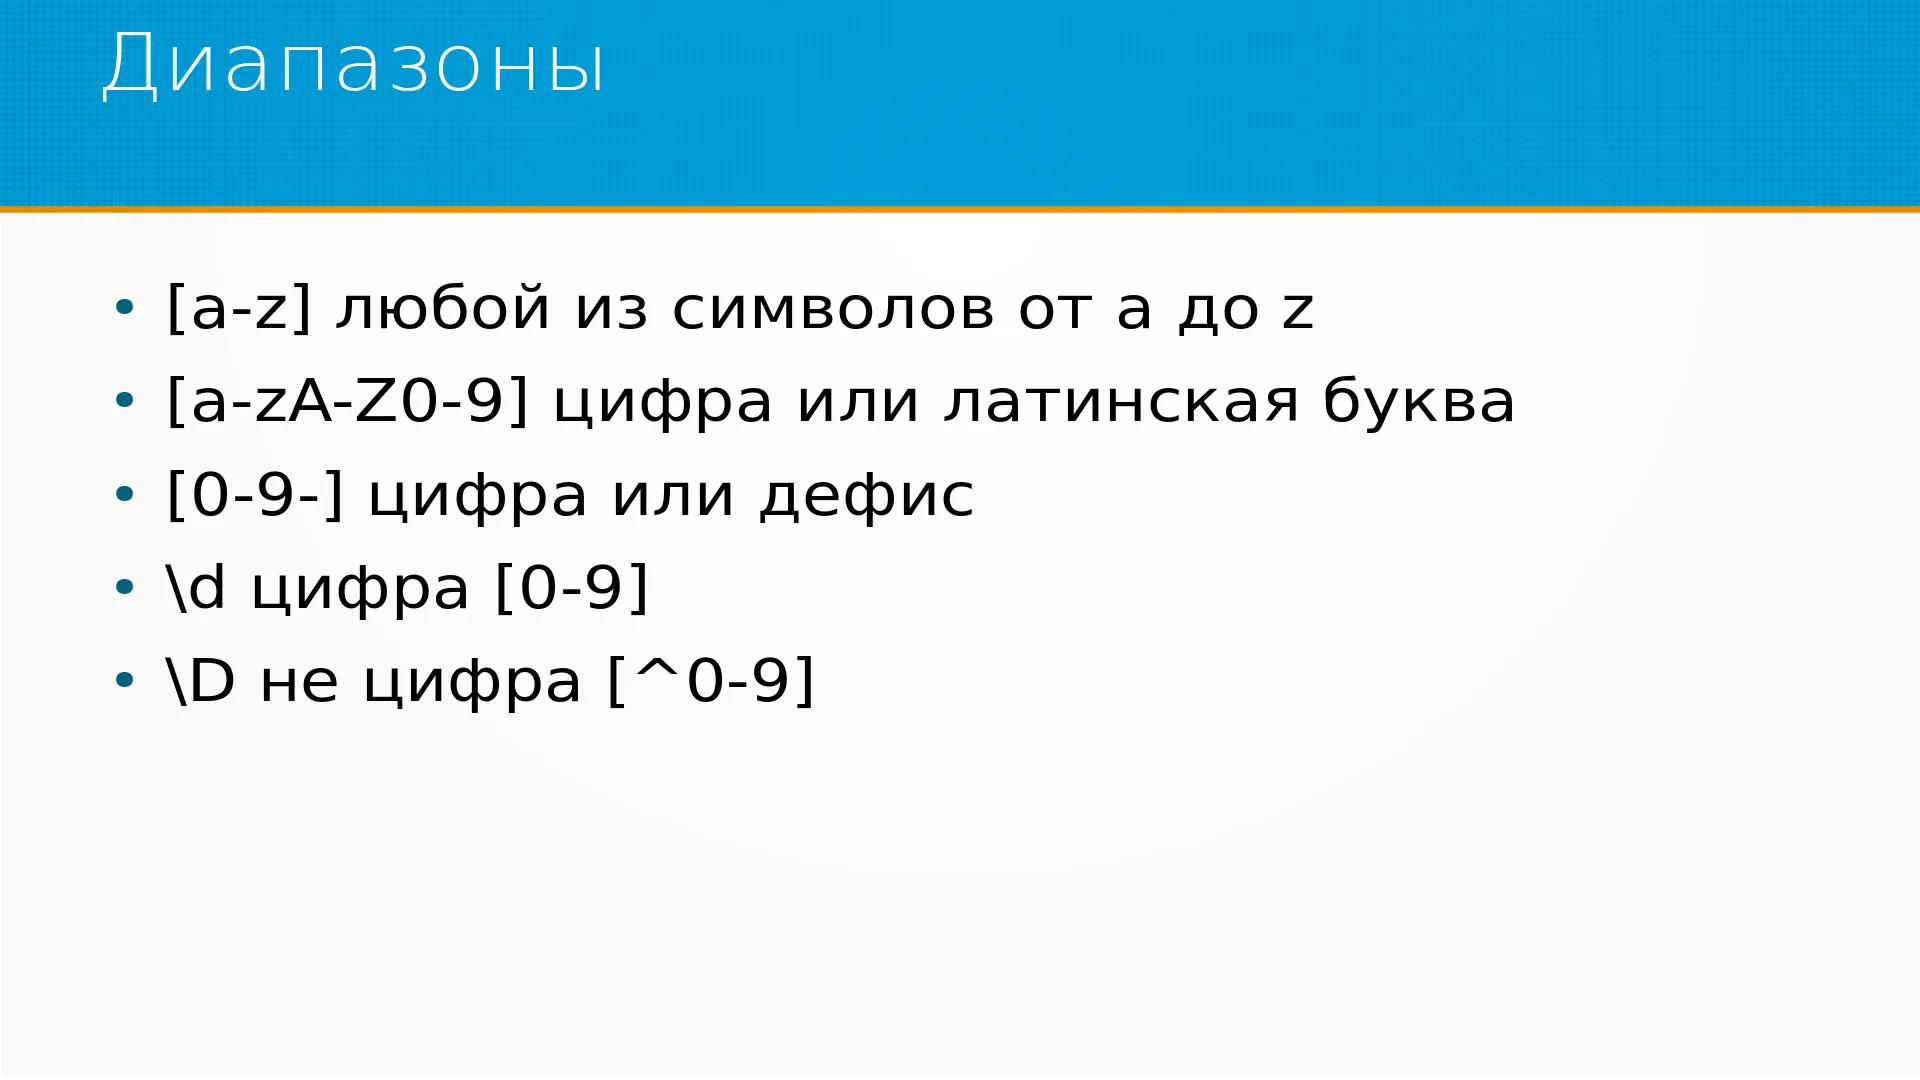
Мы можем задать символьный класс, перечислив все цифры, но если эти цифры идут в алфавите подряд, не в алфавите, на самом деле, а в таблице кодировки, то мы можем задать их диапазоном. Например, от A-Z - это любой из символов, а, в таблице ASCII от A до Z. Конструкция A-Z маленькая, A-Z большая, 0-9 - это цифра или латинская буква. Вот, а, косая D маленькая, тут у меня наехала картинка почему-то на презентацию. Косая D маленькая - это просто, а, диапазон от нуля до девяти. Косая D большая - это диапазон, а, крышечка от нуля до девяти.
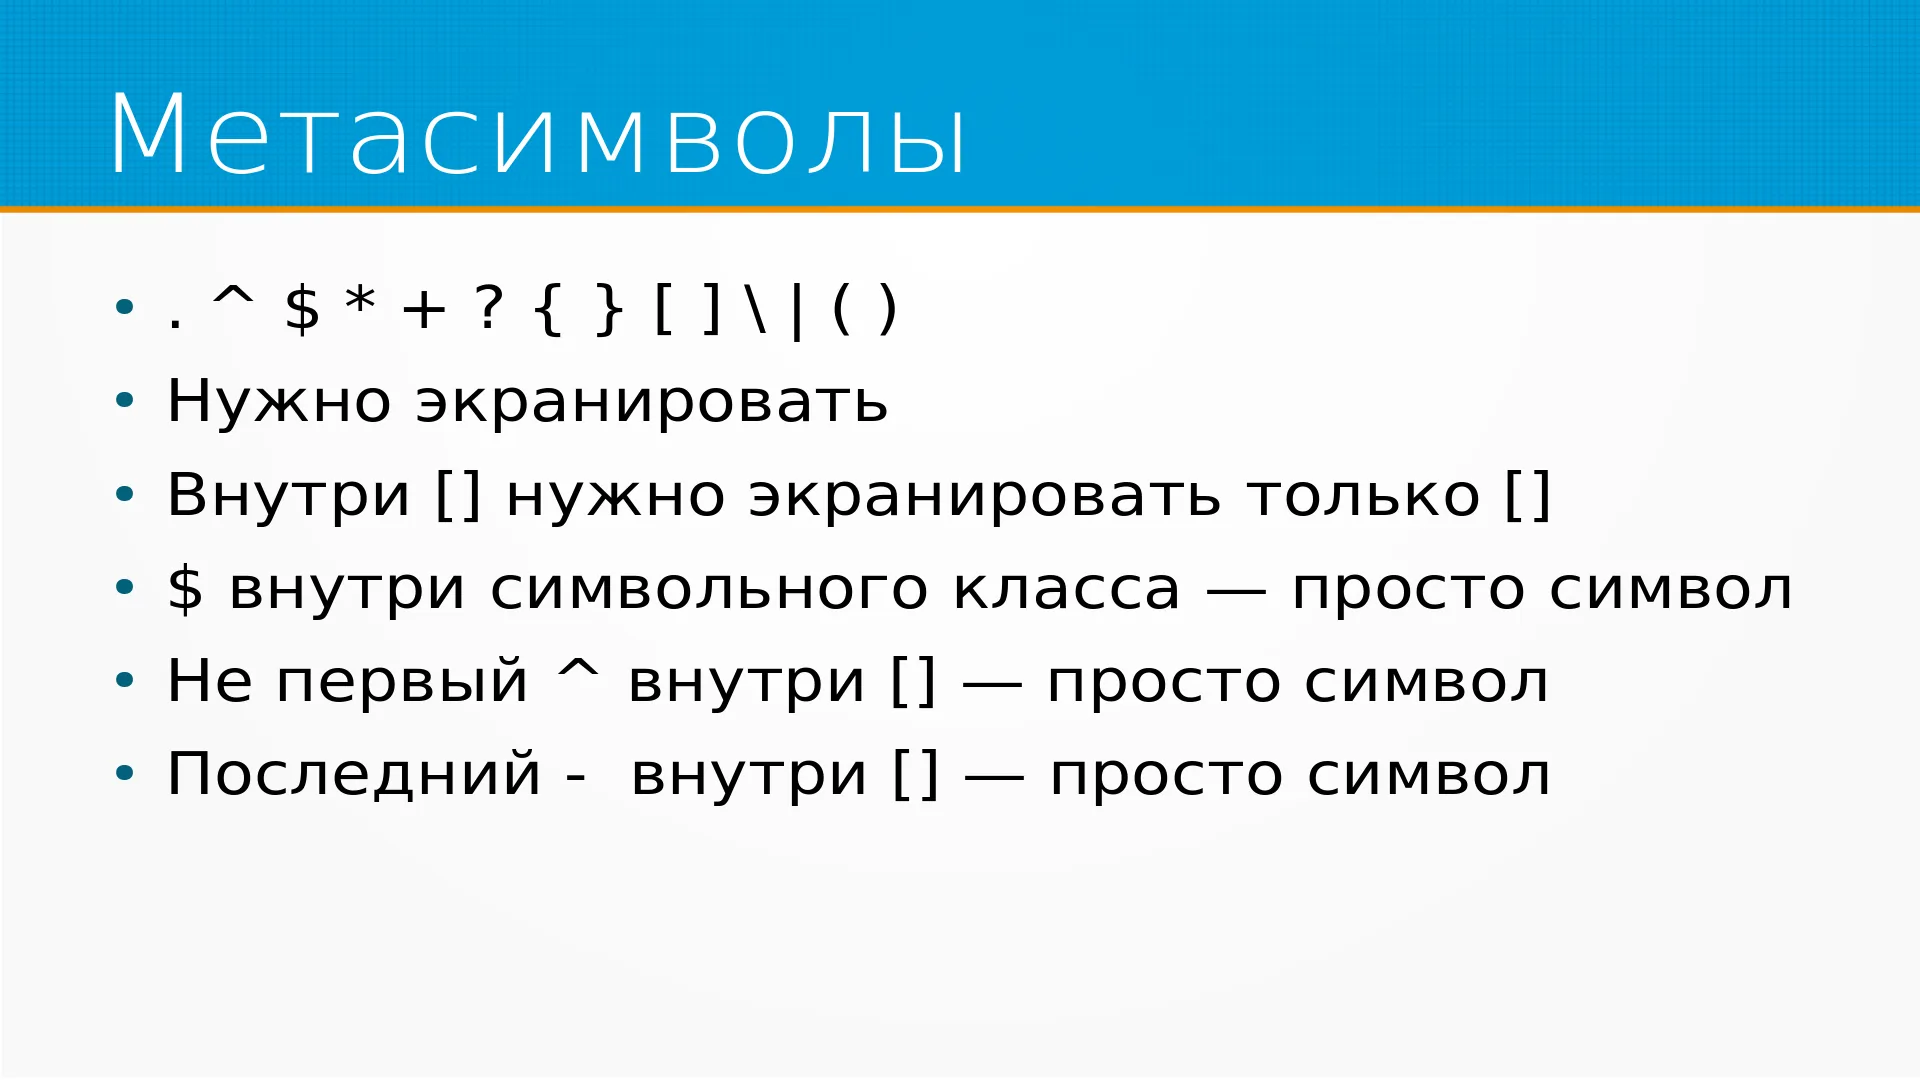
Вот, почему он сюда наехал, непонятно. Ладно, ну слайды готовил второпях. Есть ещё метасимволы. Метасимволы - это символы, которые имеют особенный смысл в регулярных выражениях. Это точка, крышечка, доллар звёздочка. Их нужно экранировать косой. Внутри символьных классов, то есть внутри прямоугольных скобочек, нужно экранировать только сами прямоугольные скобочки. Доллар внутри символьного класса - это просто символ доллара, а в регулярном выражении за пределами символьного класса, за пределами квадратных кавычек - это конец строки. Если внутри крышечек, а, внутри квадратных скобок у нас крышечка, но она не первая, то это просто символ. Если она первая, то это признак того, что символьный класс надо инвертировать. Дефис, если нам его нужно включить в символьный класс, должен включаться последним символом, потому что иначе он рассматривается как, а, диапазон, как указание на диапазон.
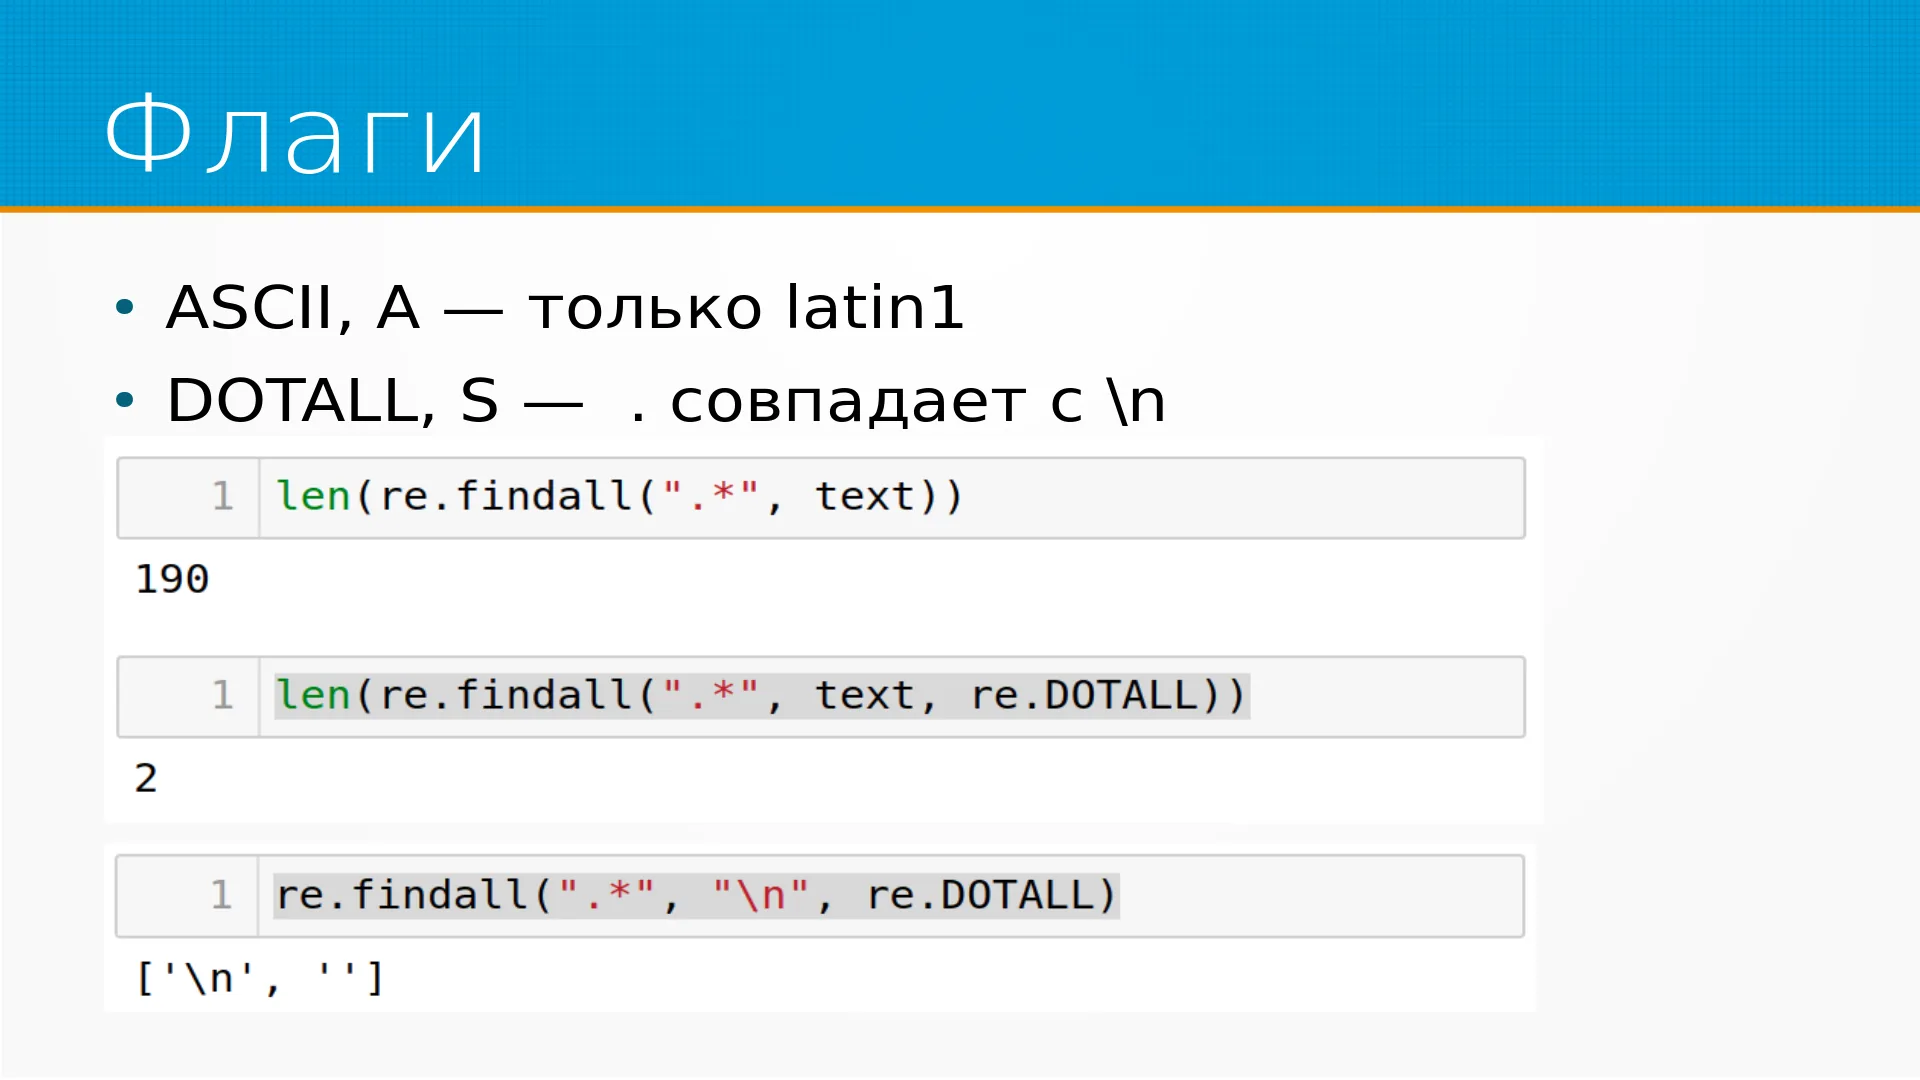
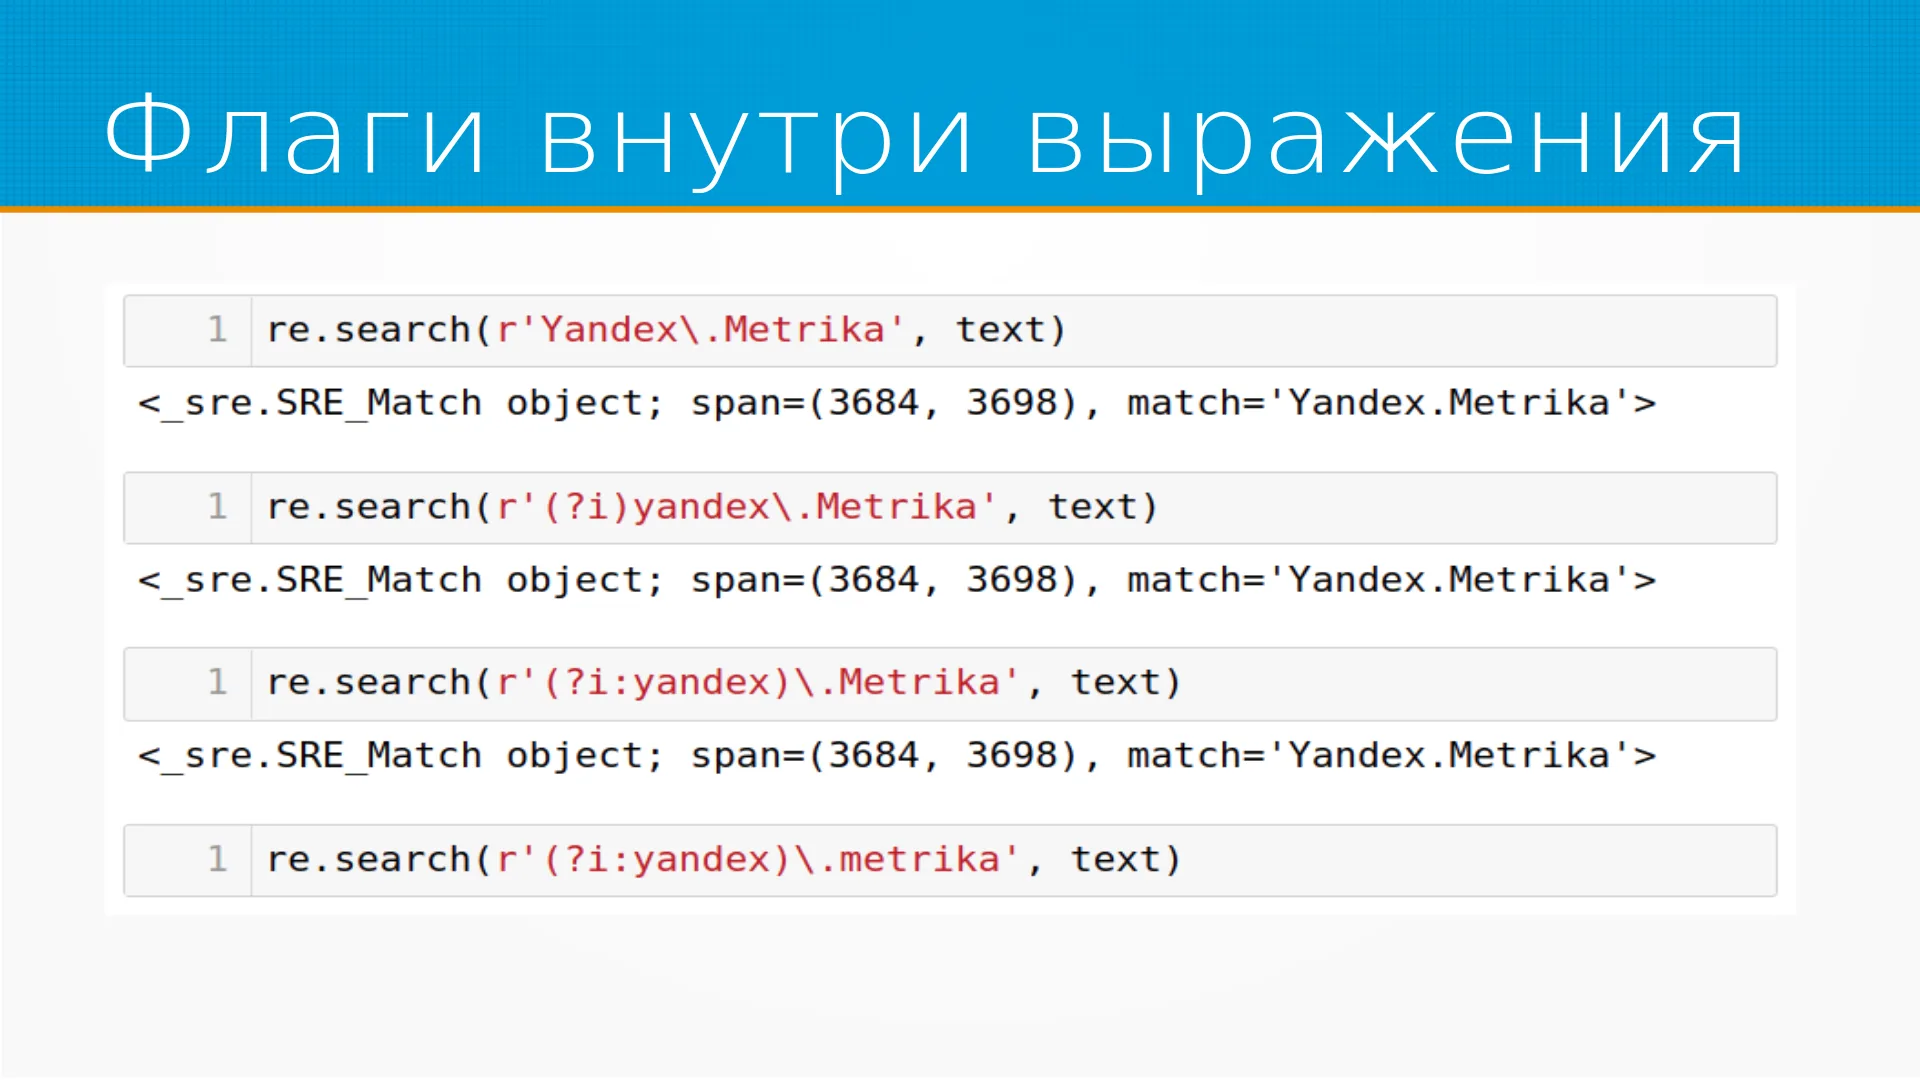
Кроме того, мы можем указывать флаги, которые управляют тем, как наше регулярное выражение обрабатывается. Мы с ними уже сталкивались. У флагов обычно есть длинное и короткое написание, короткое, если вы хотите сэкономить несколько байтов, пальцы печатать устали. ASCII заставляет рассматривать процессор регулярных выражений ваш текст, как будто слова в нём могли быть только из Latin-1 кодировки. Dot all после при установке этого флага точка начинает совпадать с переводом строки. Флаги можно комбинировать, это бинарные маски, мы можем их через OR складывать. Если нам нужно несколько флагов добавить, можем просто их сложить. Видно, что, например, если мы ищем комбинацию любой символ сколько угодно раз, то в нашем тексте сайта найдётся 190 групп.
Потому что они не будут, они будут искать только внутри каждой строки, то есть там 190 строк, и каждая из строк будет найдена отдельно. Если мы же ему скажем, чтобы он совпадал с переносами строки тоже, то будет найдено две строки неожиданно, не одна, а две. Шутка тут в чём? Второй строкой, которая совпаст, совпадёт в этом регулярном выражении, будет конец файла, end of file. Вот, у меня нет внятного объяснения, почему это именно так. В общем, в это надо верить, про это надо помнить. Вот ниже такой простой убедительный пример. Re.findall точка звёздочка с со строкой из одного единственного символа перевод строки совпадает два раза.
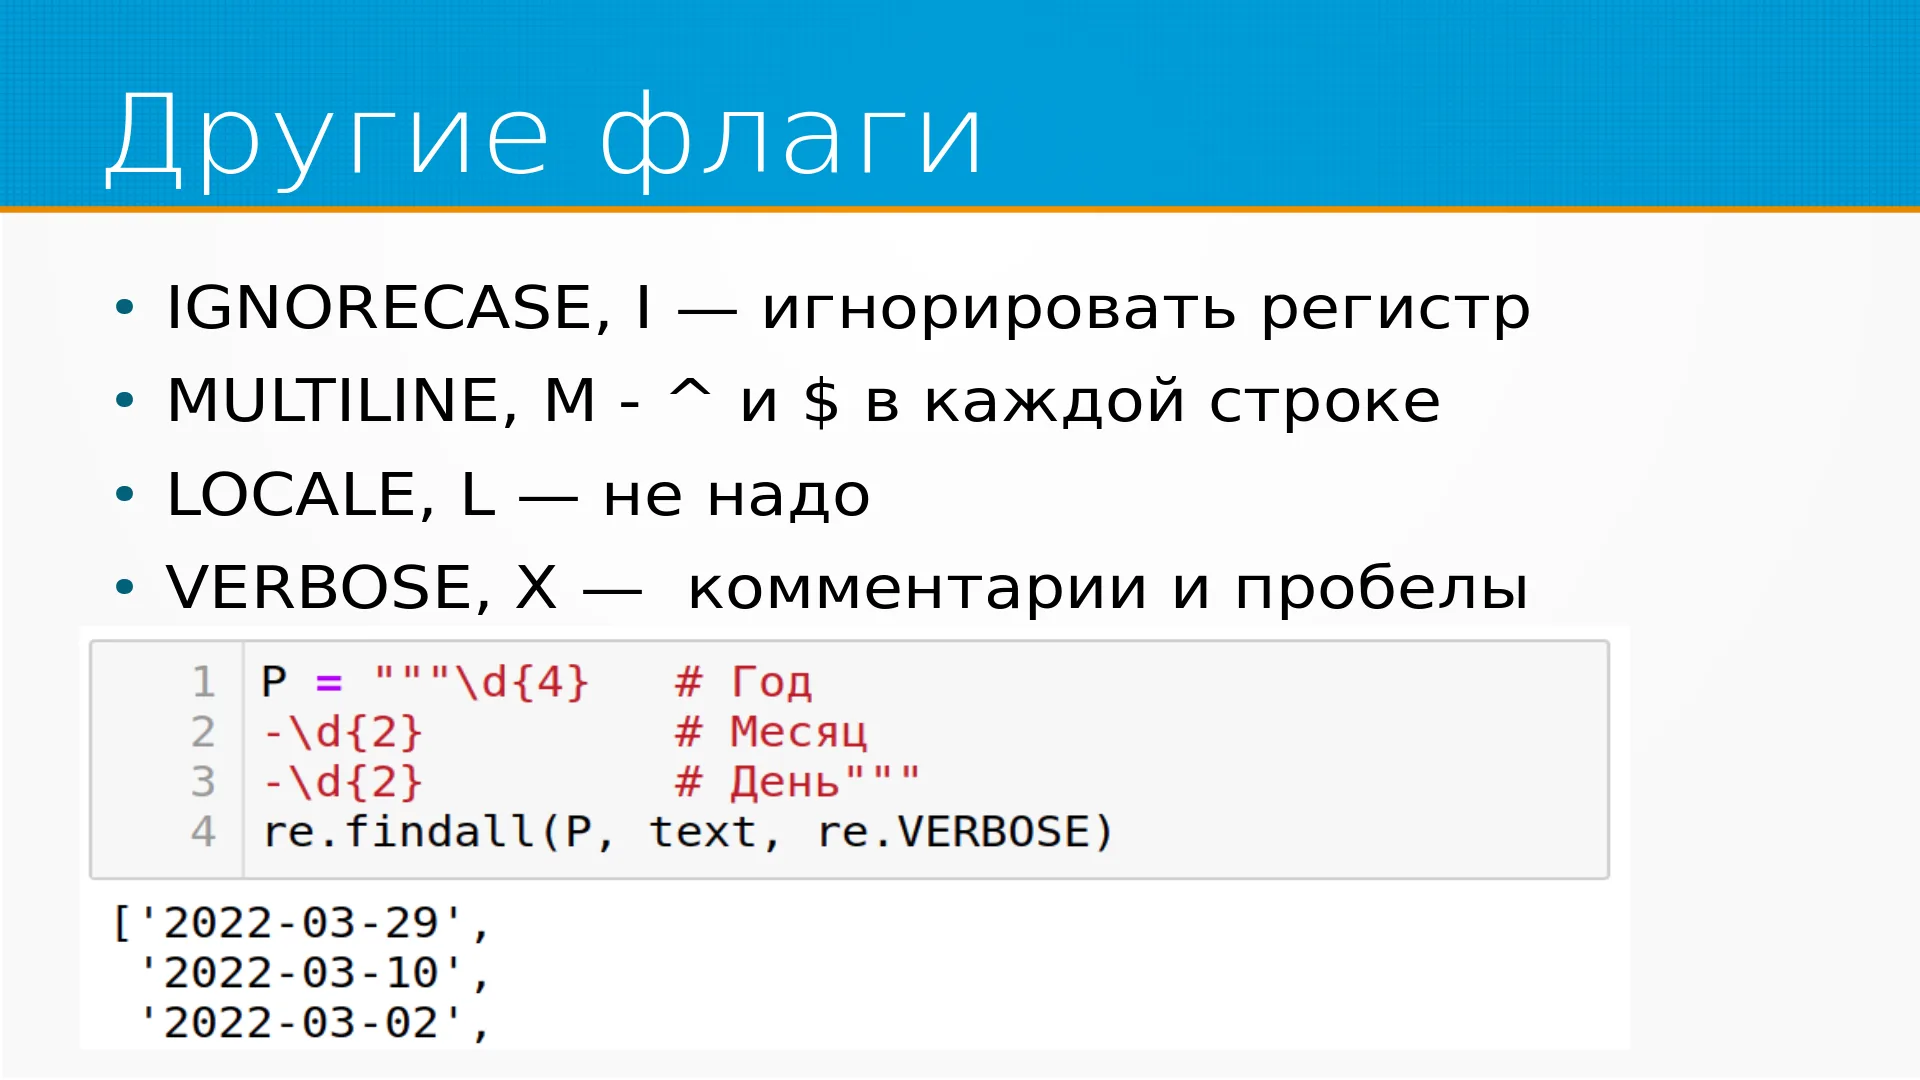
Один раз собственно вся строка, а второй раз end of file в конце. Другие файлы. Ignore case самый простой флаг - это игнорирует регистр. По умолчанию они регистрозависимые. Multiline управляет тем, как работают крышечка и доллар. Срабатывают они в каждой строке или только в начале строки текста. LOCALE мы договорились не использовать, а флаг VERBOSE, он позволяет писать регулярное выражение, как будто это у нас такая большая взрослая программа с комментариями, и пробел в регулярном выражении игнорируется в таком случае. Если нам нужно вставлять пробелы, а, мы должны вставлять класс косая S, например.
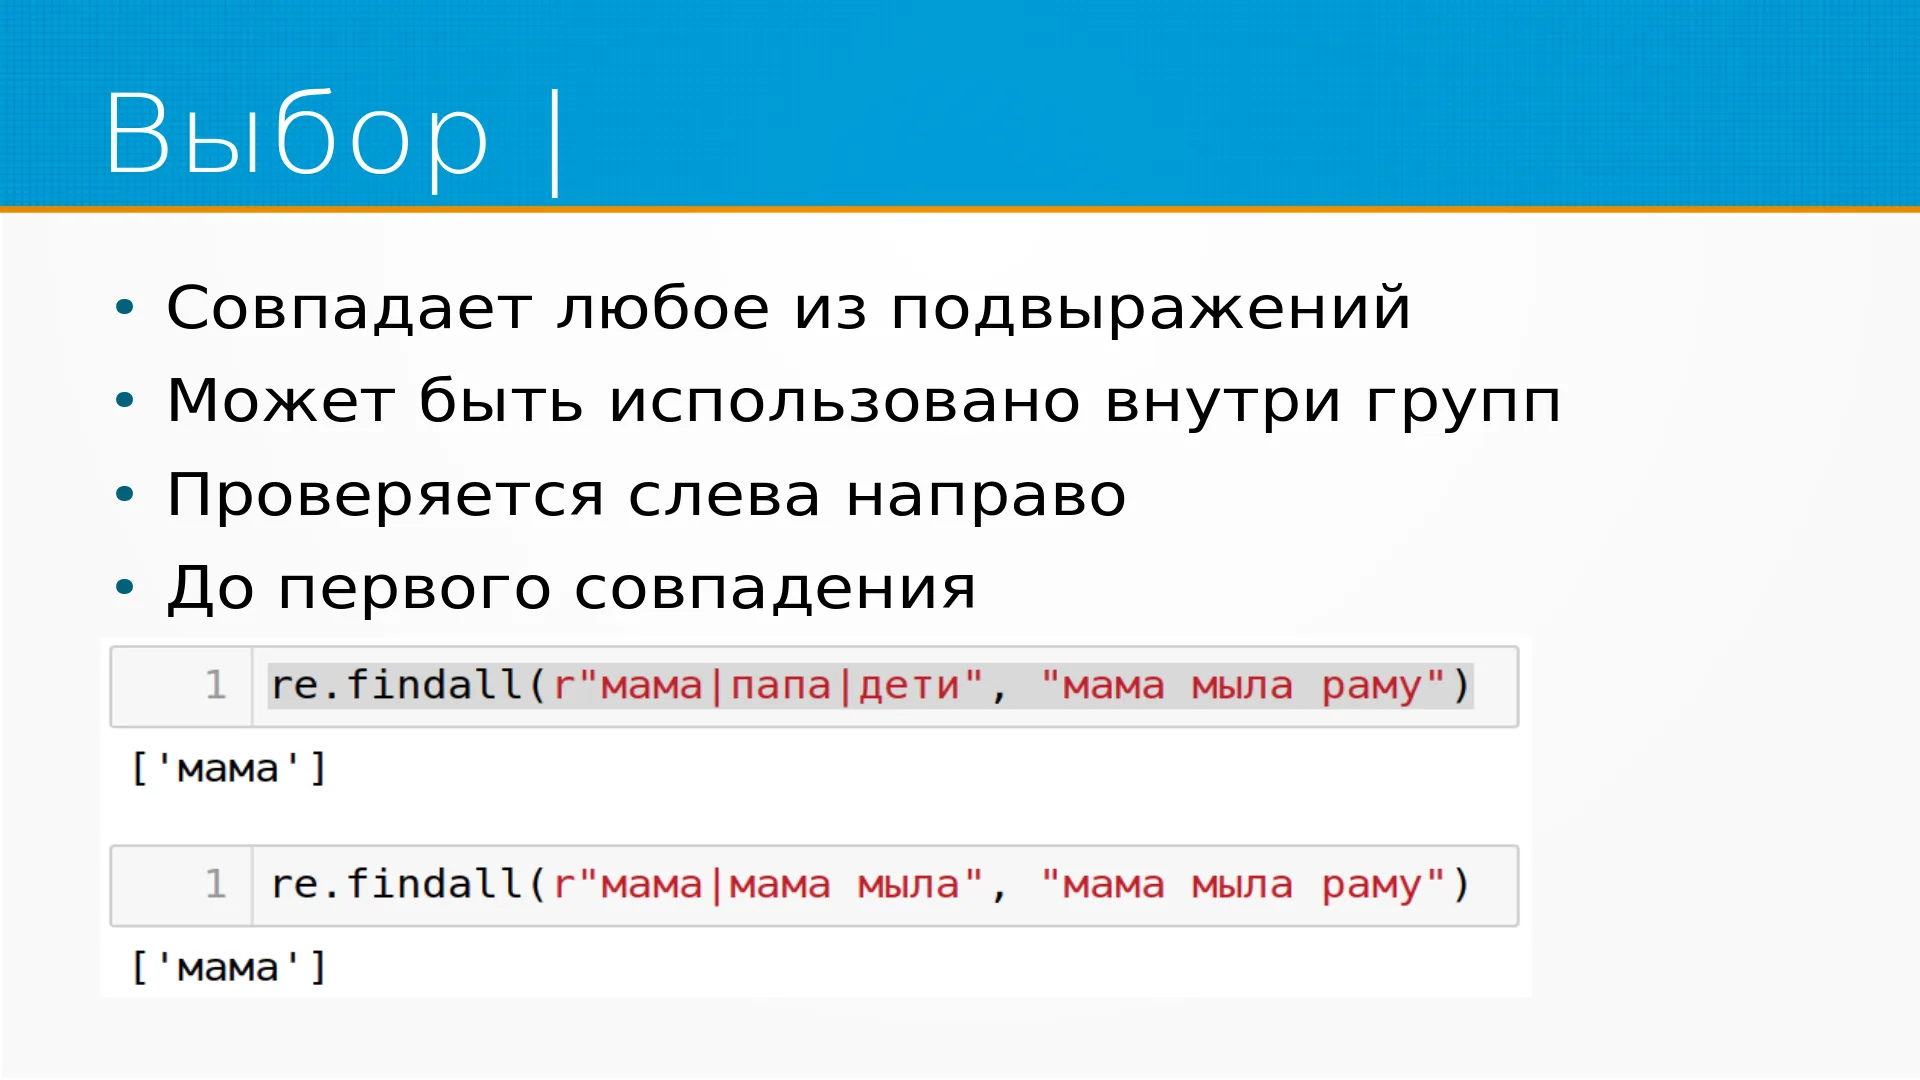
Есть способ указывать шаблон выбора, когда совпадает одно из нескольких регулярных выражений на выбор, какое повезёт. Это вертикальный пайп, может быть использован внутри групп. Они проверяются слева направо и проверяются до первого совпадения. Если у вас есть несколько регулярных выражений и совпасть может несколько, например, мама мыло или мама, то совпадёт то, которое стоит первым в этом списке. Они слева направо проверяются. Это поведение совпадает с тем, как работает OR в языках программирования, до первого true.
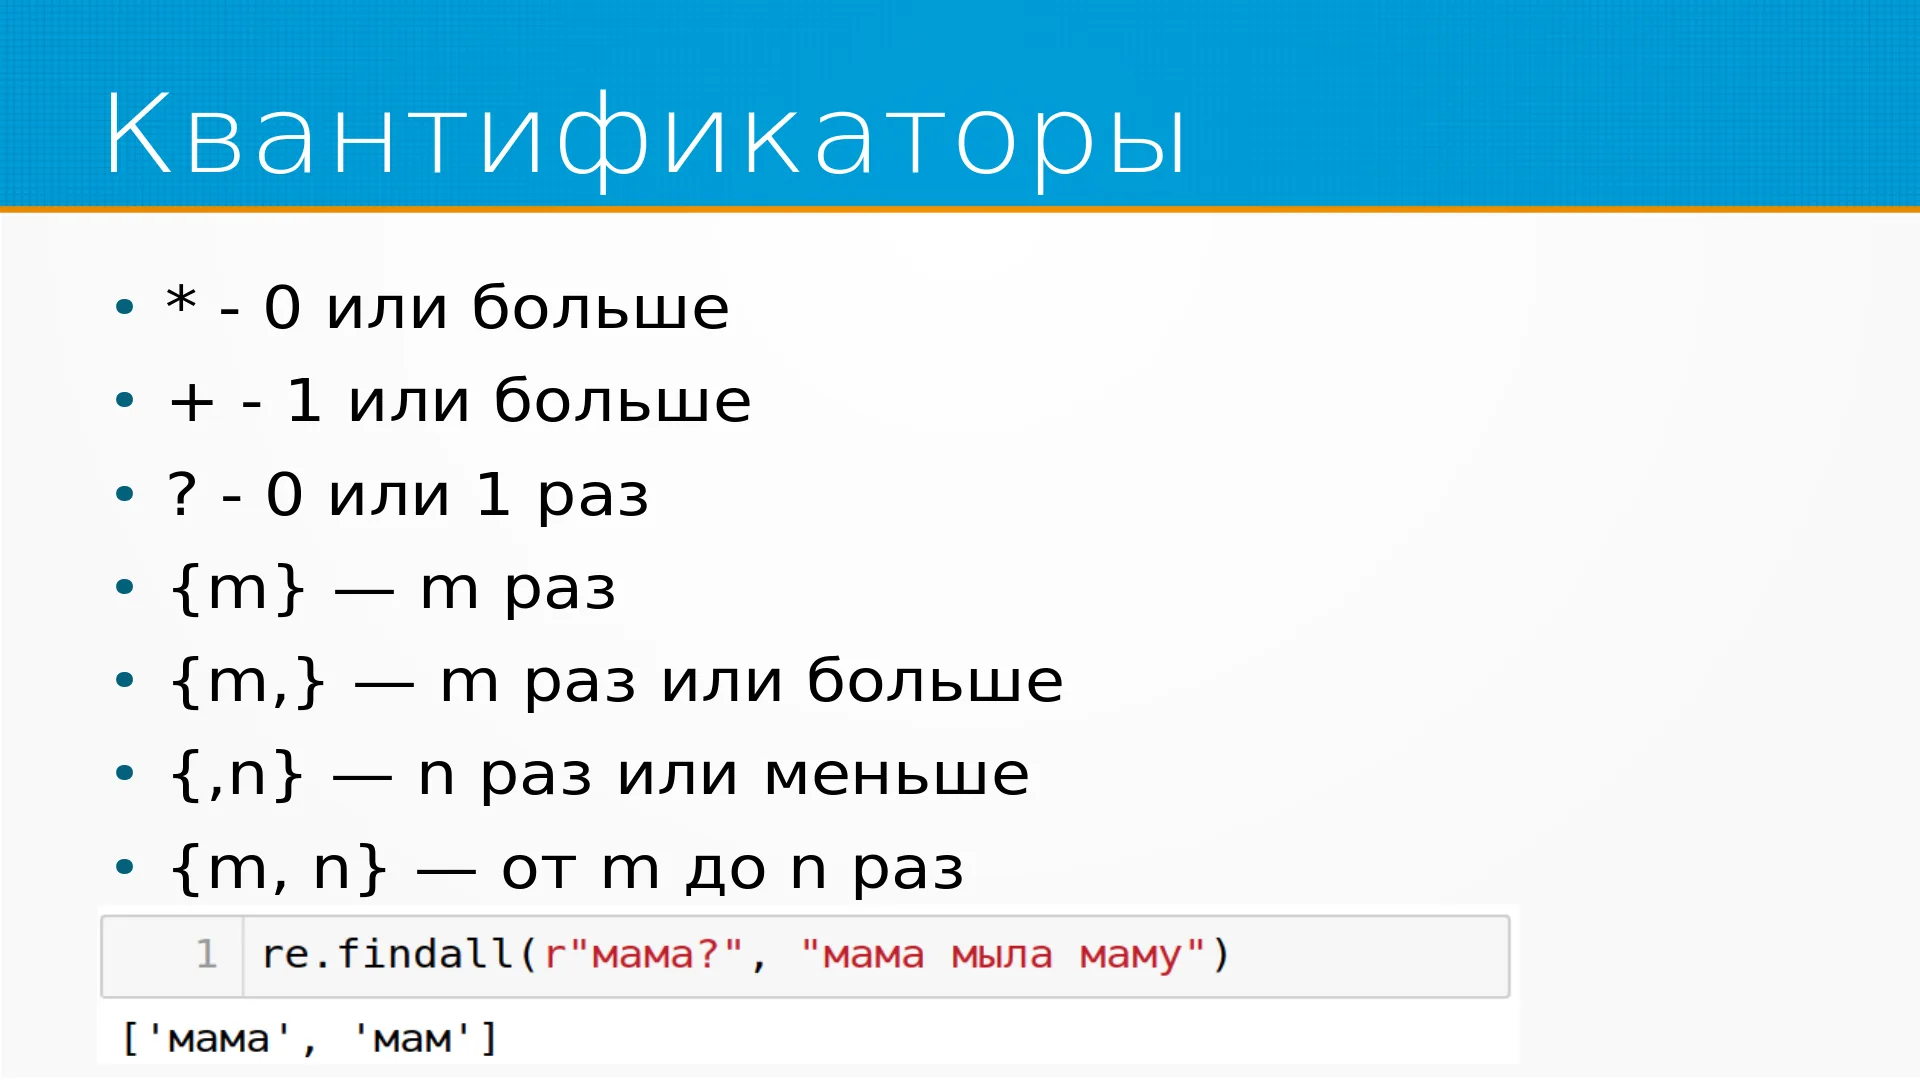
Короткозамкнутое поведение. Символьные классы могут несколько раз повторяться. Например, здесь у нас число повторяется четыре раза, два раза, цифра повторяется четыре, четыре, четыре, два, два раза. Символ, который указывает, сколько раз повторять число, называется квантификатором. Квантификатор звёздочка означает, что у нас ноль или больше повторений, плюс - один или больше повторений, вопросительный знак - ноль или одно повторение. И можно указывать точное количество повторений или некоторый диапазон повторений в круглых скобках. В оригинальных регулярных выражениях, по-моему, были только звёздочки. И, может быть, вопросительные знаки или только звёздочки, те регулярные выражения, которые придумали математики. Но когда программисты до них дорвались, они наделали синтаксического сахара. В общем, например плюс из звёздочки получается, плюс - это в чистом виде синтаксический сахар, он получается, а, добавлением какого-нибудь символа слева от к выражению со звёздочкой.
Вот, он, например мама вопросительный знак совпадает с мама и мам в слове маму.
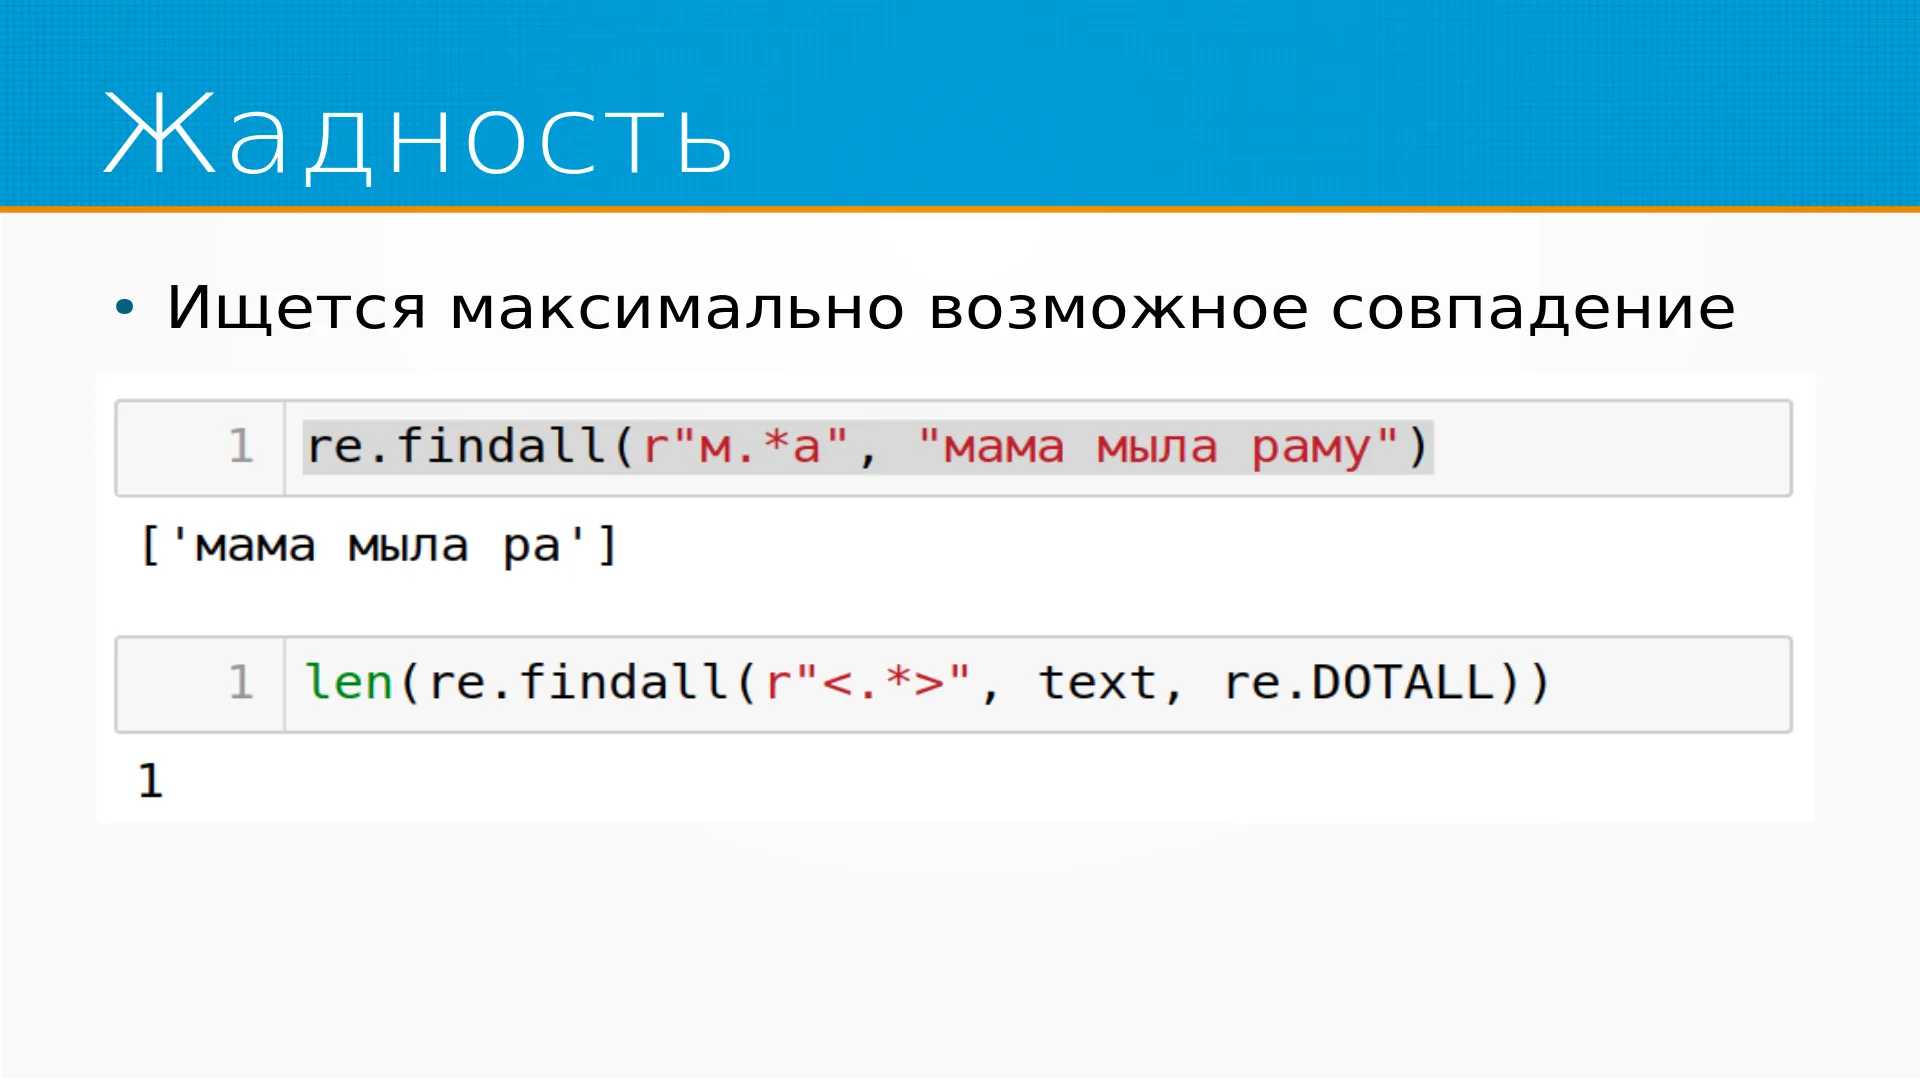
Регулярное выражение по умолчанию жадное. Жадность означает, что ищется максимально возможное совпадение. Например, регулярное выражение M точка звёздочка А совпадёт в слове мама мыла раму с фразой, а, с под строкой мама мыла ра. Жадным быть очень быстро, это позволяет быстро считать эти самые регулярные выражения, но часто приводит к неожиданным результатам. Например, вот ниже регулярное выражение, которое ищет тег в угловых скобках, оно просто совпадёт со всем файлом сразу. Начиная от первой угловой скобки и кончая до второй, до последней.
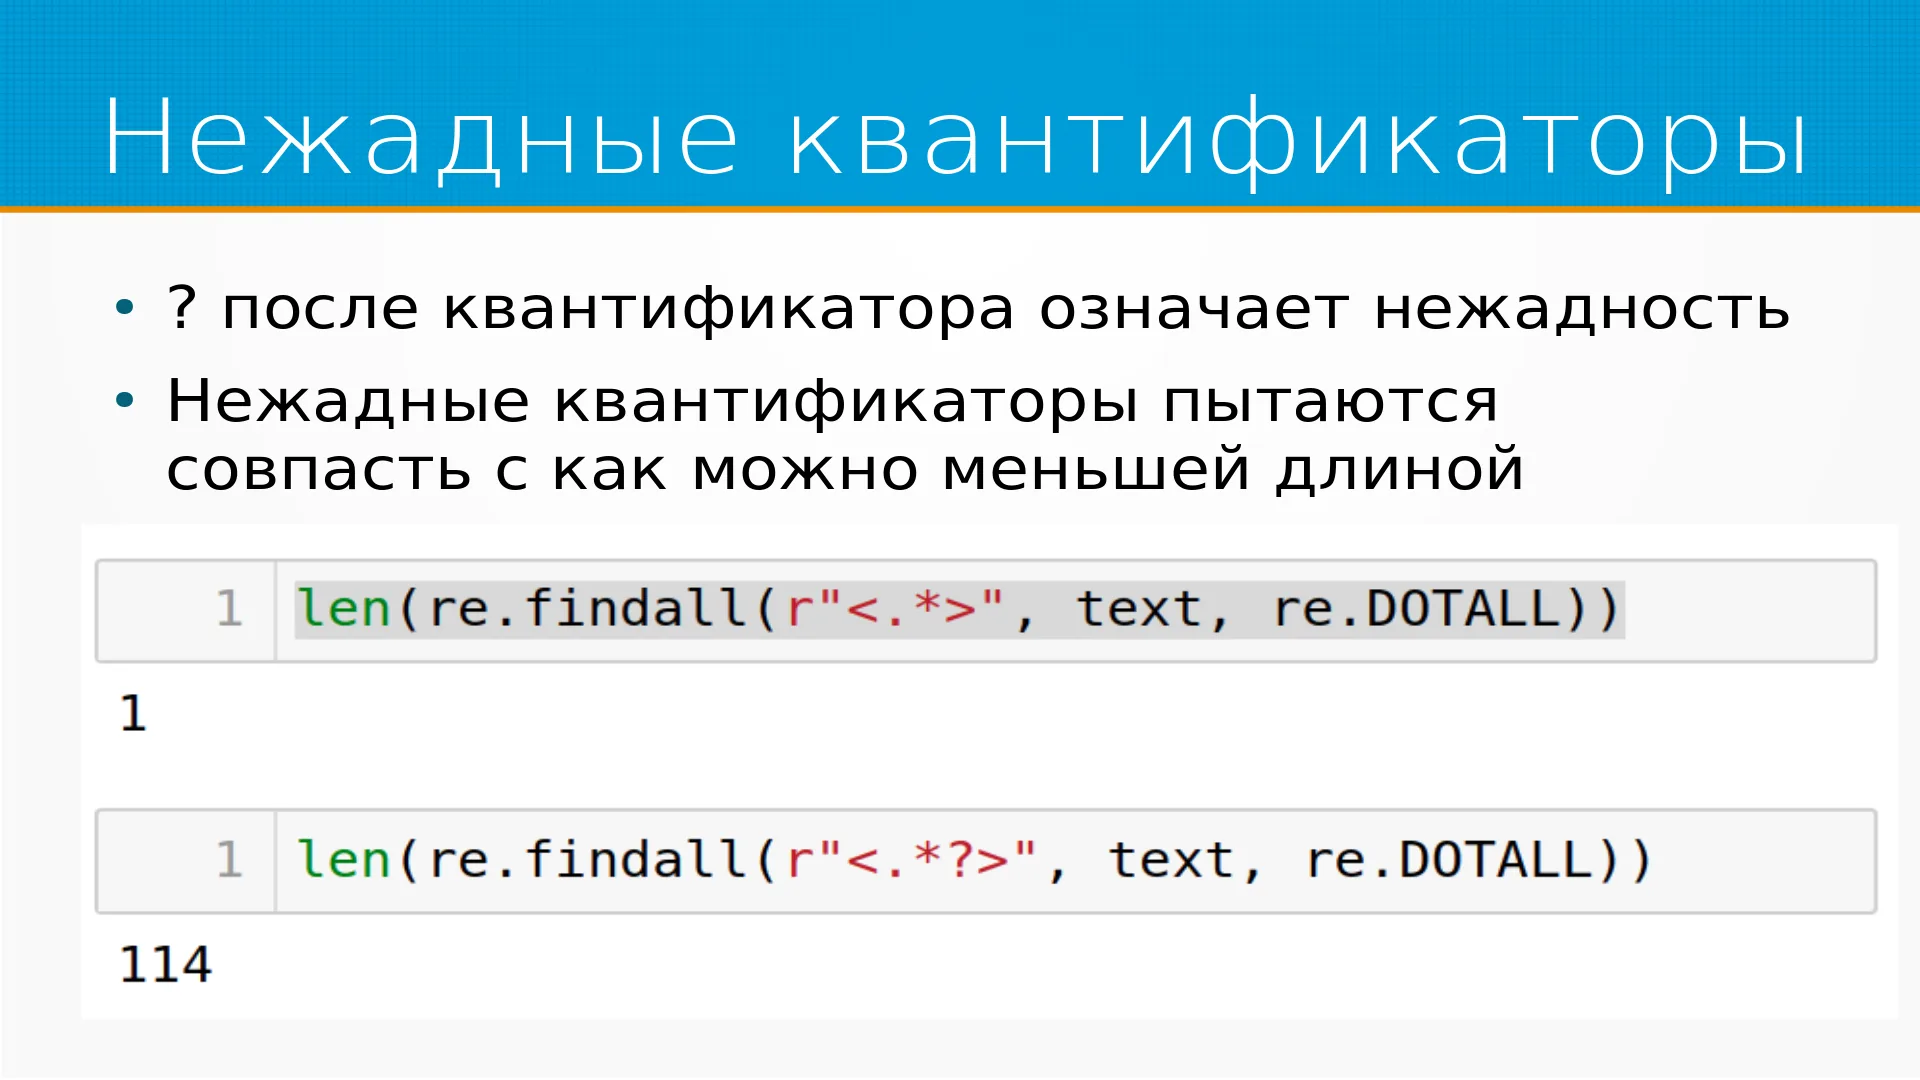
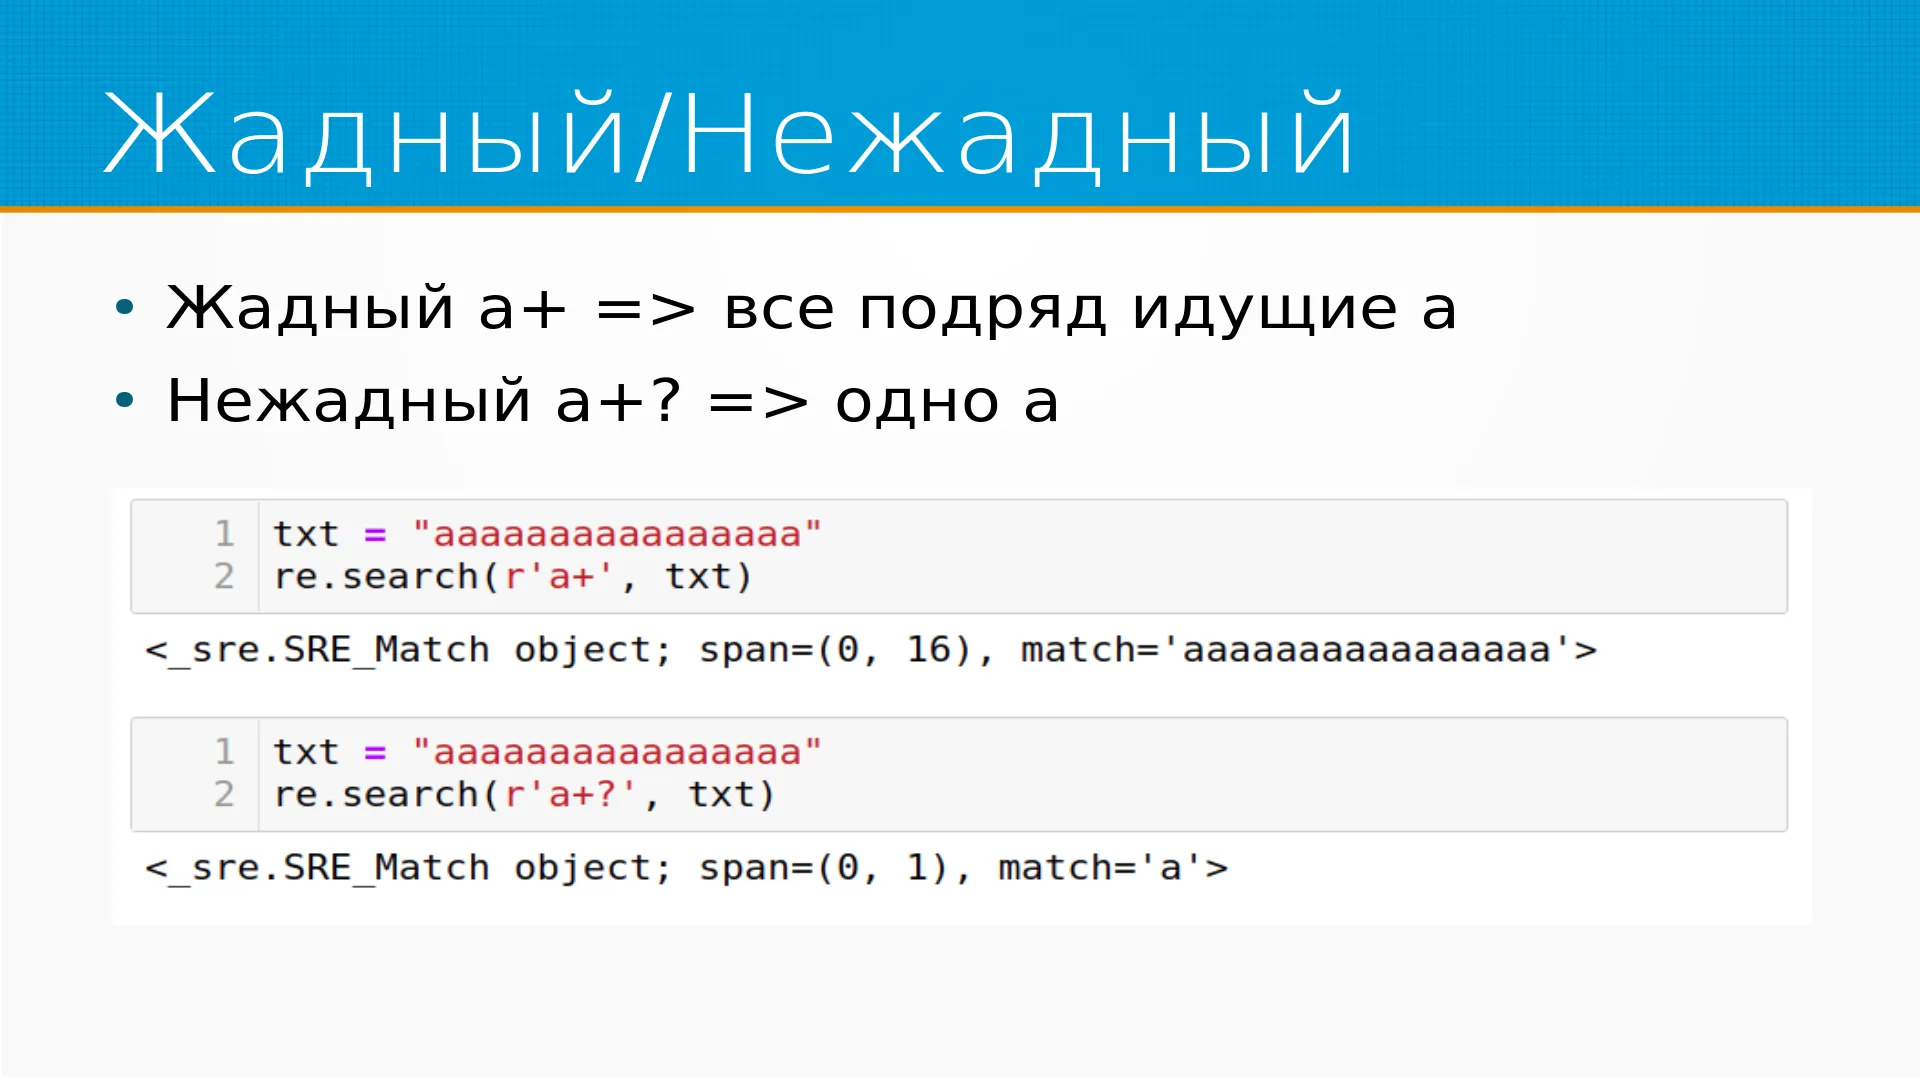
Если же мы хотим вытаскивать теги по одному, то нам нужно использовать нежадные квантификаторы. Вопросительный знак, если он поставлен после другого квантификатора, означает нежадность. Нежадные квантификаторы пытаются совпасть с как можно меньшей строкой. Вот, например, а, жадный квантификатор точка звёздочка совпадает со всем файлом, а нежадный точка звёздочка вопрос совпадает с каждым тегом по отдельности.
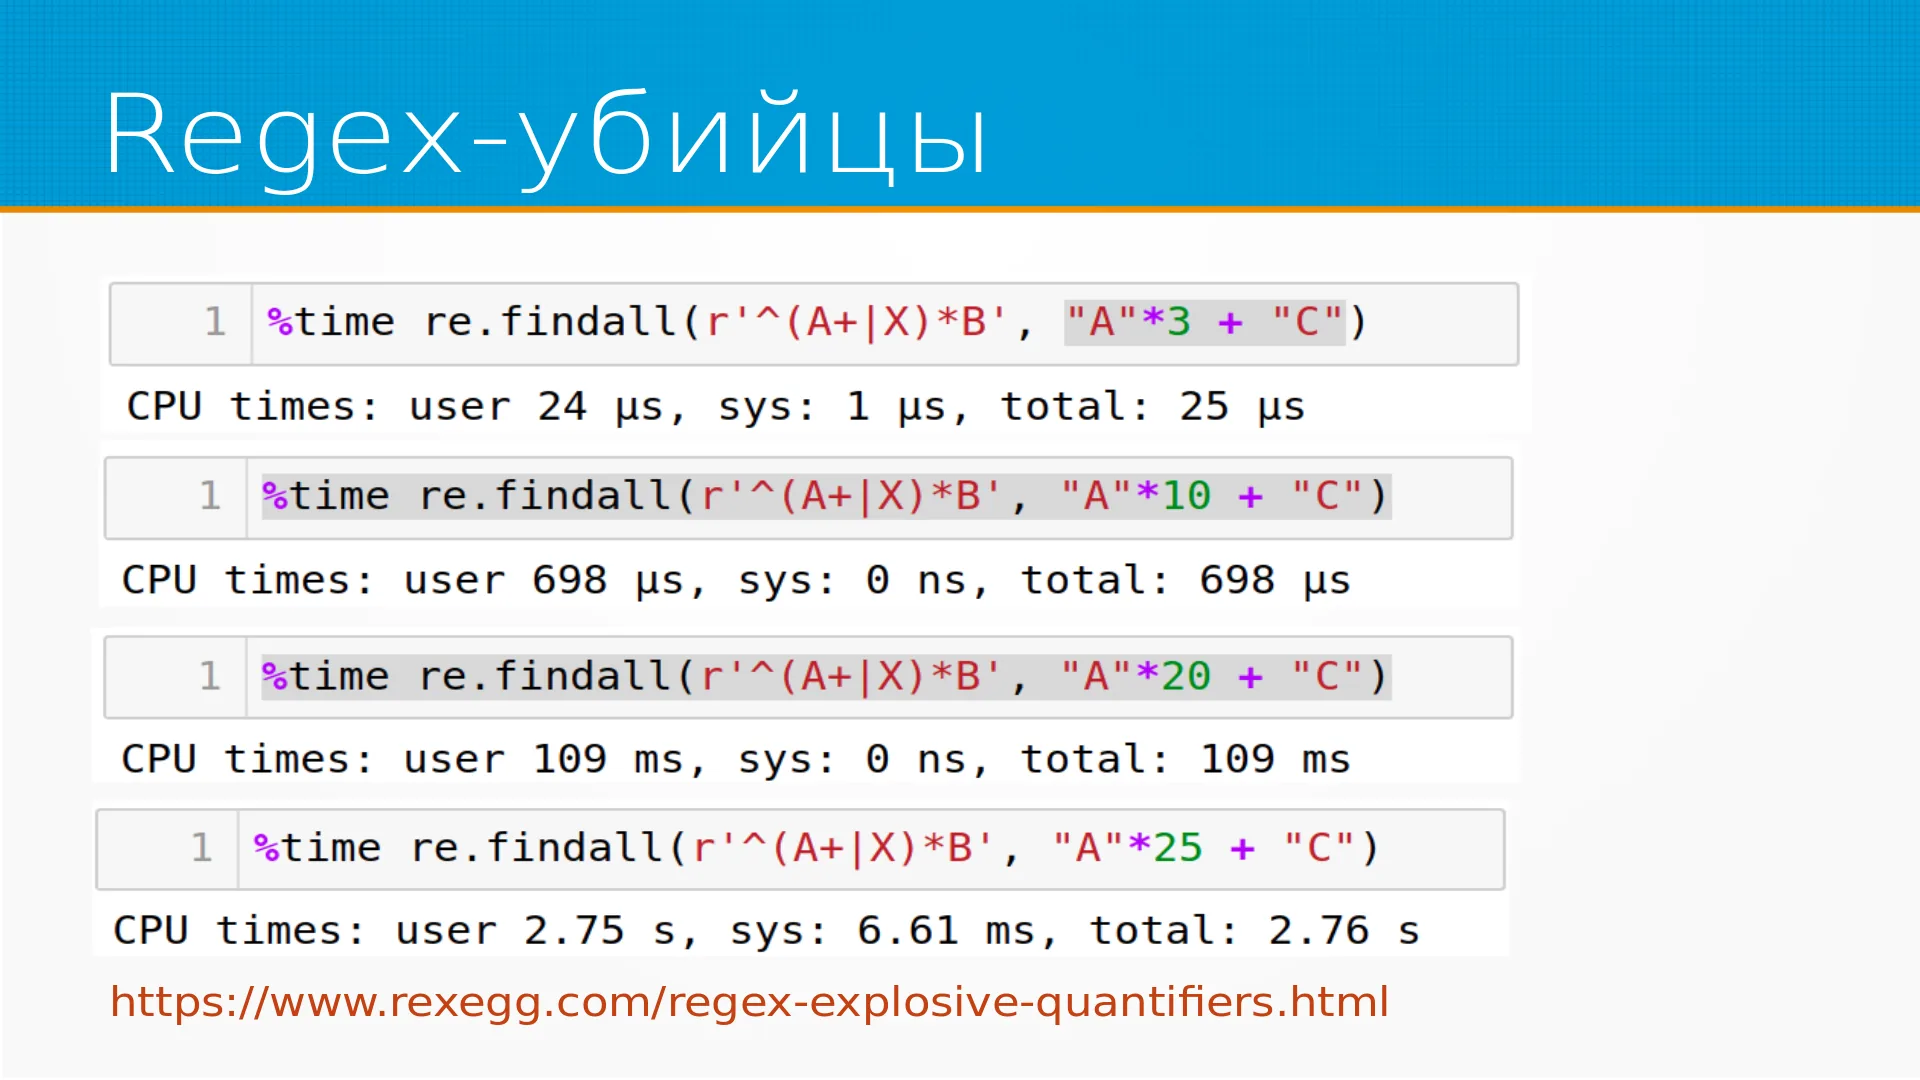
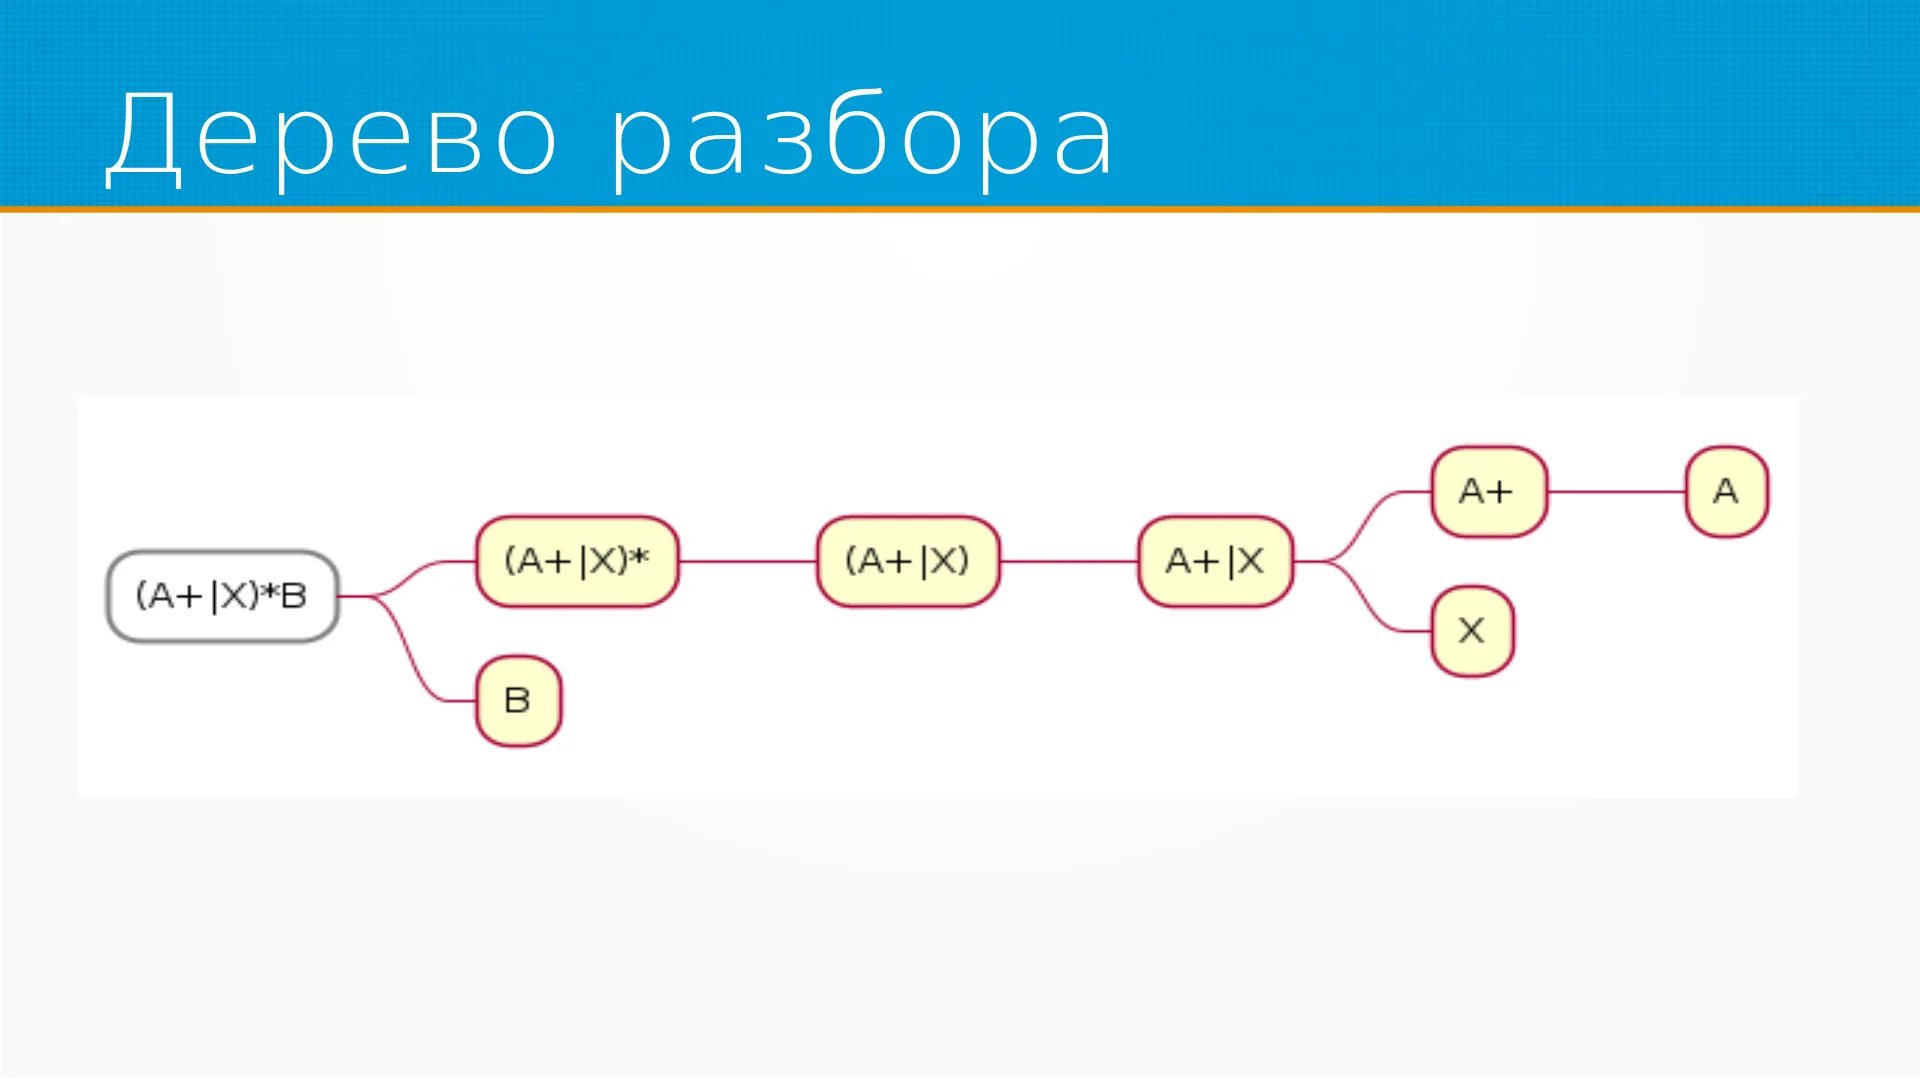
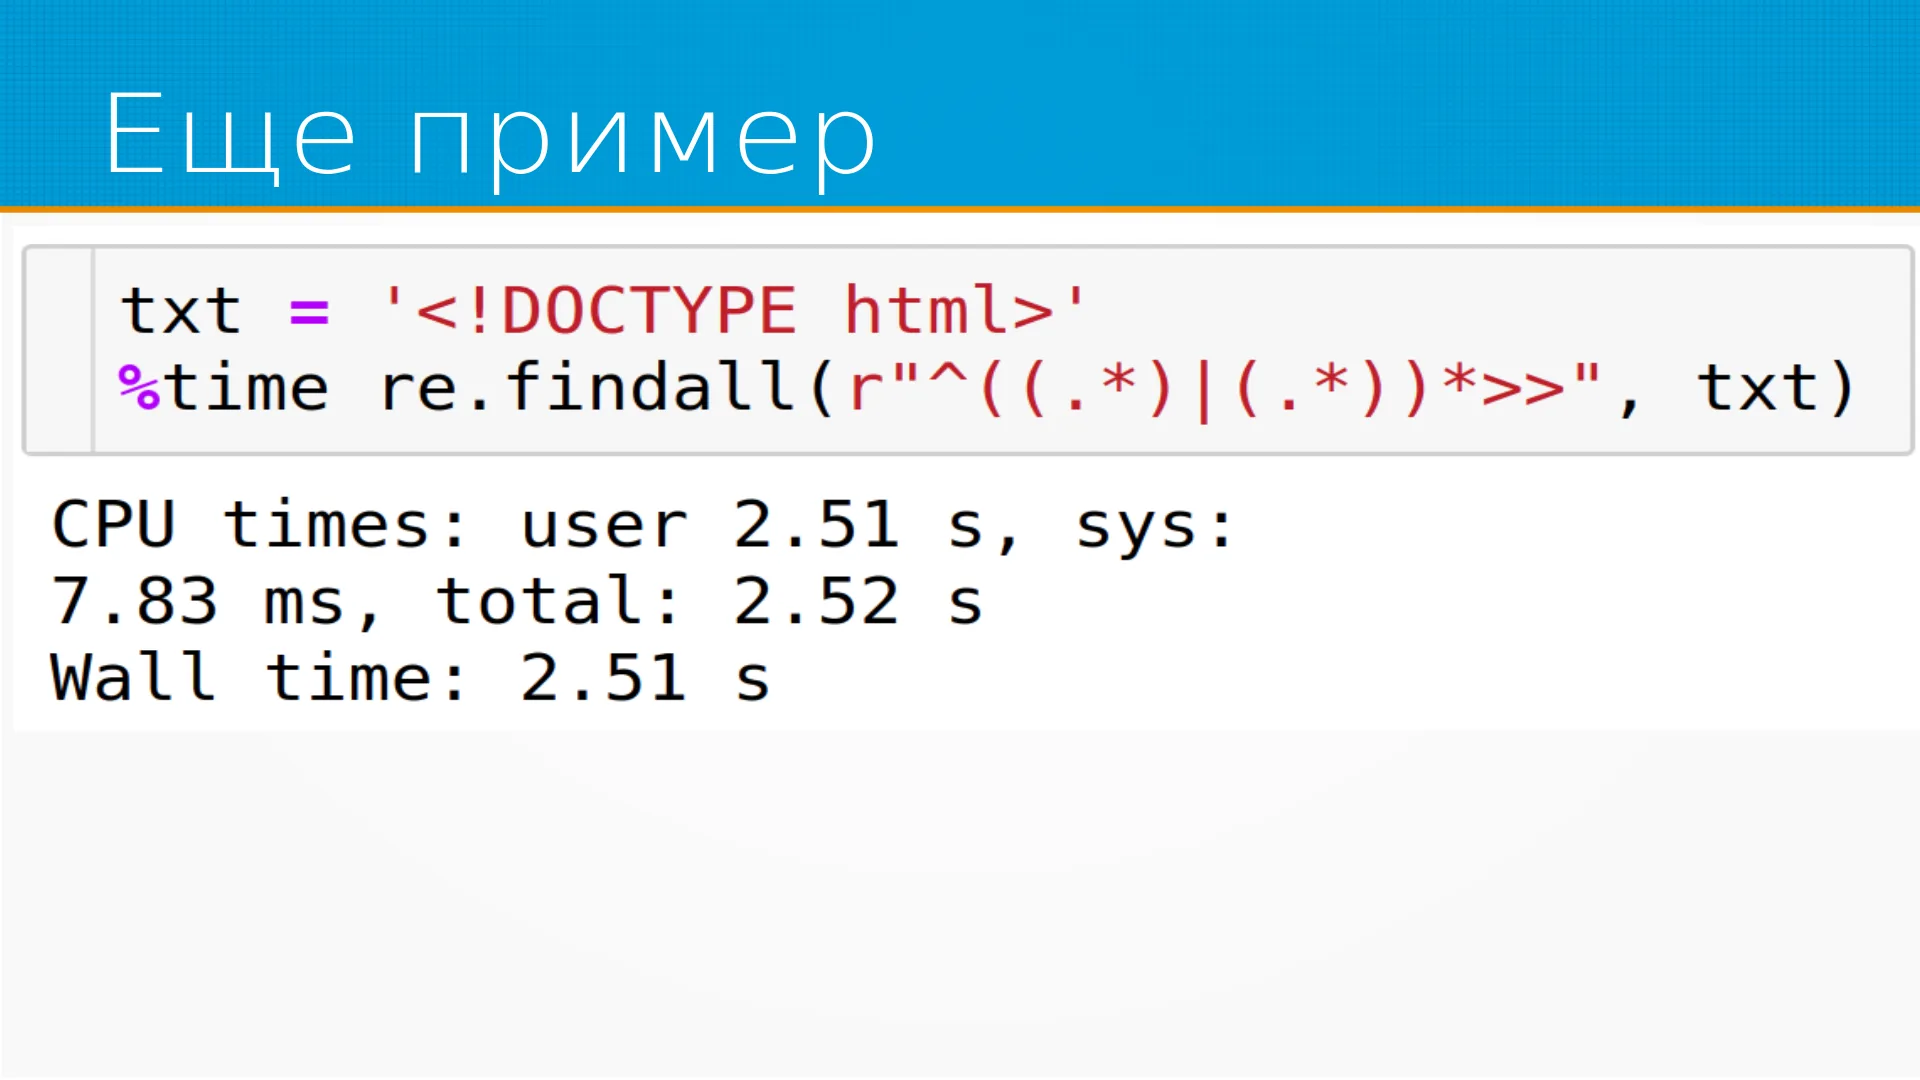
Это конечные автоматы, достаточно сложные сами по себе, и они идут по символу слева направо по нашему тексту, отрабатывают, и если у них не получилось отработки, они возвращаются, передвигаются на один символ, идут дальше. Это бы всё ничего, но мы легко можем написать регулярное выражение, которое будет работать больше, чем будет жить наша Вселенная. Вот, например, а регулярное выражение вверху, оно работает 24 миллисекунды. Оно на строке из трёх А и одного С в конце. Если мы добавим ещё один символ А, оно начнёт работать в два раза медленнее. Если мы добавим семь символов ещё, то есть, чтобы у нас было 10 символов А, оно будет работать в 32 раза медленнее.
Если мы сделаем строку длиной 26 символов, это регулярное выражение будет работать почти 3 секунды. И так в два раза медленнее с каждой дополнительной А. Почему так происходит? Регулярное выражение буквально Описывает следующее: начиная с начала строки, у нас есть некоторая последовательность букв А, одна или больше, или буква Х. Таких комбинаций у нас ноль или больше, а в конце стоит Б. И регулярное выражение, аппарат регулярных выражений, он берёт первую А, смотрит: "О, клёво, оно совпало". Затем берёт вторую А: "О, клёво, оно совпало". Затем берёт третью А: "О, клёво, оно совпало". Потом натыкается на букву С и говорит: "Чёрт, оно не совпадает ни с А, ни с Б". Давай вернёмся назад.
Он возвращается назад и, а, пробует комбинацию чуть-чуть другим способом. Он второй раз проходит. И так он делает на каждом символе. И с регулярными выражениями, которые не успевают отработать за сутки, я, например, в работе сталкиваюсь постоянно. Поэтому будьте просто осторожны. Вот там есть статья прекрасная, в которой разбирается это явление и презентацию я скину, и объясняется, как не наступить на эти грабли. Особенно легко на них наступить, если там есть, а, условные нежадные квантификаторы. Почему-то с нежадными квантификаторами прямо наступается веселее. И вообще любое регулярное выражение, в котором есть три выражения со звёздочкой, оно при определённых обстоятельствах будет regex-убийцей. До этого мы работали с findall, который проходит по всему, по всей нашей строке, находит все совпадения регулярного выражения, возвращает их в виде массива.
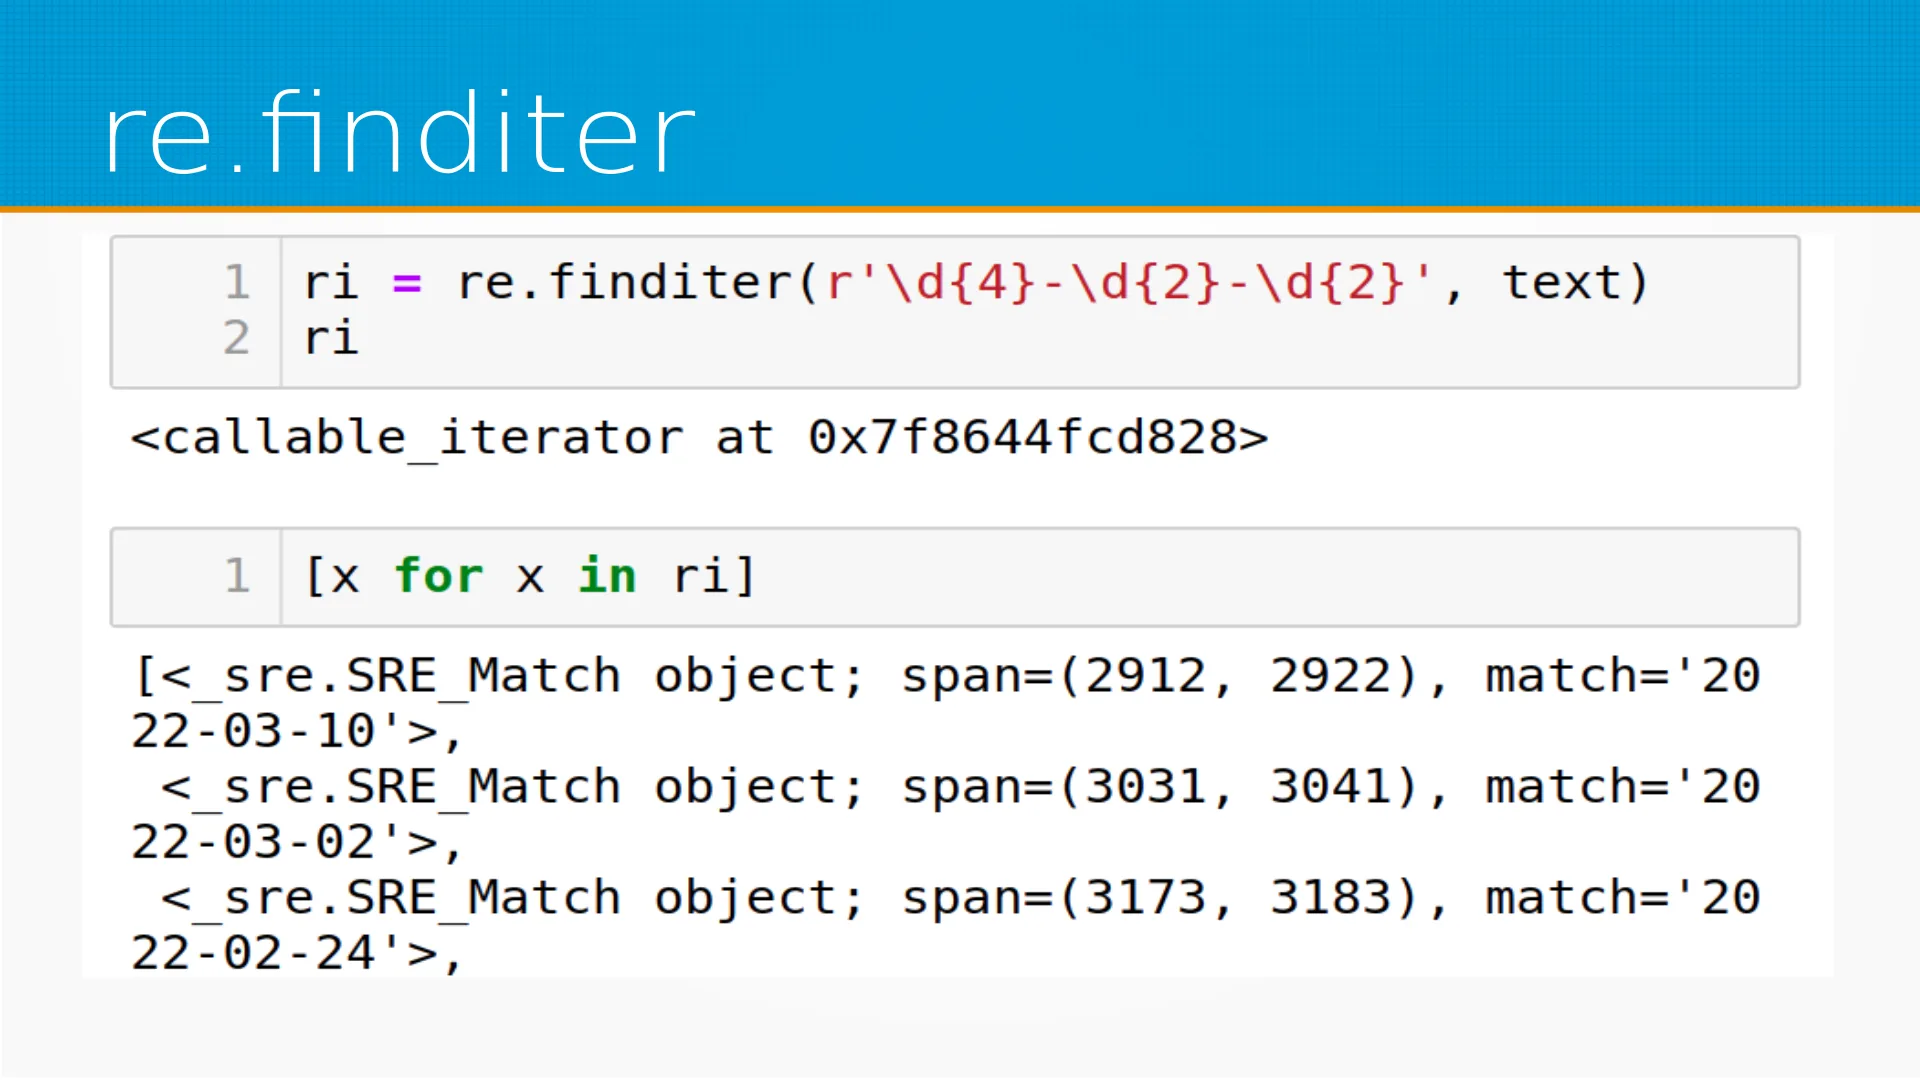
Списка. Иногда это не очень удобно, например, когда мы работаем с большим текстом или нам нужно что-нибудь такое Сложное сделать, или нам нужно куда-нибудь передать наше регулярное выражение, и мы можем вместо findall вызывать finditer, который возвращает итератор по тексту. И вместо значений, которые найдёт наше регулярное выражение, мы получаем, мы итерируемся по объектам совпадения. SRE match.
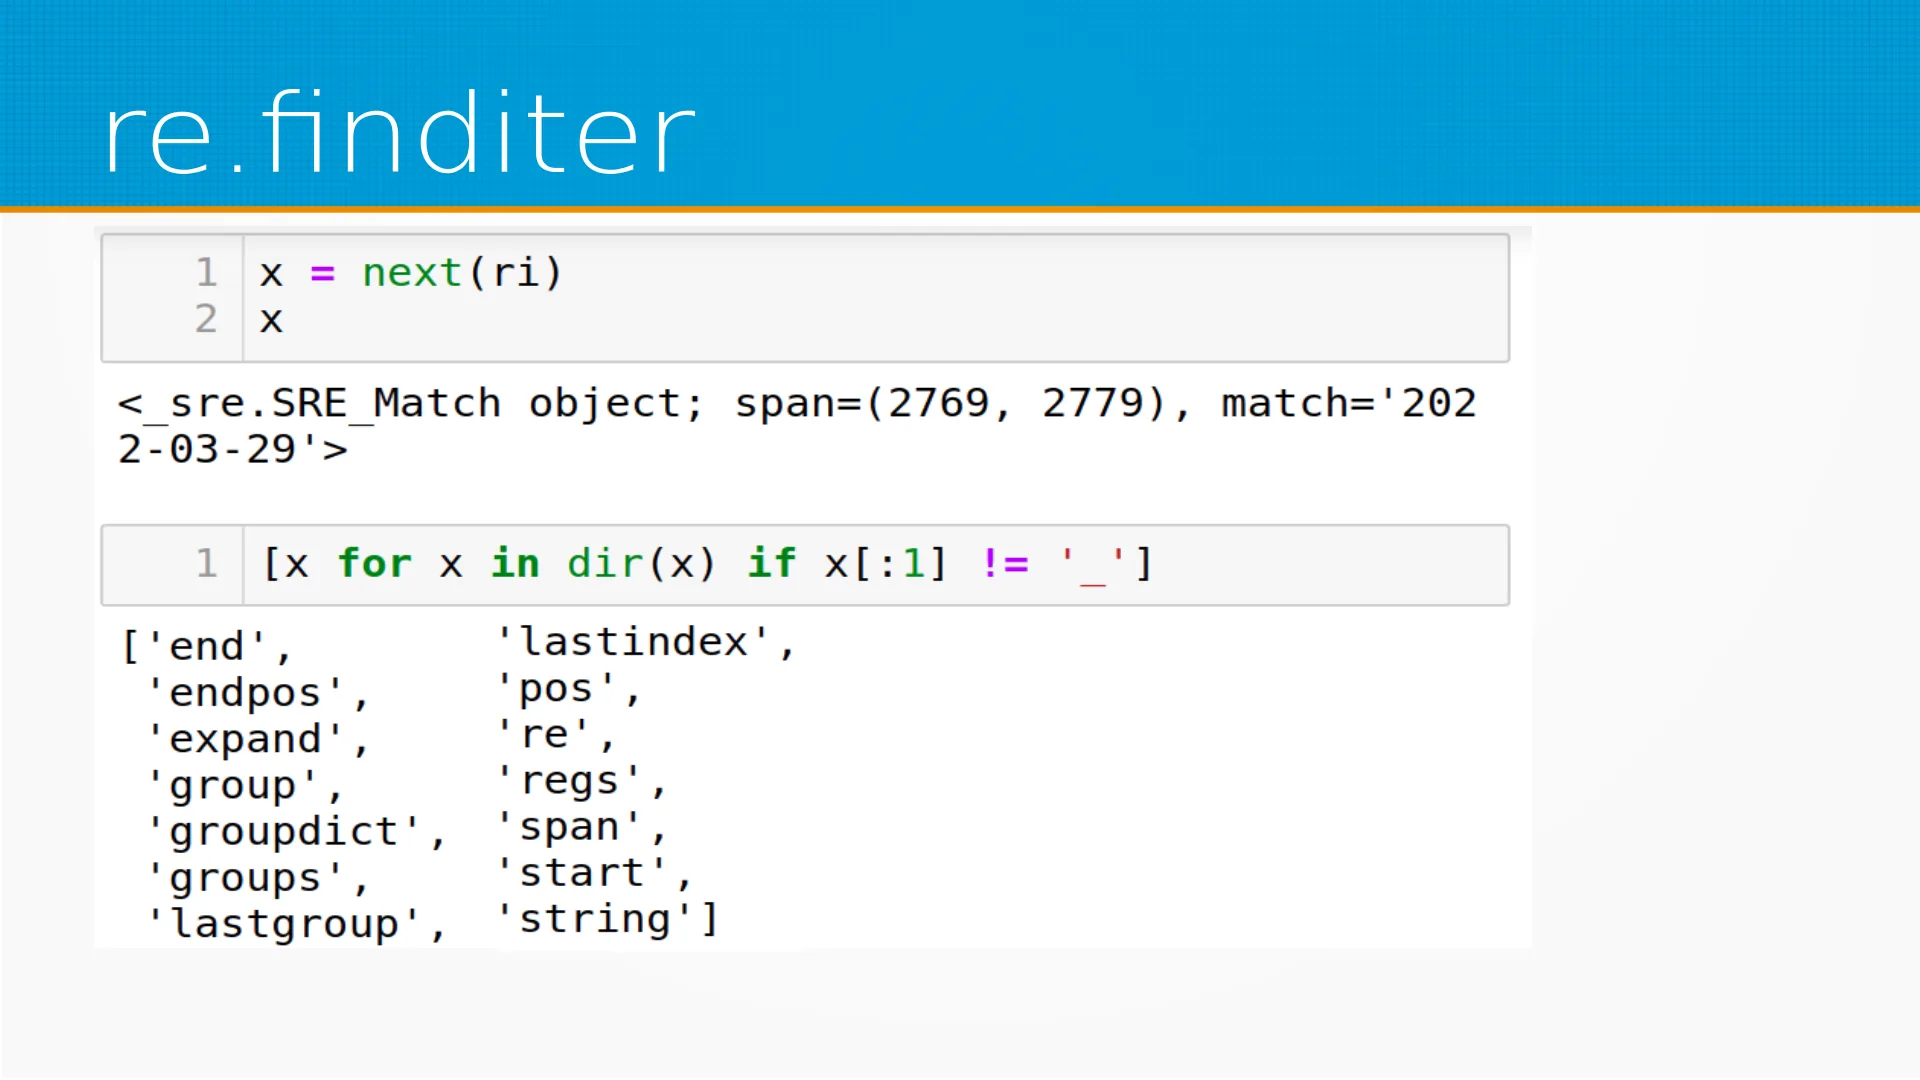
И что же, собственно говоря, это у нас за match? Давайте возьмём один, одно такое совпадение, то есть из итератора выдернем первое значение. И посмотрим, какие у него есть методы. Из всех методов объекта совпадения, нас будут интересовать больше всего span
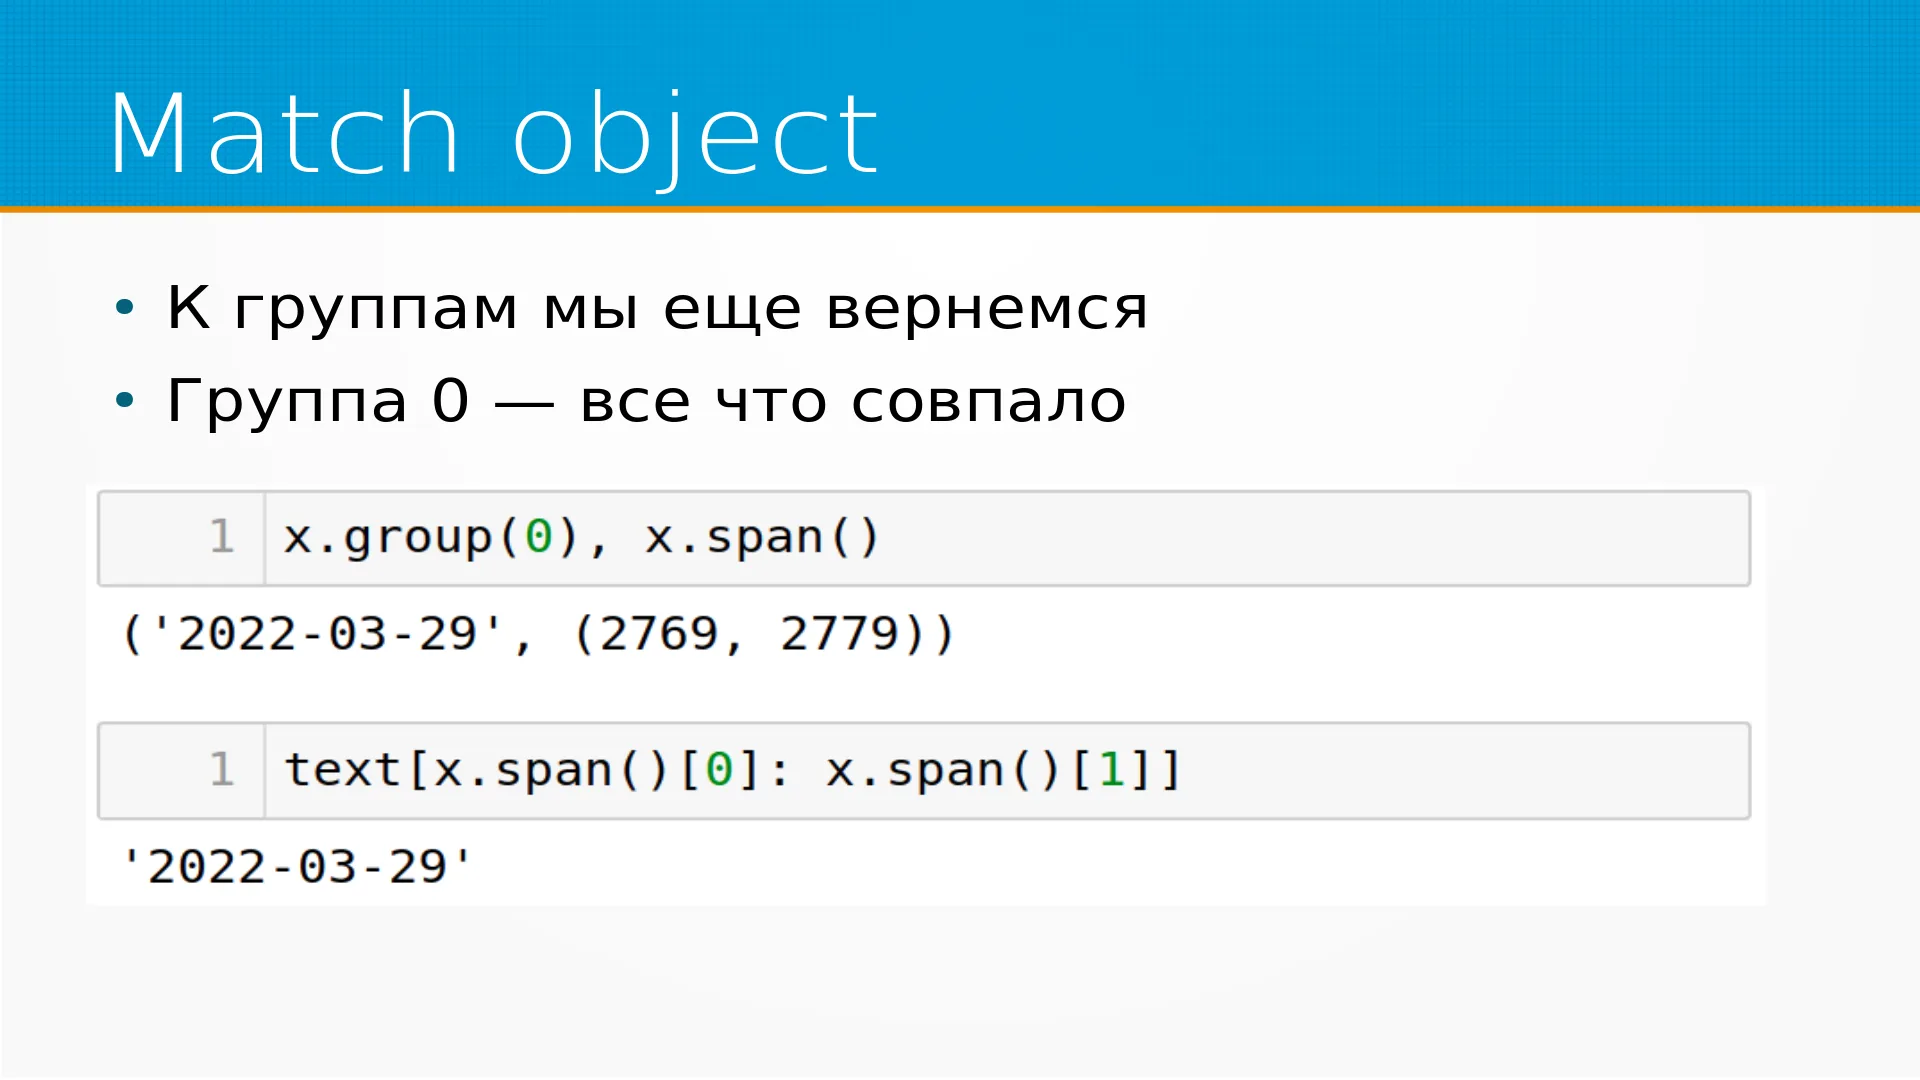
и group. Span - это какие символы совпали, с какого по какой в исходной строке это регулярное выражение совпало. Group - это что за текст совпал. Group 0 - это всё регулярное выражение, а там бывают ещё группы с другими номерами, мы их потом чуть-чуть рассмотрим. И мы видим, что мы можем взять индексы спана и просто из исходного текста выдернуть, и получим как раз то, что нам регулярное выражение нашло. Это регулярное выражение совпало на позиции 2769 по 2779.
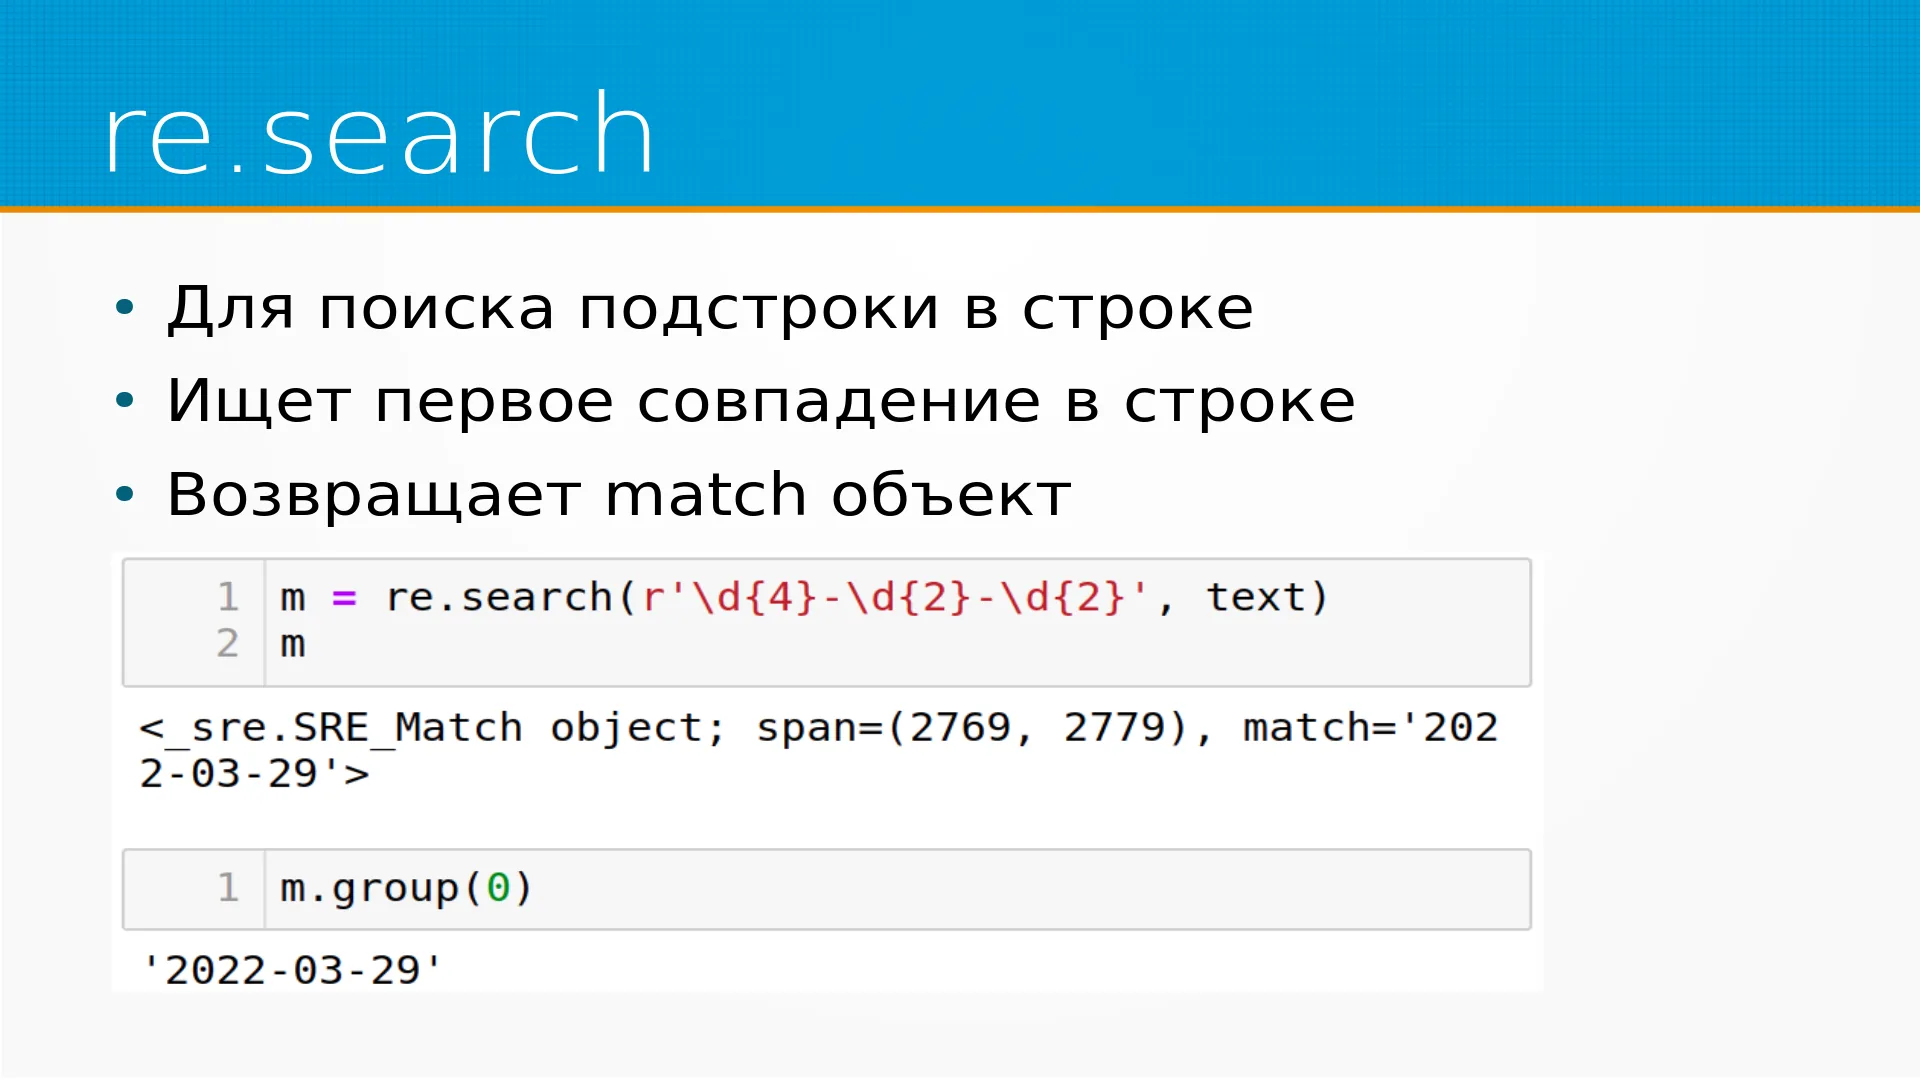
Кроме findall, есть ещё search. Он предназначен для поиска подстроки в строке. Предположим, что нам нужно вернуть не все, не список подстрок, а вот одну подстроку найти. Он ищет первое совпадение и возвращает тот самый match-объект.
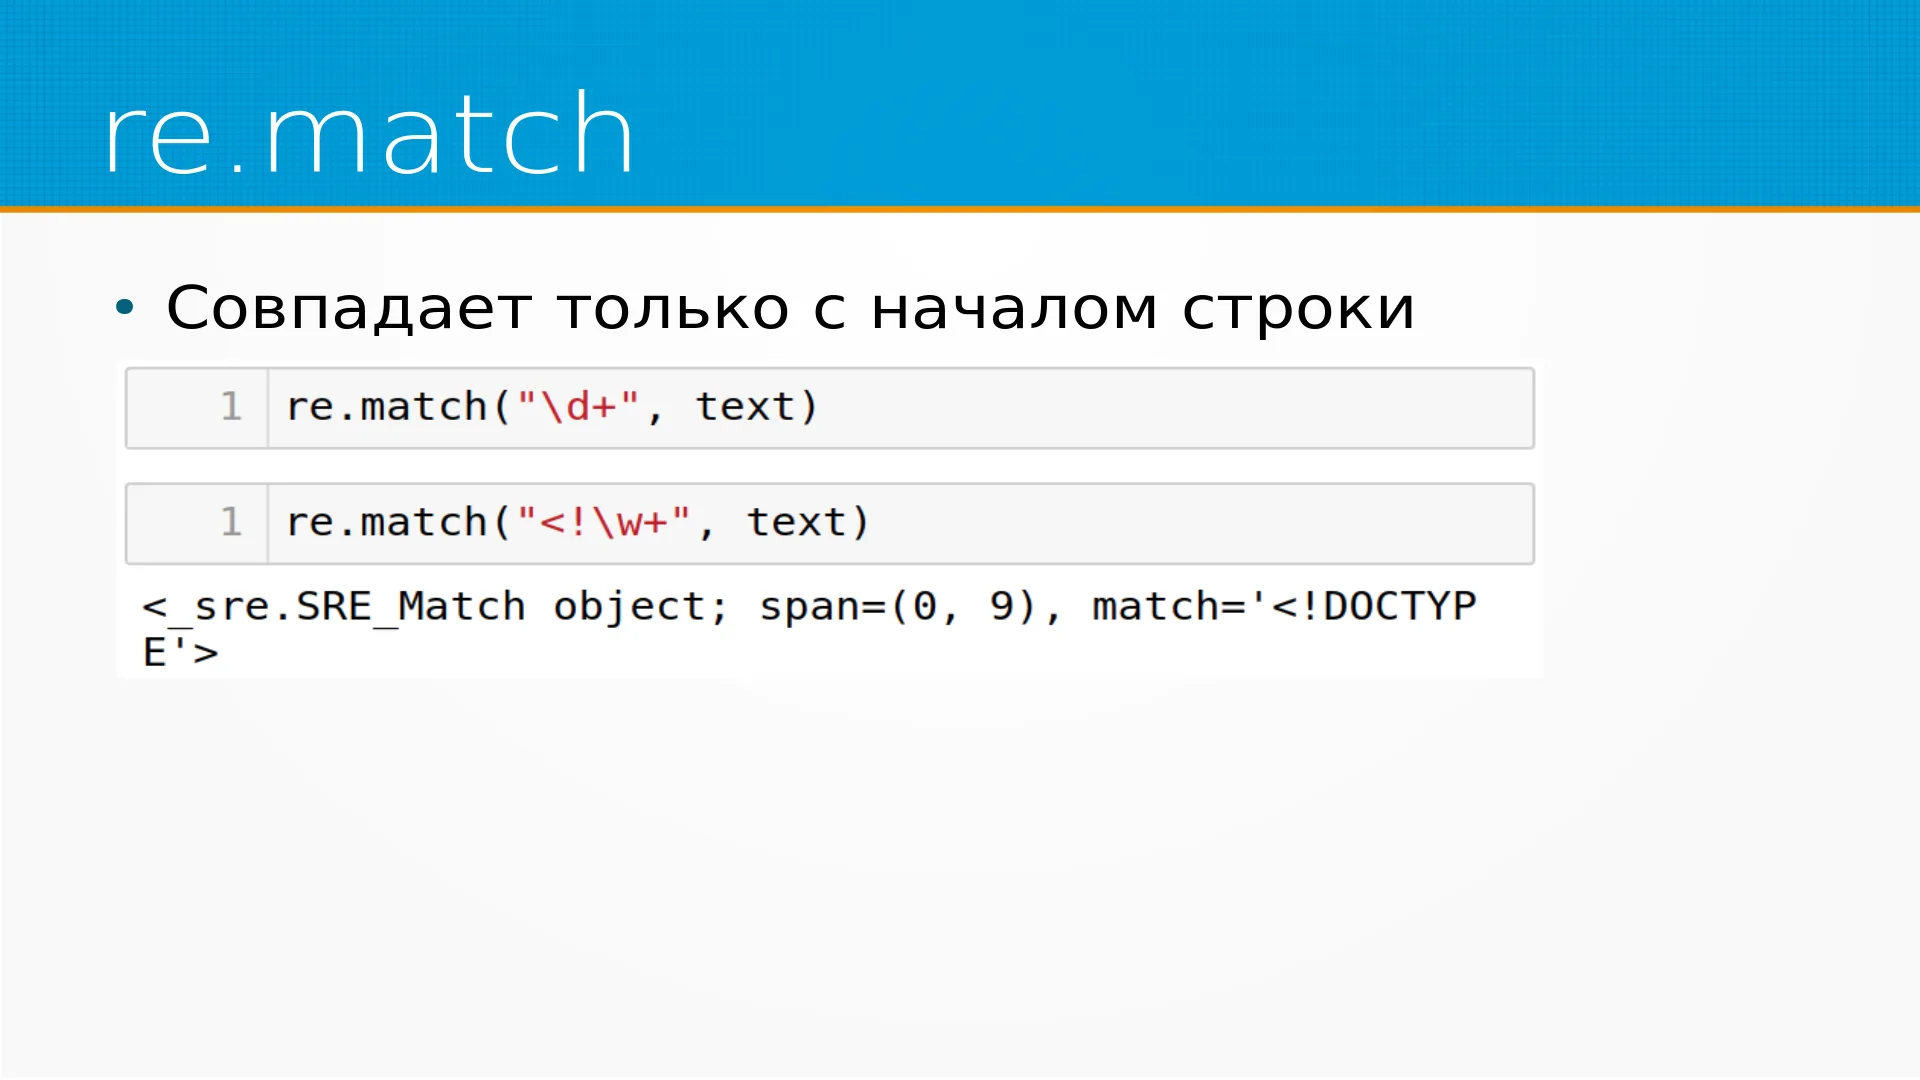
Re.match, он примерно как re.search, но совпадает только с началом строки. Это похоже, как если бы мы написали re.search, но поставили в начале символ, а обратная косая А, например. Что оно должно с начала строки совпадать. И, соответственно, что у нас? Мы видим, что с нашим текстом re.match косая D+ не совпало ни разу, то есть ничего не вернуло, вернуло None. Регулярное выражение, не совпавшее, возвращает None, это очень удобно, его можно использовать в ифах, например. If re.match, если оно что-нибудь вернуло, то оно приводится к True. Если оно ничего не вернуло, вернуло None, то приводится к False. Таким образом, мы можем проверять текст на совпадение с регулярным выражением.
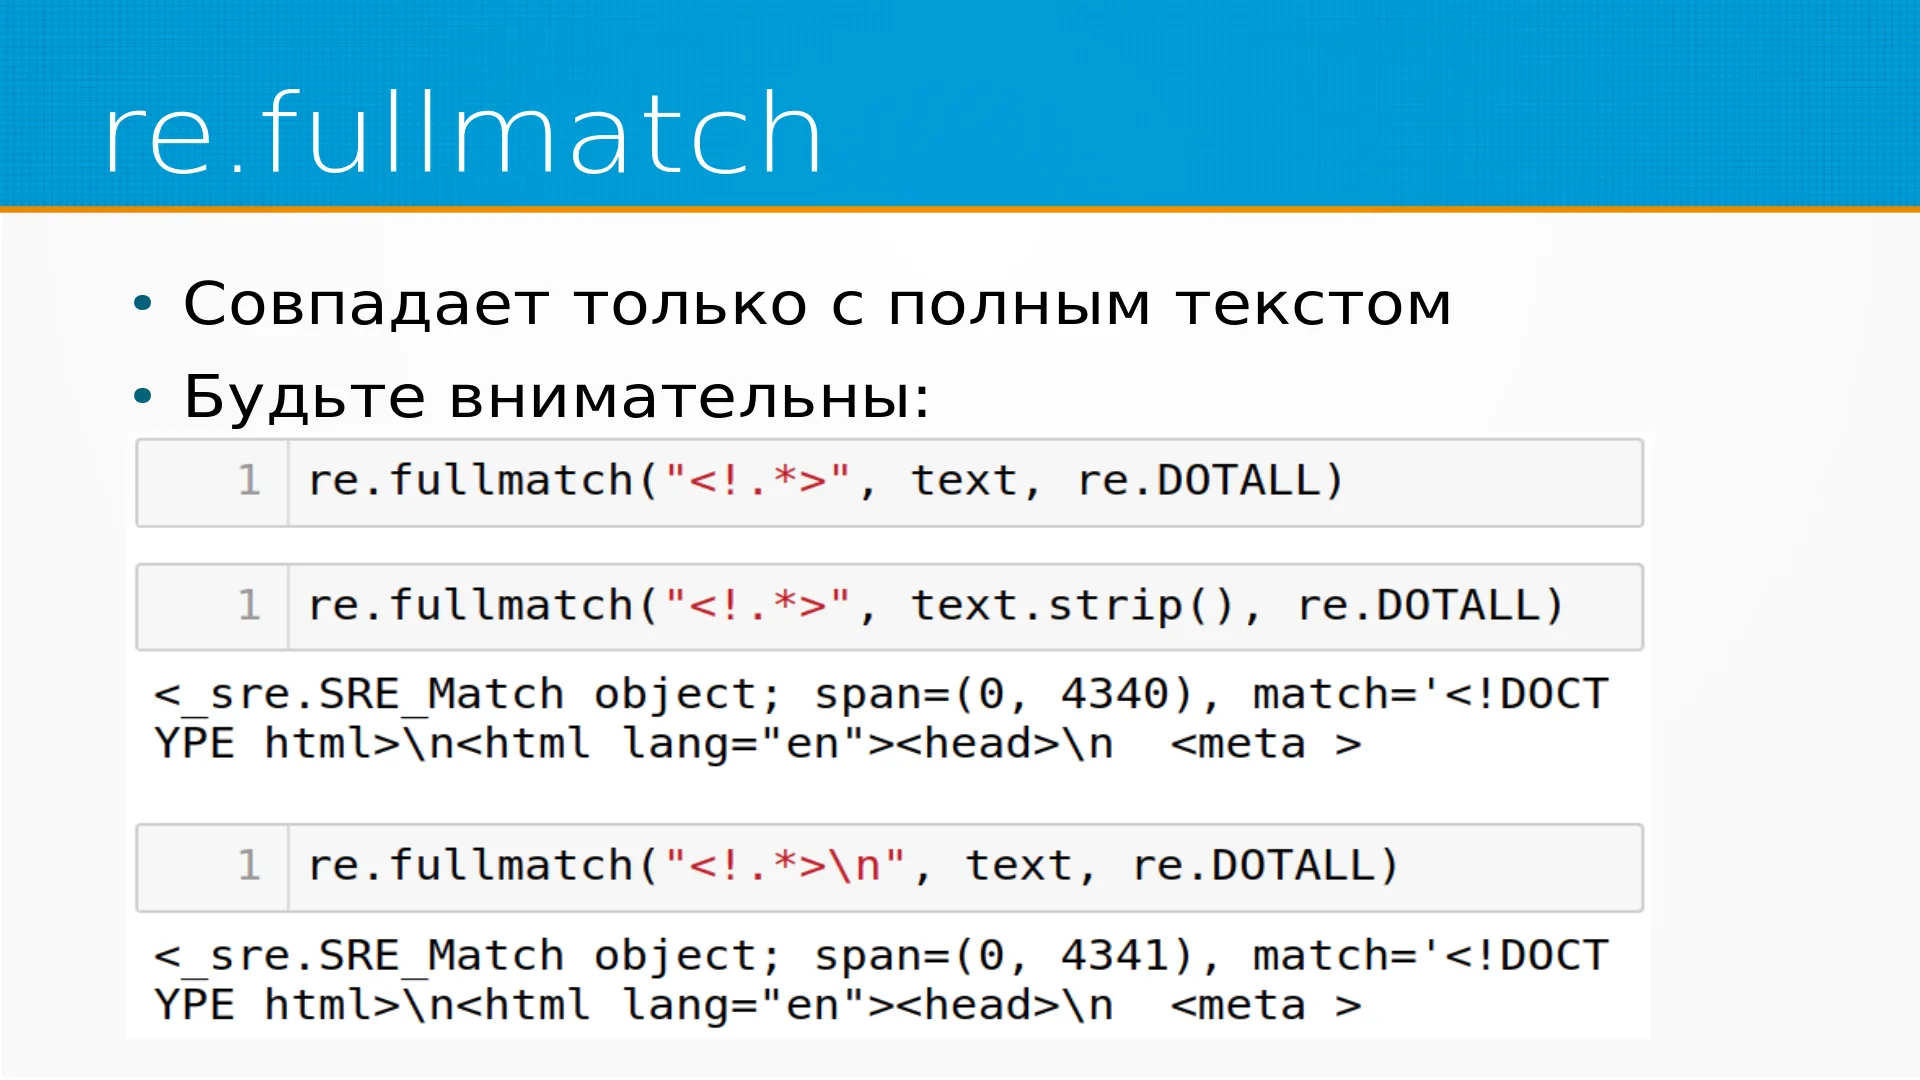
Вот, re.fullmatch совпадает только с полным текстом. И опять же, это может работать не так, как вы привыкли, потому что регулярное выражение работает с строкой, а вы смотрите на файл. Вы не всегда замечаете, например, есть там в конце перевод строки или нет. С нашим текстом сайта re.fullmatch, а, открывающая угловая скобка, восклицательный знак, точка звёздочка, закрывающая угловая скобка не совпадёт. Это странно, потому что это HTML, и он на самом-то деле начинается с угловой скобки и кончается угловой скобкой. Если мы отрежем у текста страйпом спецсимволы, то есть пробелы, переводы строки и так далее и тому подобное, то он совпадёт, как мы и ожидали. Стало немножко понятнее, добавим перевод строки к этому регулярному выражению, и вот оно совпало полностью.
С переводами строки надо быть внимательным, когда вы хотите проверить полное совпадение. Вообще они имеют свойство влазить, где надо и где не надо.
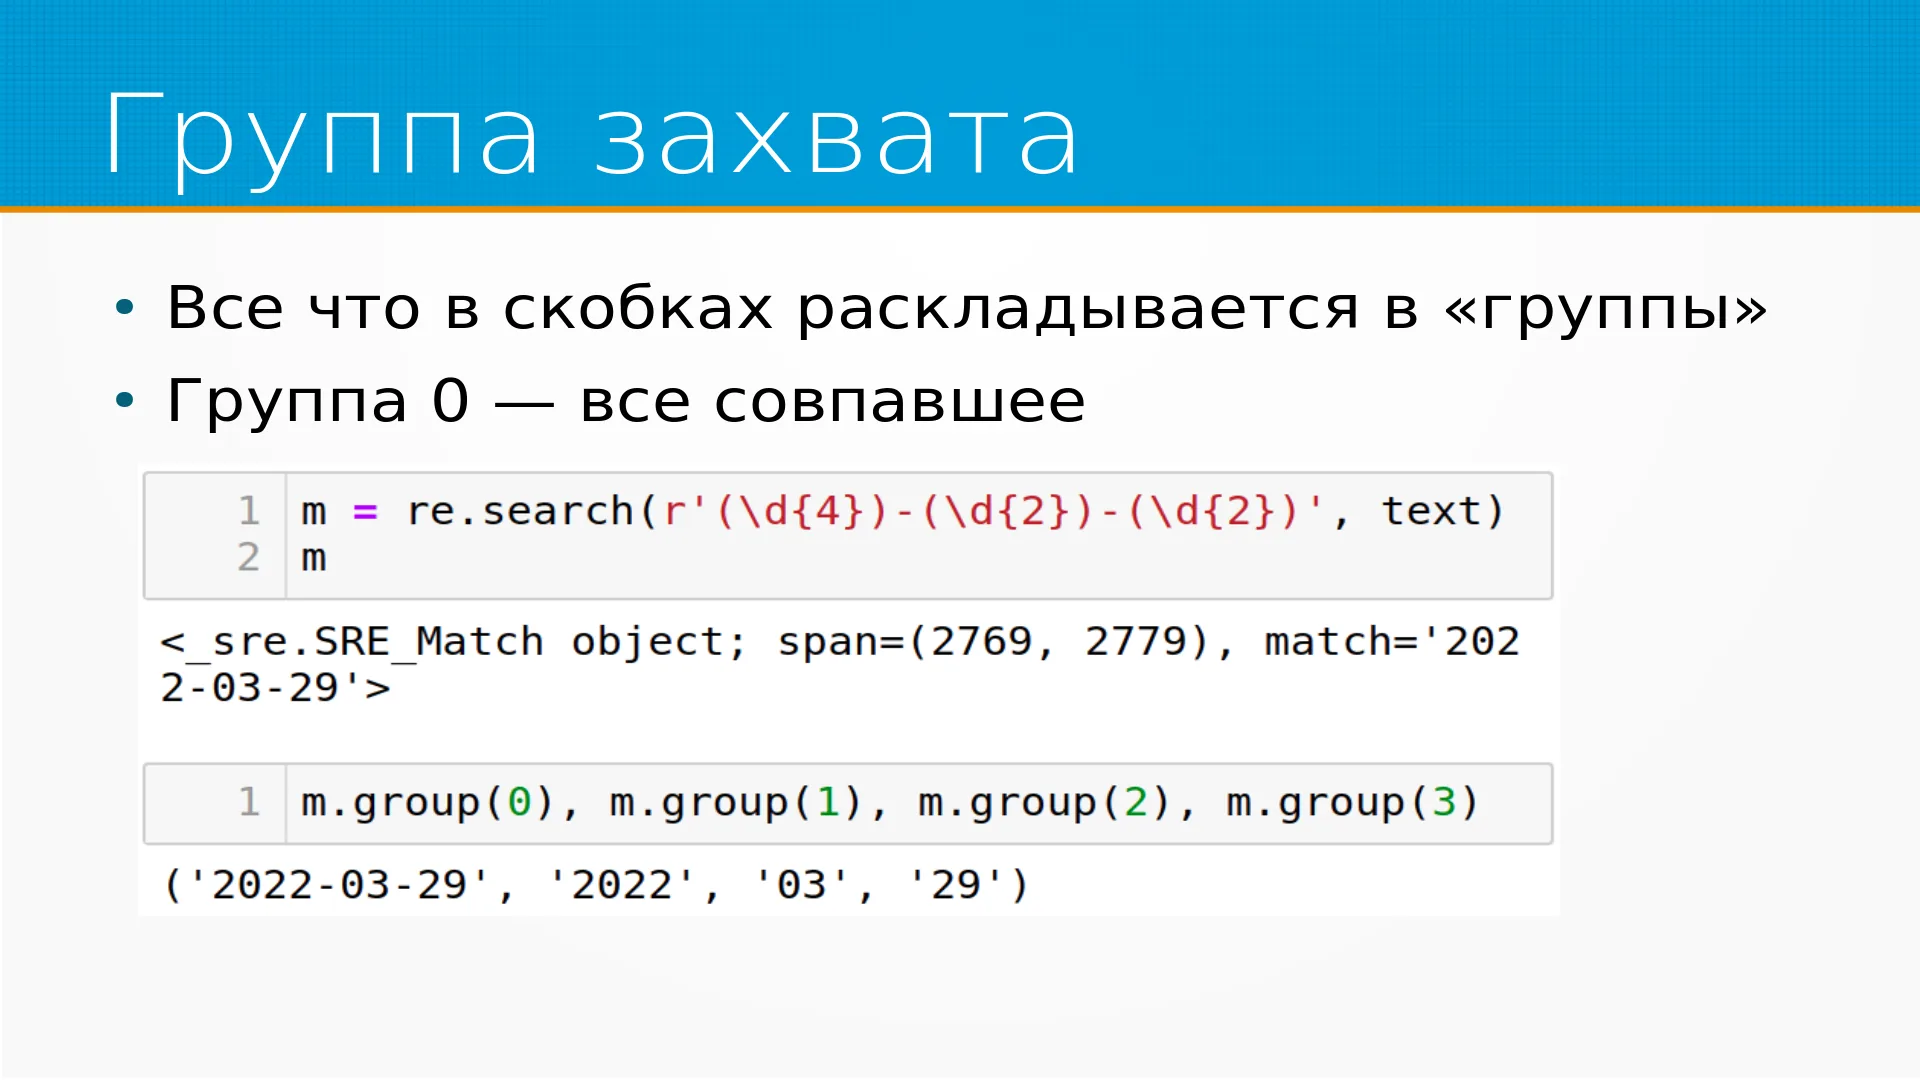
О группах захвата. Группа захвата - это что-то, что в круглых кавычках. В круглых кавычках у регулярного автомата регулярных выражений есть такие коробочки нумерованные, и как только он встречает что-нибудь в круглых кавычках, он туда складывает и по запросу отдаёт. Это группы захвата. Группа захвата ноль - это всё совпавшее регулярное выражение, а дальше первая группа - это первая группа кавычек, которая попалась, вторая группа - это вторая группа кавычек, попалась третья и так далее. Вот тут видно, как мы разобрали наш нашу дату мероприятия на год, месяц и день.
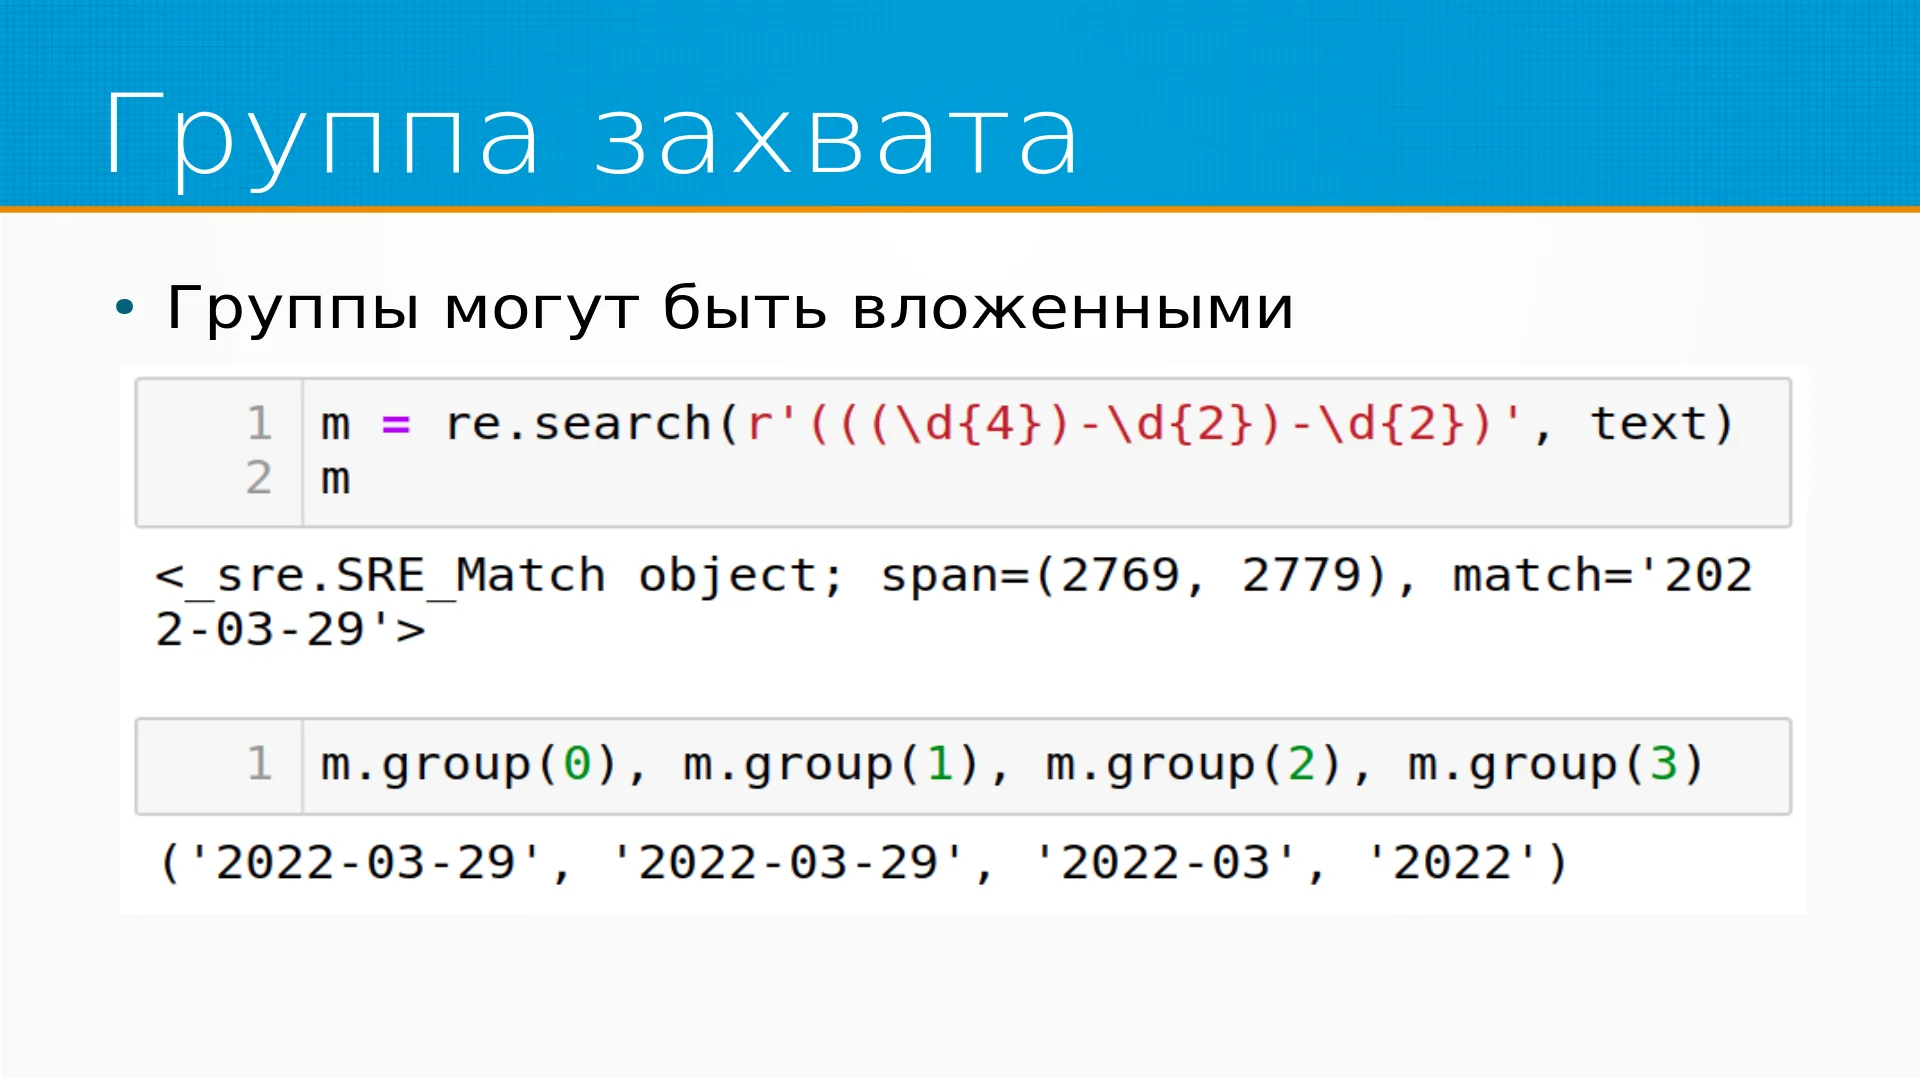
Группами. Группы могут быть вложены. Тогда они разрешаются слева направо. Сначала совпадёт первая внутренняя скобка, а, первая, первая скобка, которая открылась, потом совпадёт вторая скобка, которая открылась, потом совпадёт третья скобка, которая открылась. В том порядке, в каком они открывались. То, что одна группа лежит в другой, им не мешает никак.
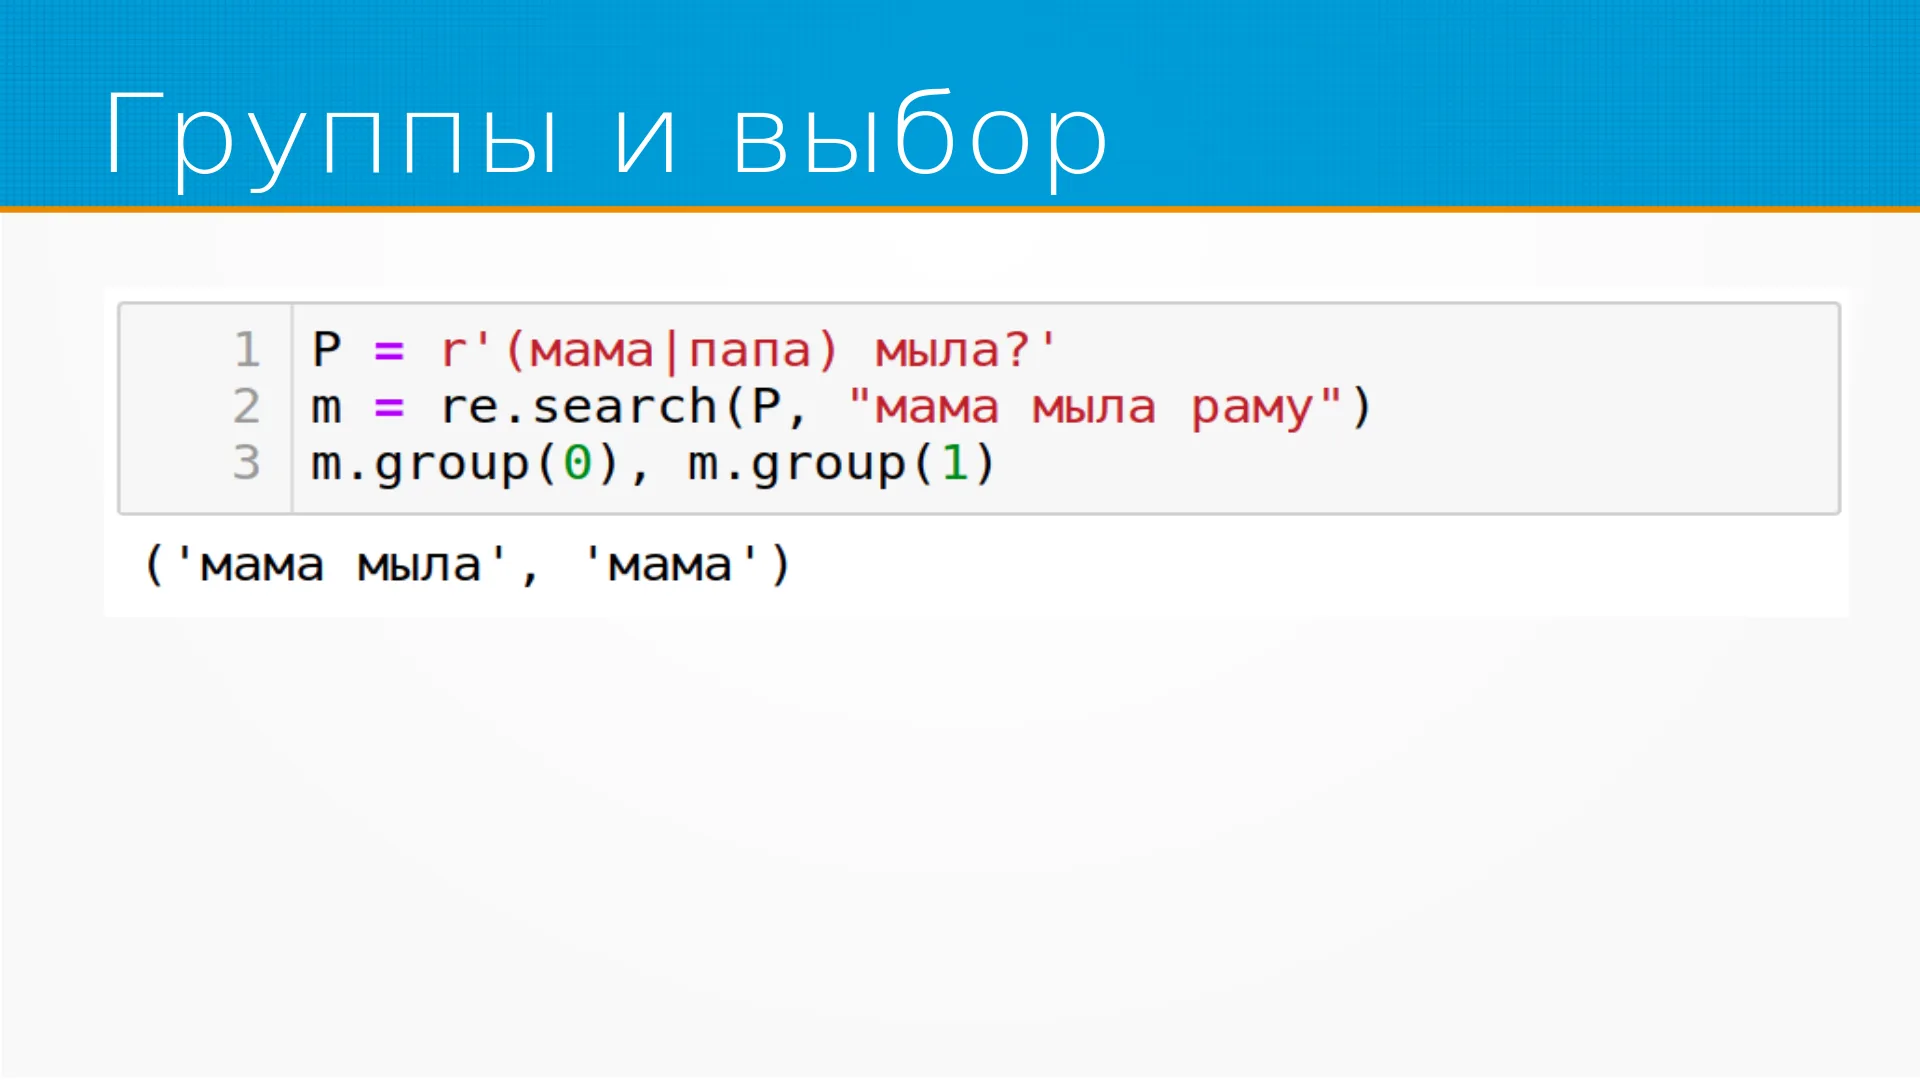
Группы удобно использовать для Группировки выбора. Например, мама или папа пробел мыло. Совпадает с мама мыло раму, ну и на самом деле и папа мыло раму тоже он совпадёт.
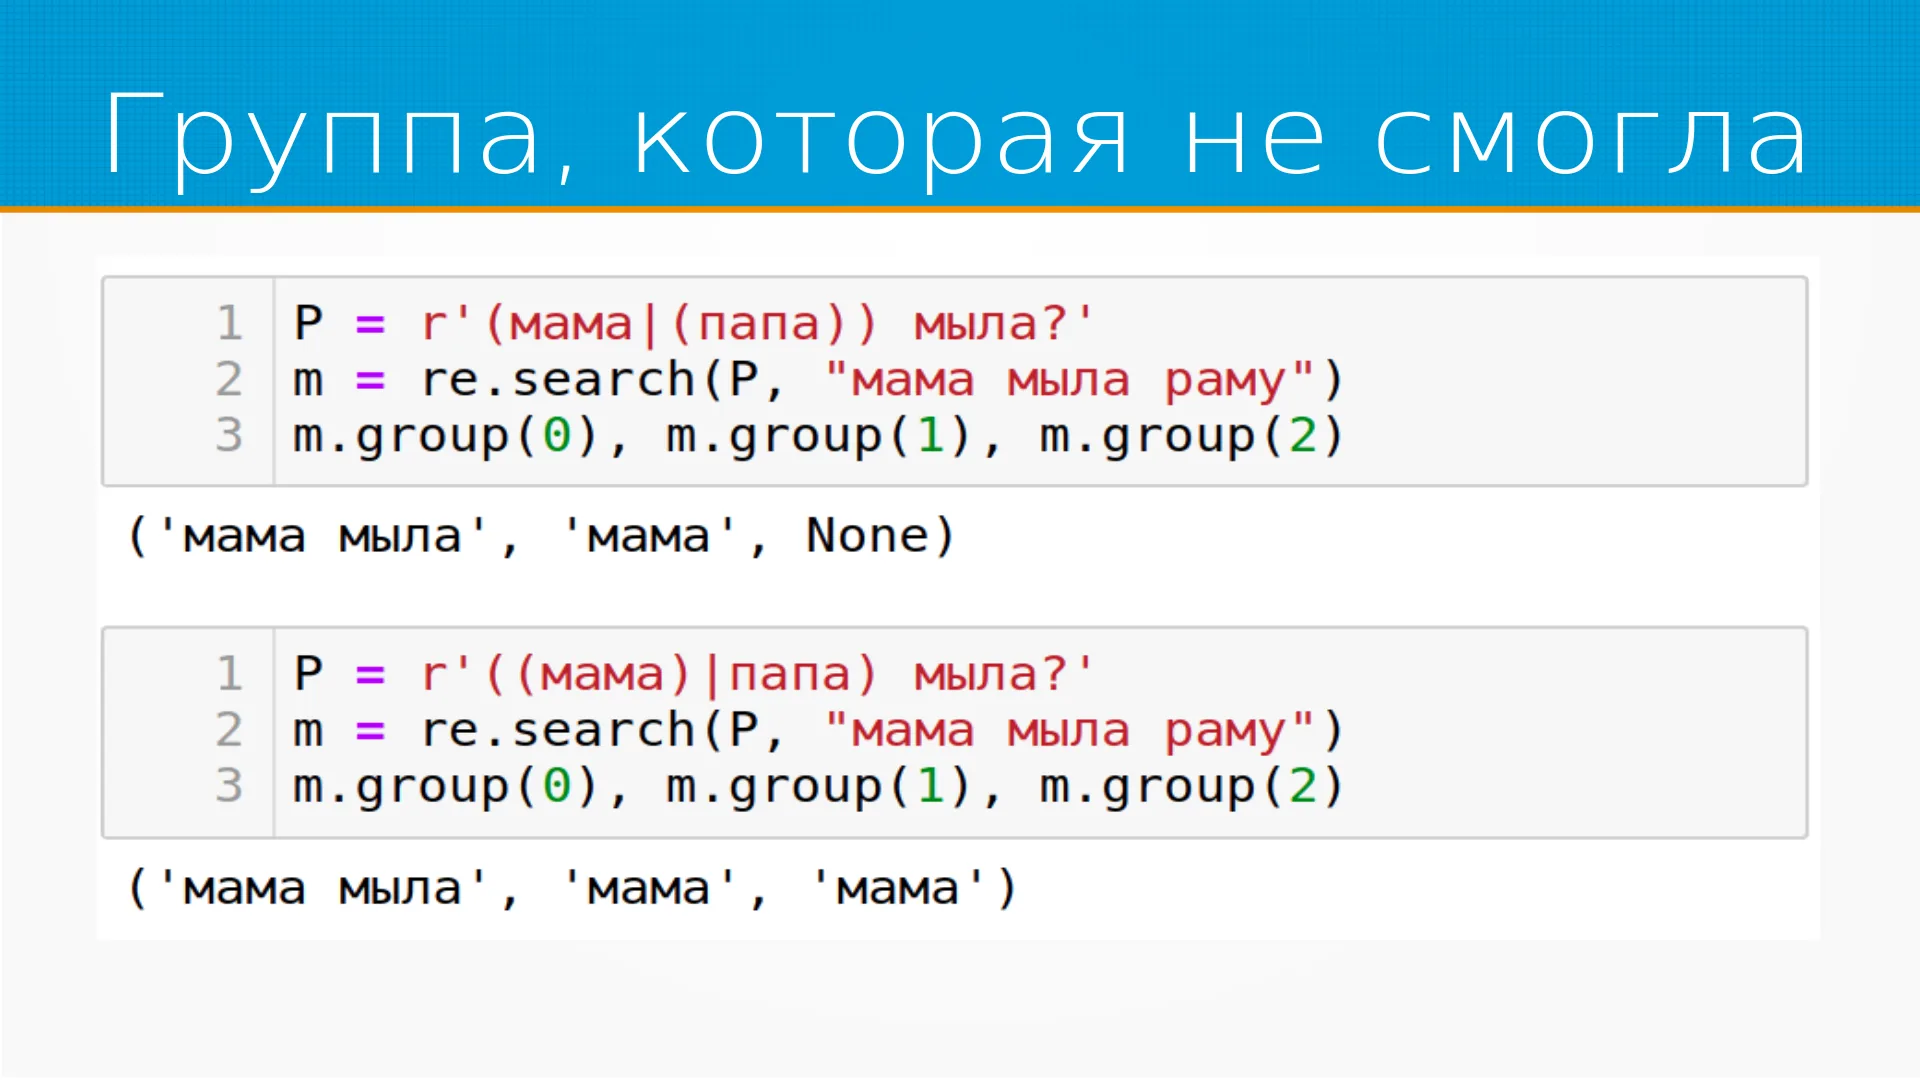
Так. Если группа есть объявлена в регулярном выражении, но ничего не захватила, в этой группе будет лежать None. Например, вот у нас объявлена группа мама, в ней или папа мыло. Мама совпадёт, папа не совпадёт. Соответственно, первая группа заполнена, вторая группа не заполнена.
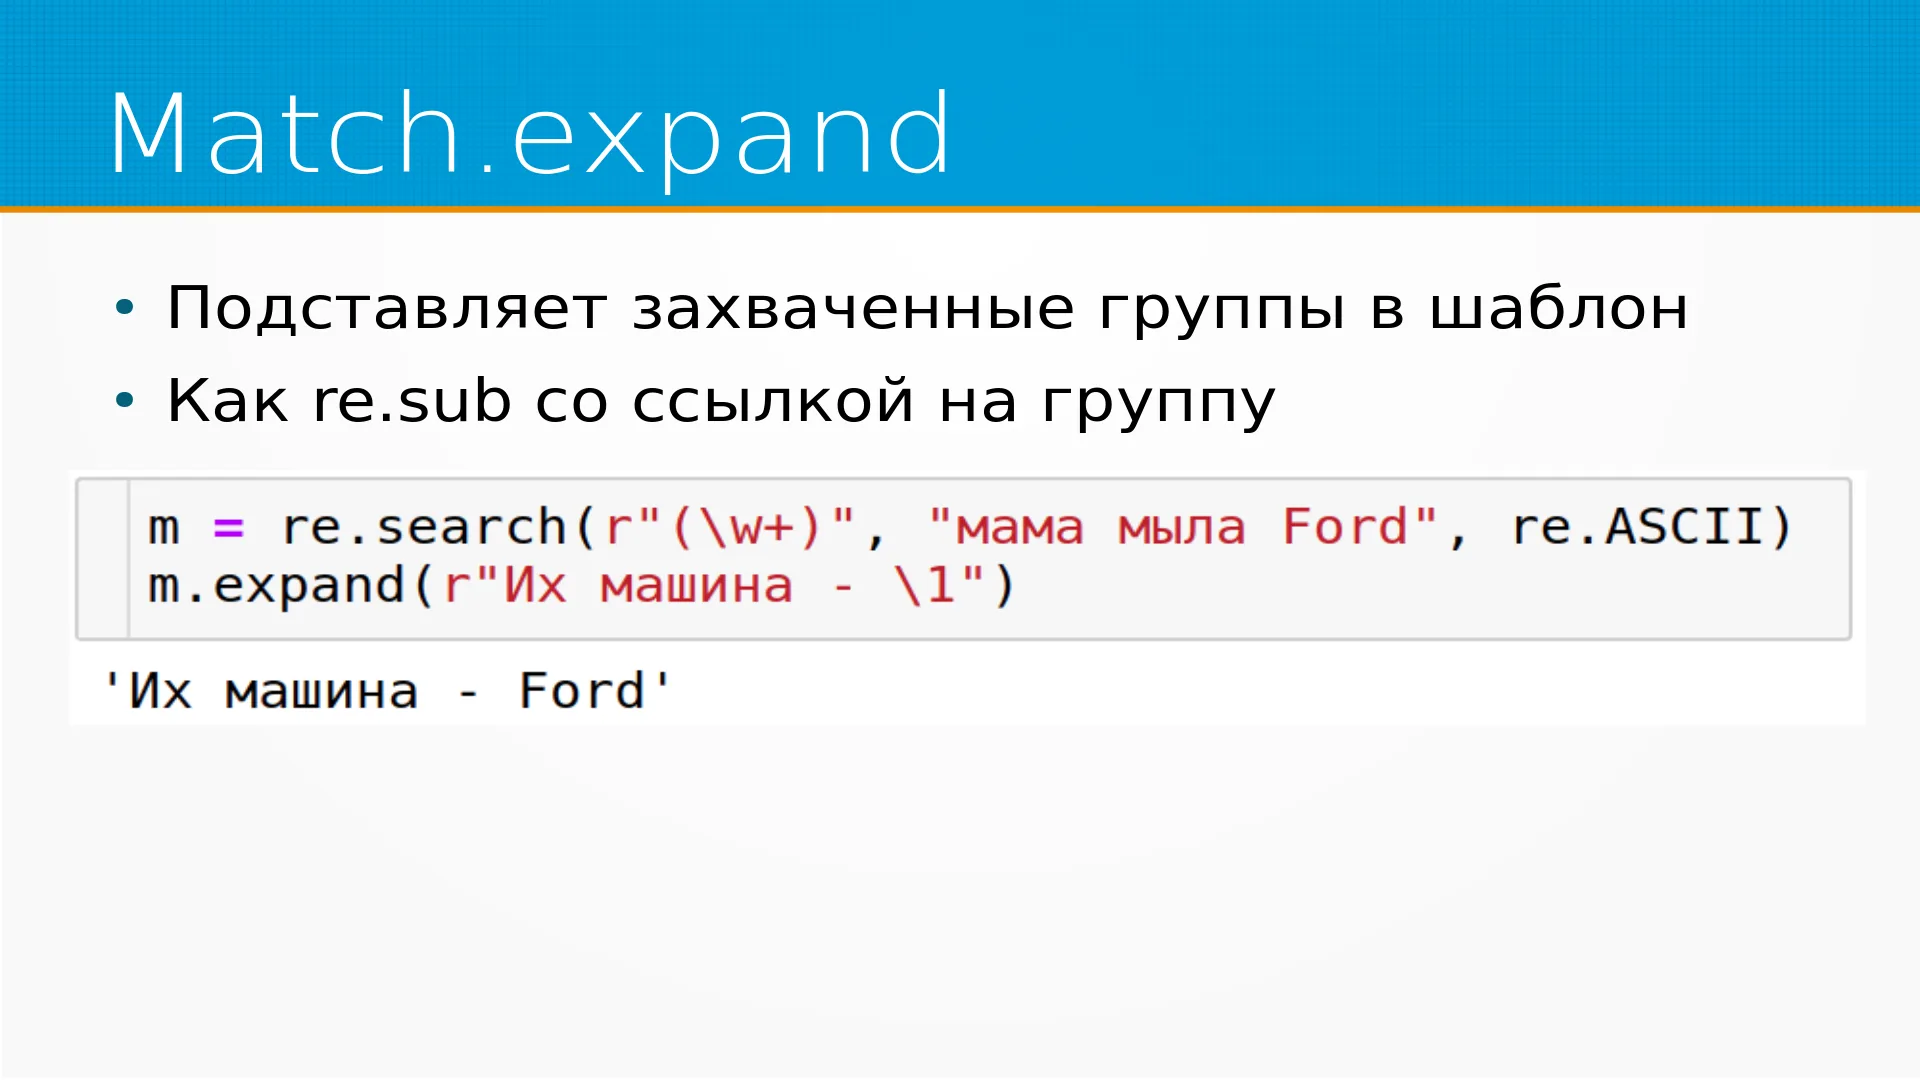
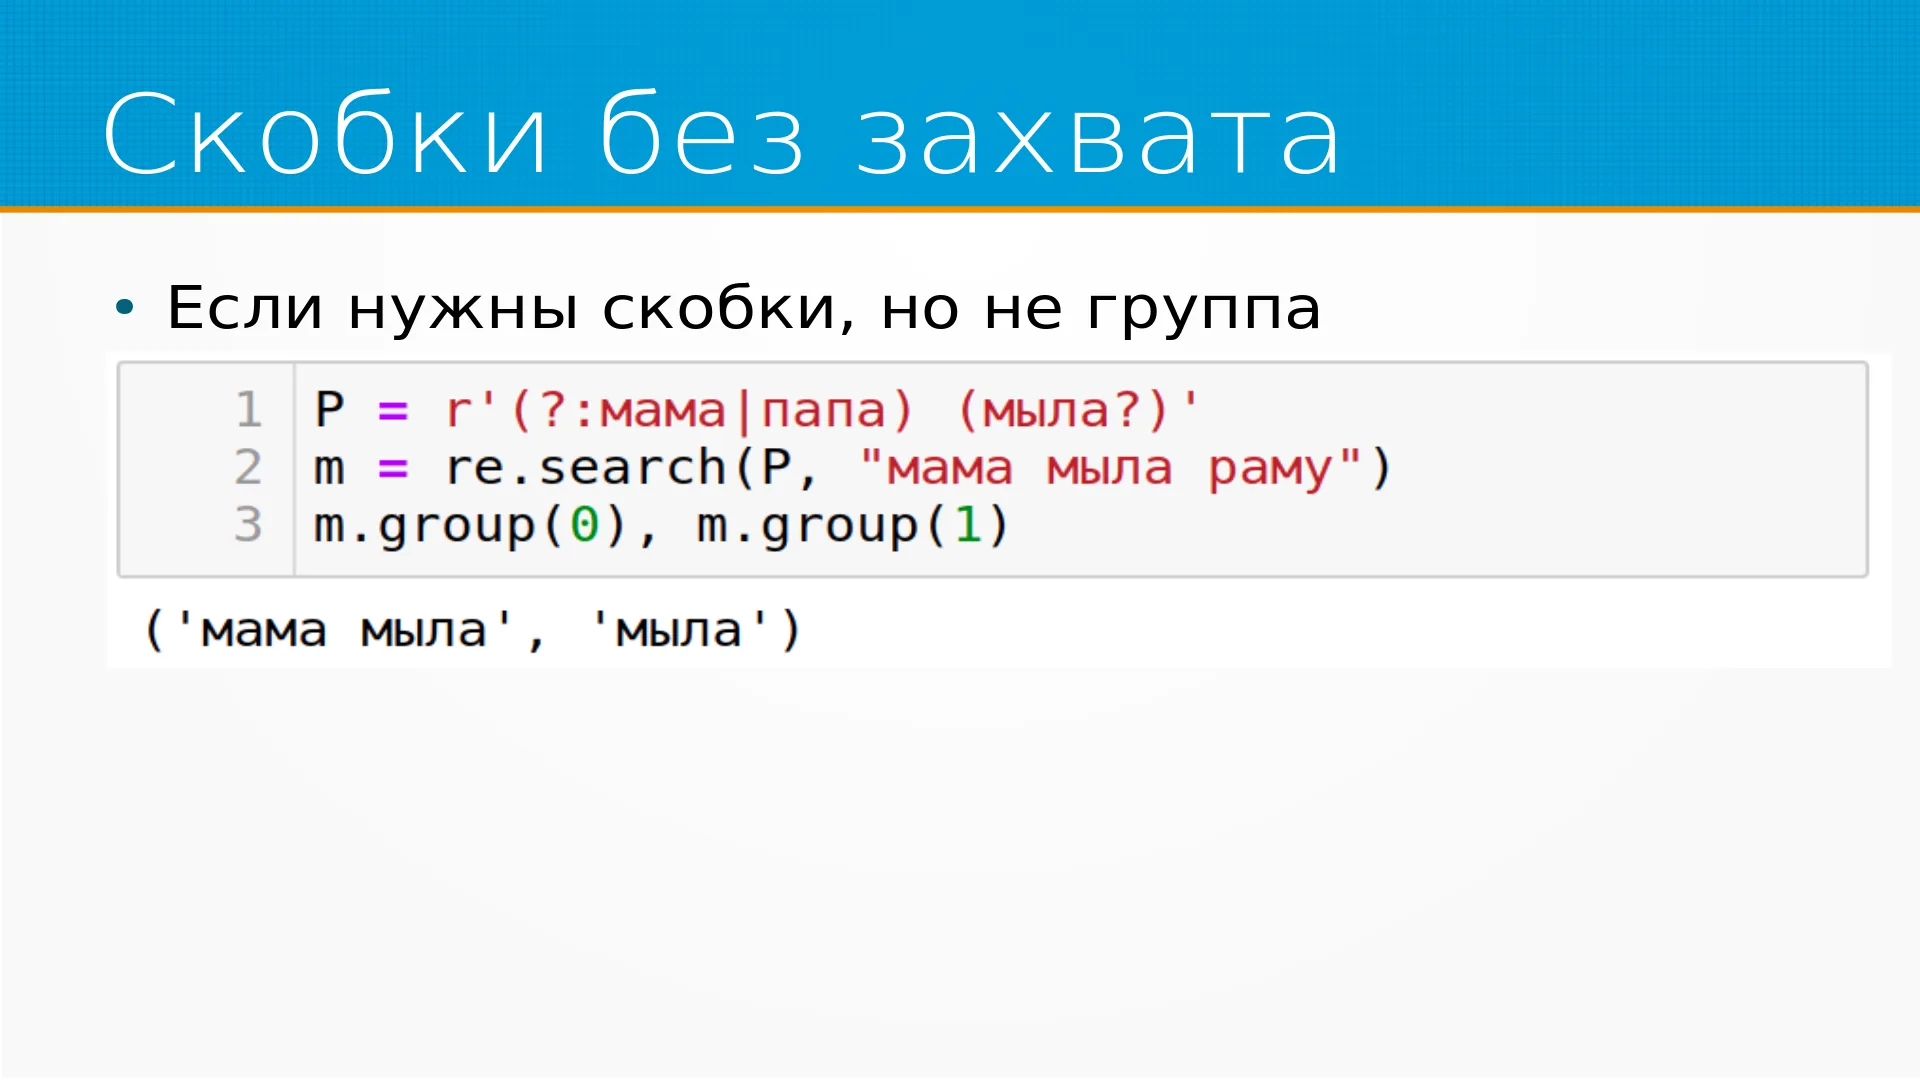
Вот такие вот дела. И иногда нужны скобки просто, чтобы сгруппировать выражение, но мы не хотели бы плодить множественные группы, потому что, если расставишь везде скобок, они позахватываются, потом пытаться понять, куда что попало. Есть незахватывающие скобки. Незаватывающие скобки - это вопросительный знак двоеточие, и после этого регулярное выражение. Оно будет сгруппировано, но не будет сложено в эту коробочку аппарата регулярных выражений.
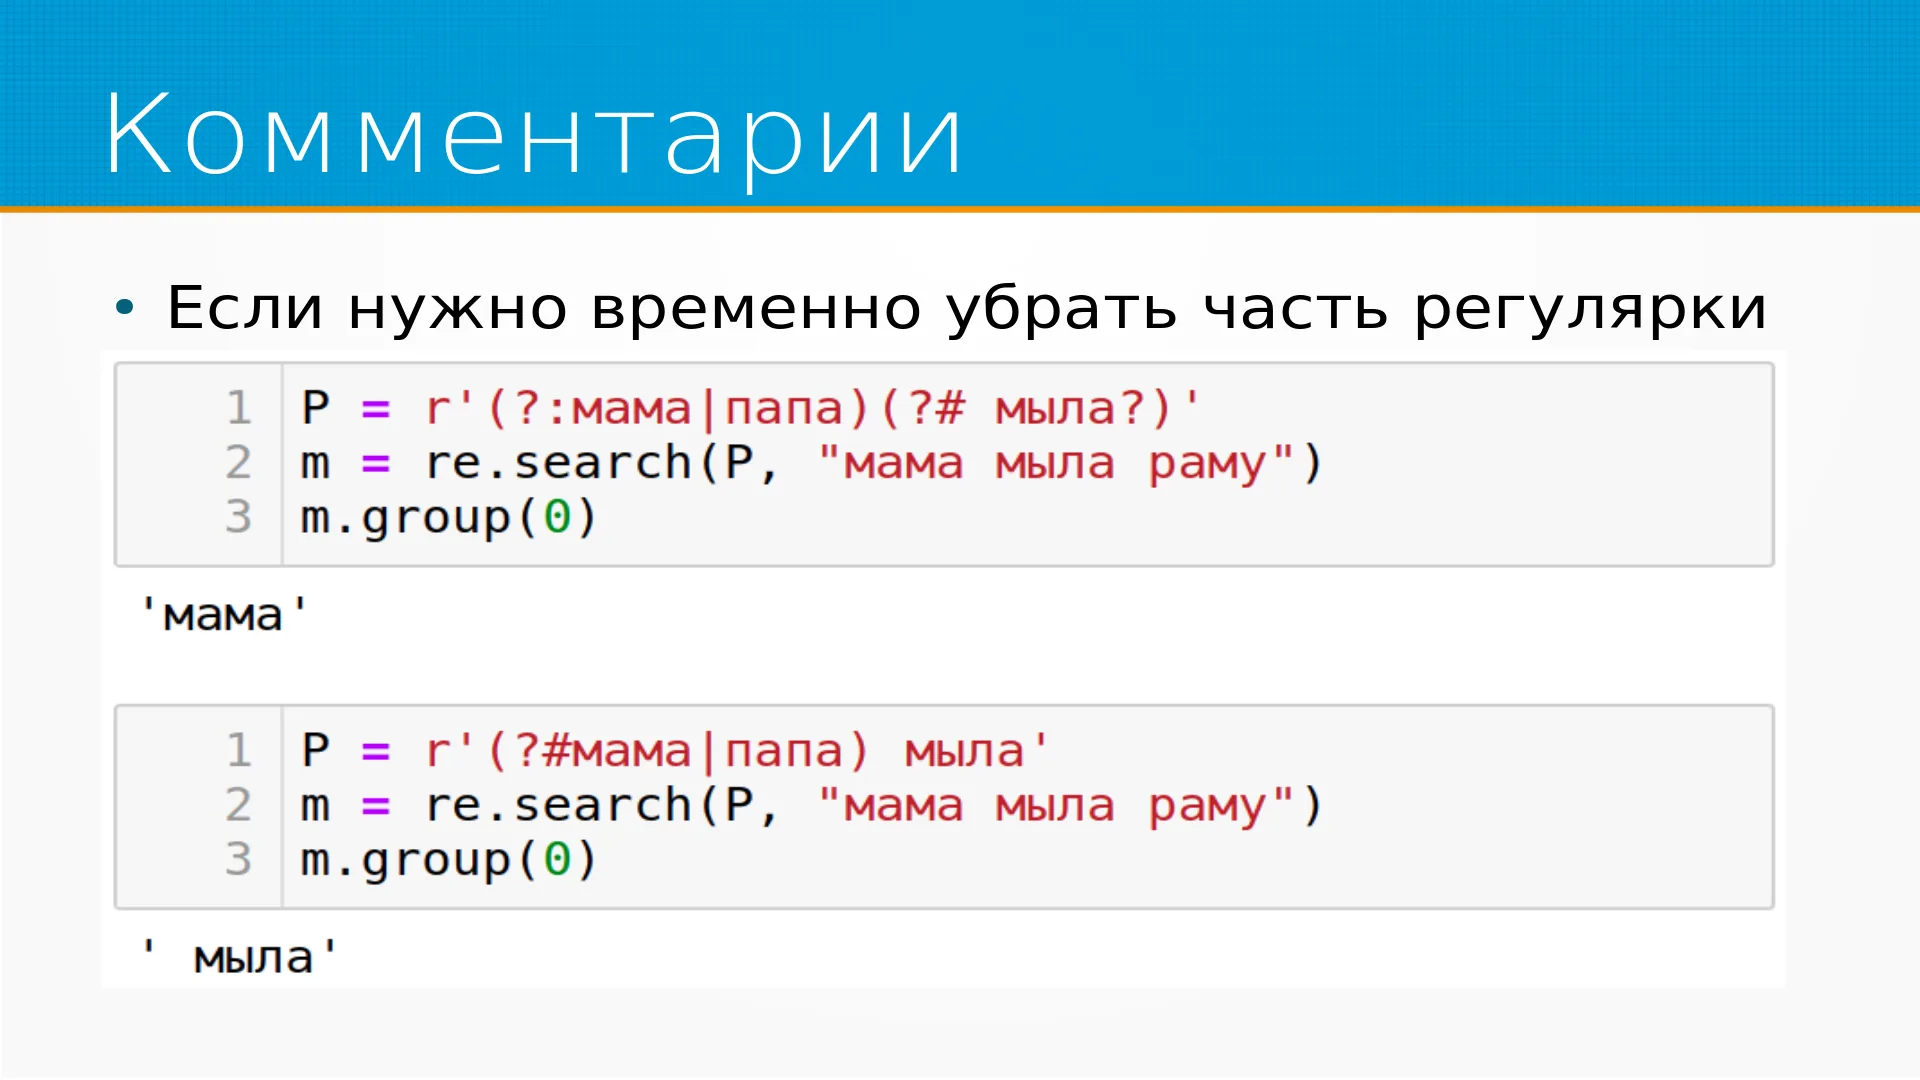
Иногда в длинных регулярных выражениях хочется взять и выкусить кусок. Можно, конечно, скопировать его, куда-нибудь вставить. Чтобы не забыть, где он стоял. Но есть специальный синтаксис, который позволяет часть регулярного выражения закомментировать. Это в скобках вопросительный знак и Решётка. Аппарат регулярных выражений игнорирует тот кусок, который закомментирован.
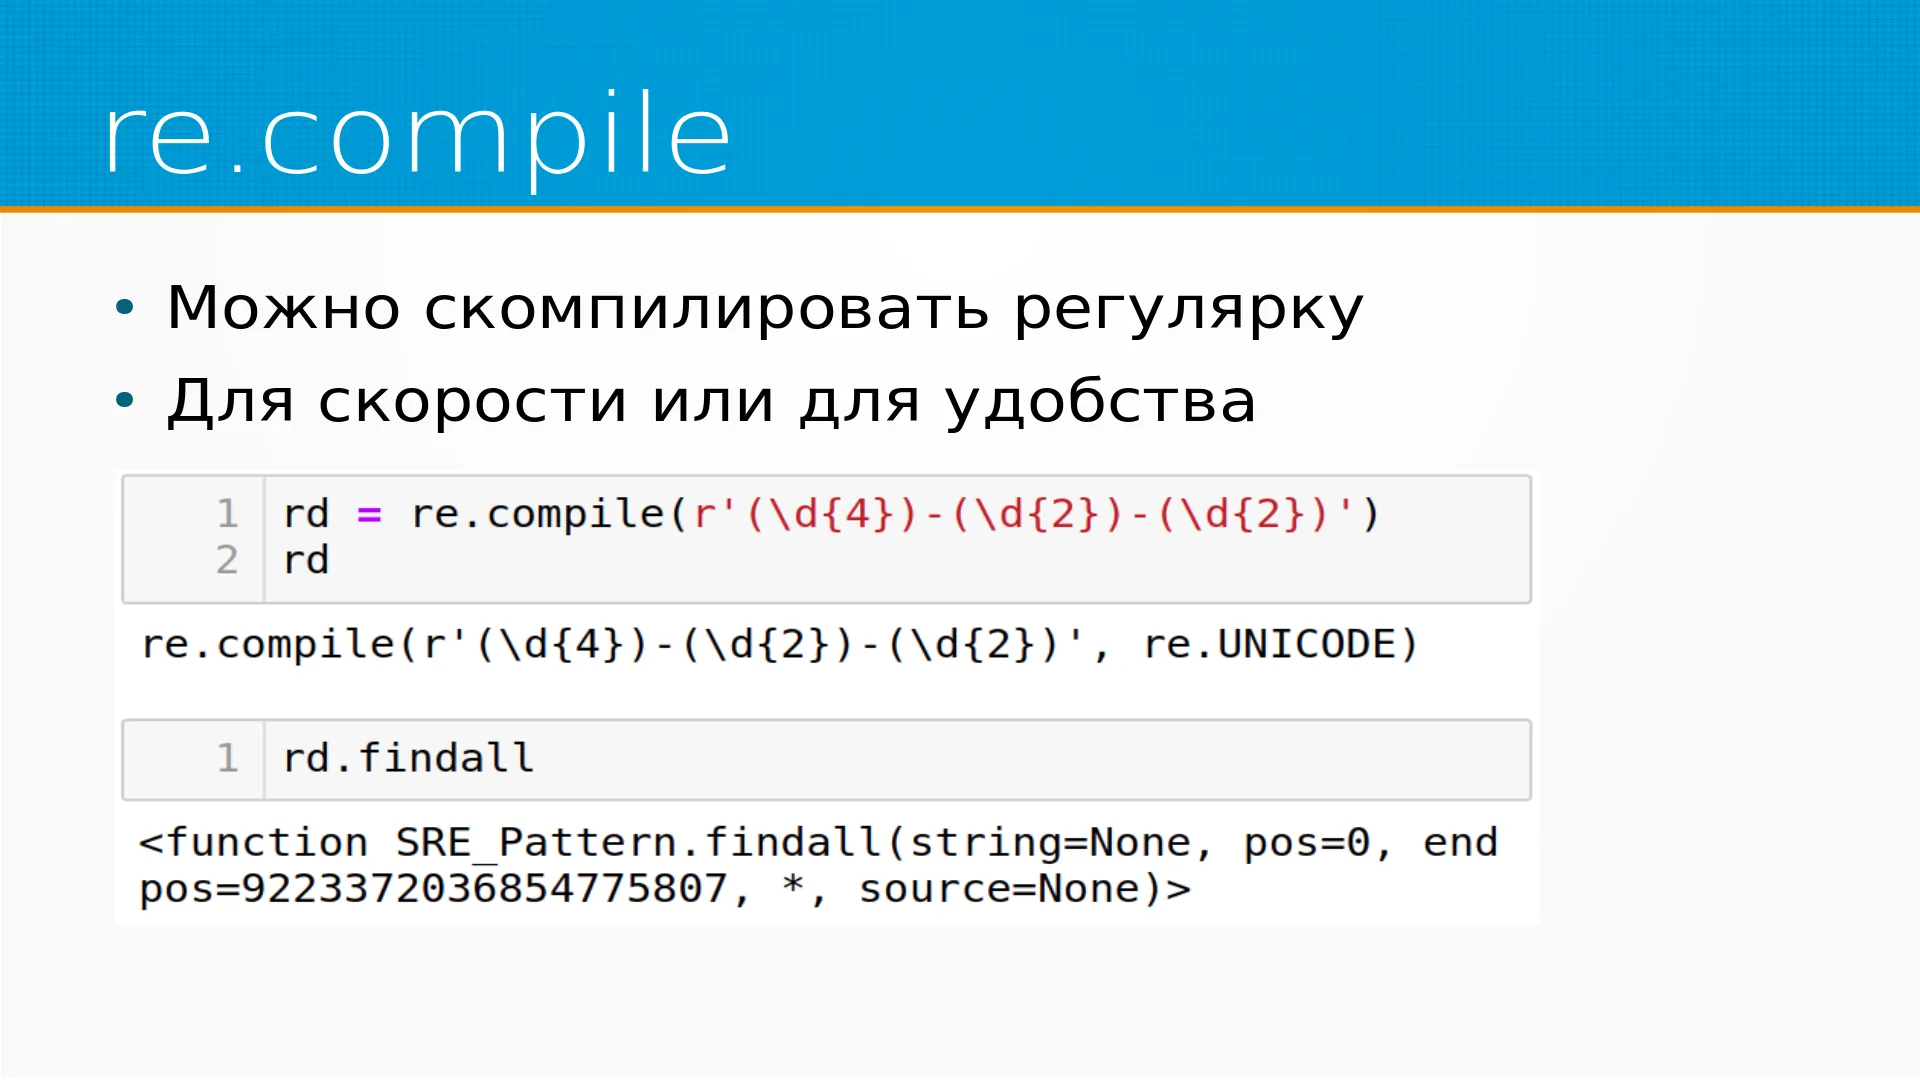
Мы можем скомпилировать наше регулярное выражение для того, чтобы оно быстрее работало. Но обычно для скорости это не используют, используют это для удобства. Мы, например, у нас есть какая-нибудь функция, которая принимает на вход регулярное выражение скомпилированное. Мы его скомпилировали, туда отправили, и вот он вызывают. В принципе, компиляция регулярного выражения занимает некоторое время, но машина регулярных выражений кэширует их. Современный Python кэширует 512 последних вычисленных регулярных выражений, и 512 хватает почти всем. В результате компиляции вы получаете, а, объект компилированный шаблон, которым вы дальше можете пользоваться точно так же, как и не скомпилированным регулярным выражением, только быстрее.
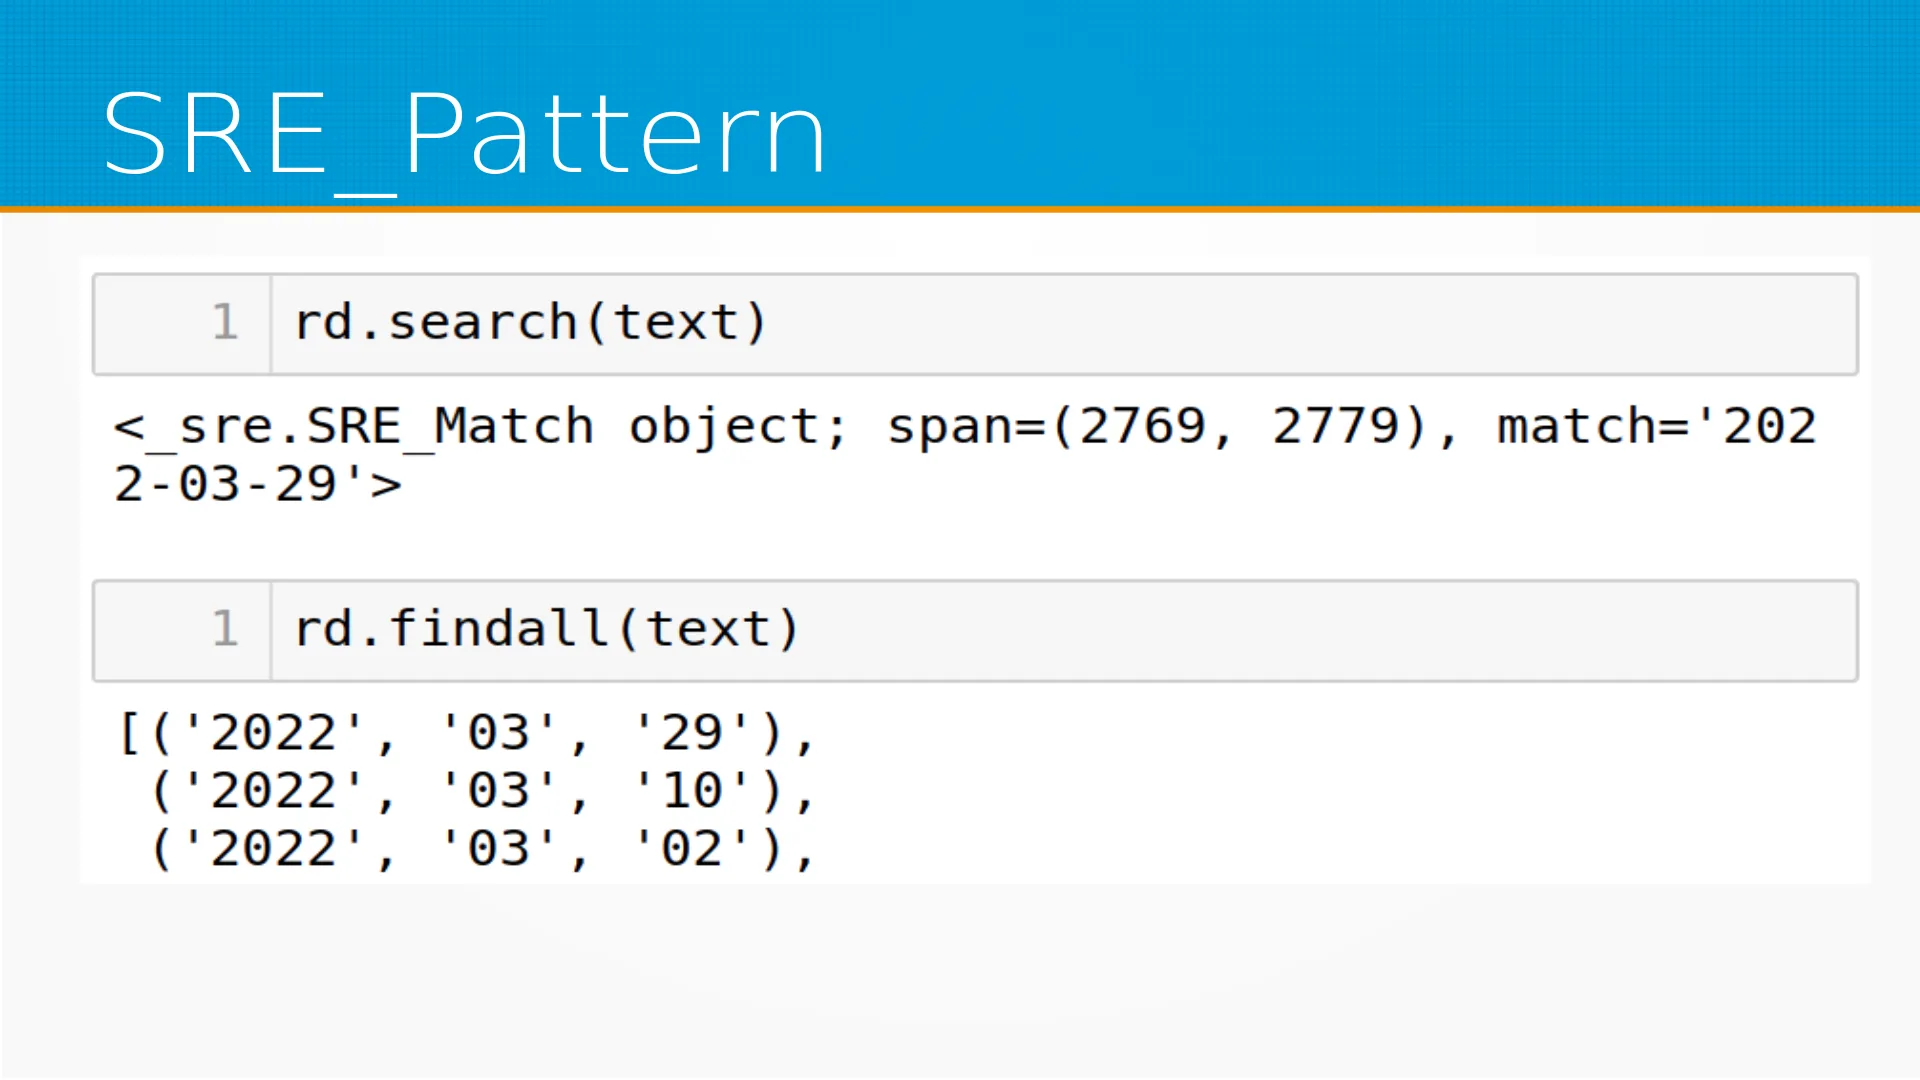
Вызывать у него метод search, вызывать метод find all, то есть скомпилированное регулярное выражение, оно не прибинжено к методу, это именно регулярное выражение скомпилированное, вы его можете с разными методами потом
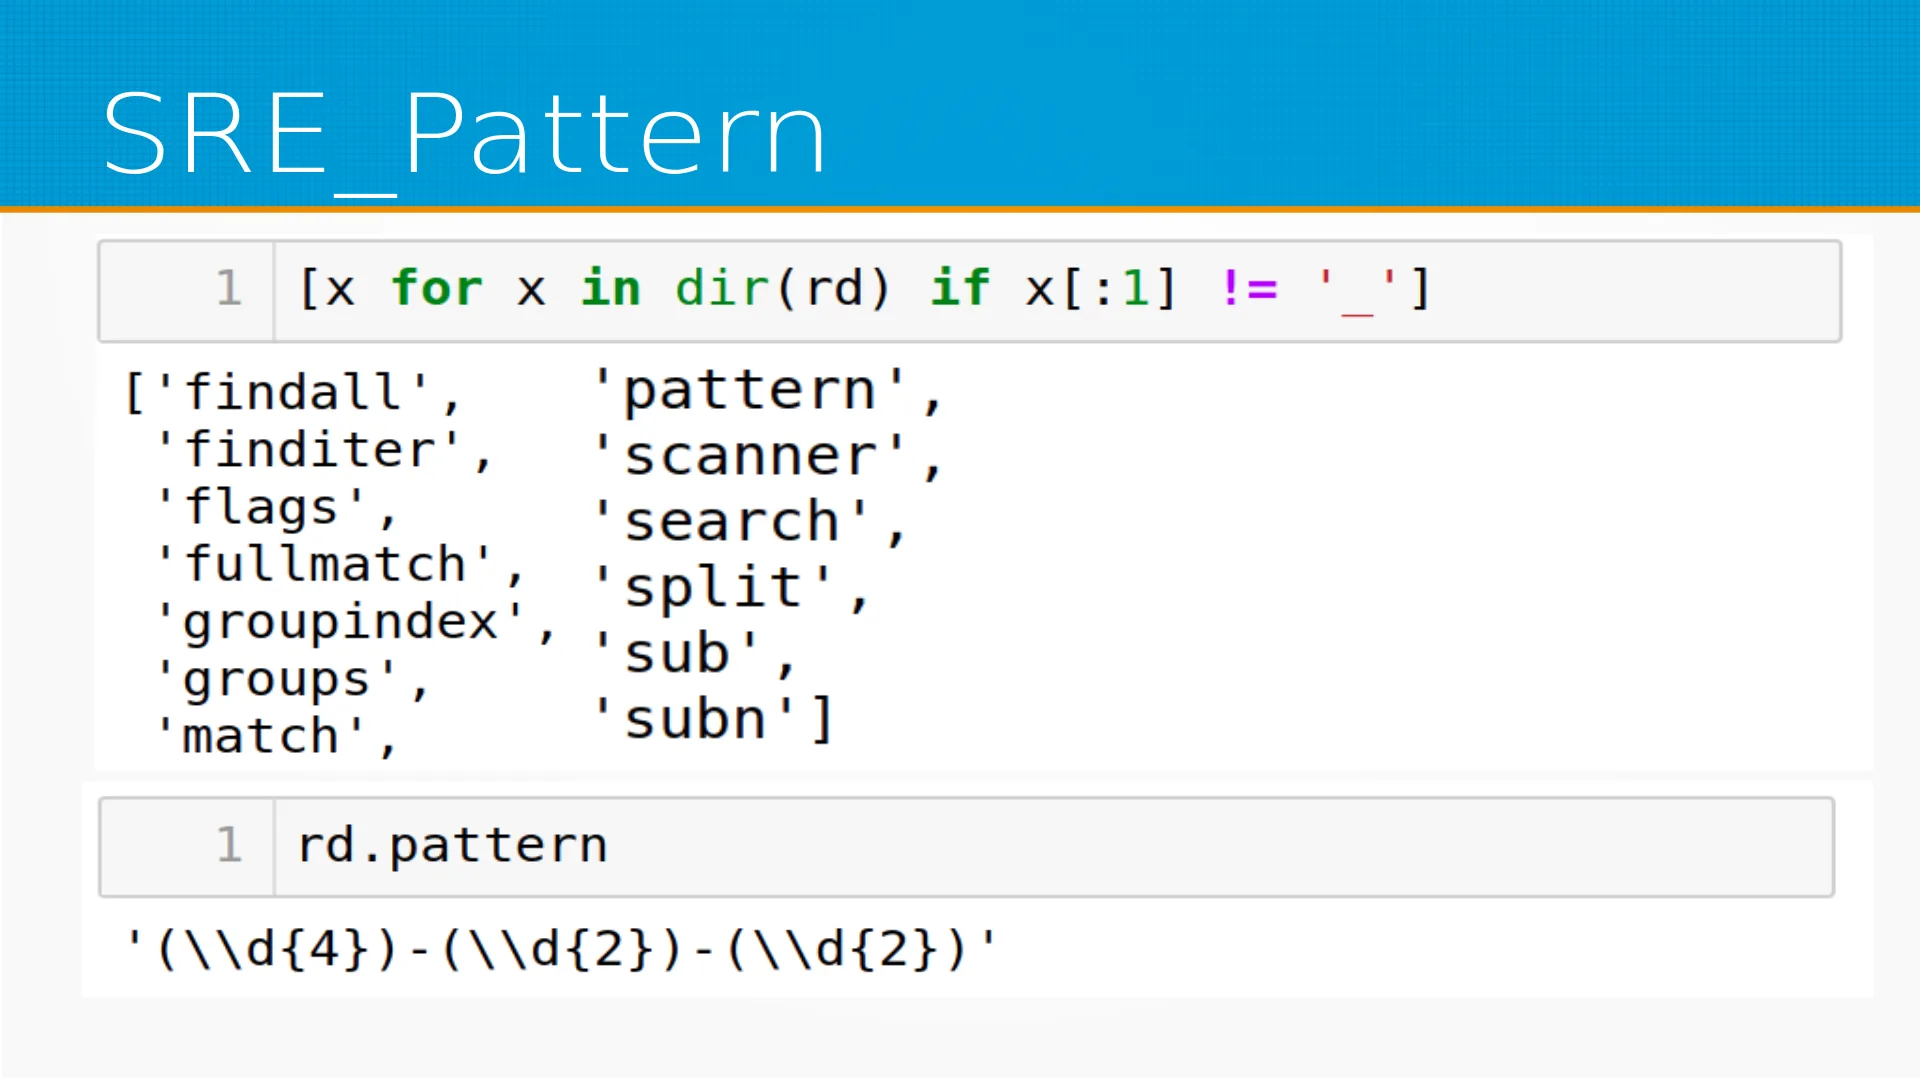
вызывать. И его методы этого объекта скомпилированное регулярное выражение, в общем, вот те же самые, то есть find, find iter, match и так далее. Специальный метод pattern позволяет получить исходники регулярного выражения, то есть из чего оно было скомпилировано.
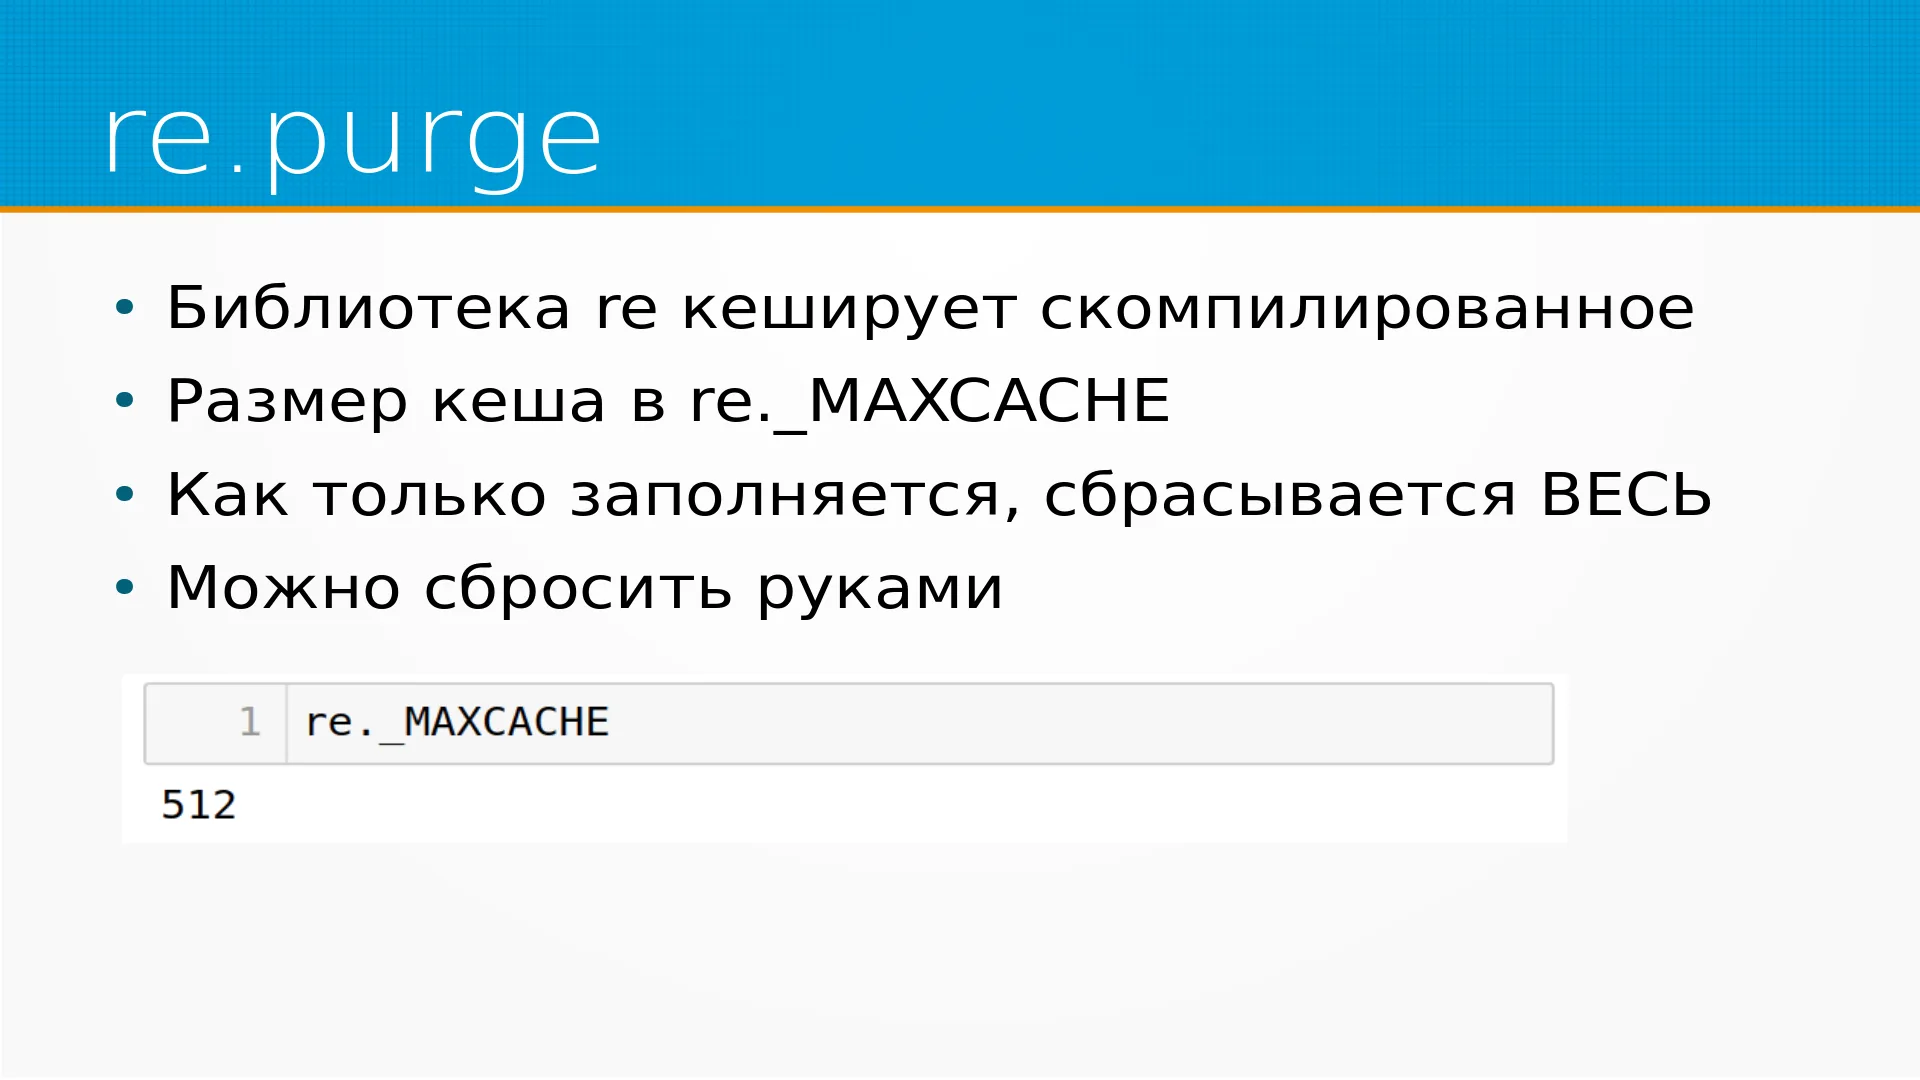
Если мы пишем какой-то сложный разборщик, иногда у нас получается засорение кэша, типа мы зашли в какую-нибудь ветку нашей программы, и много-много регулярных выражений у нас там пролетело, мы весь кэш вытеснили, и через это оно будет тупить. И мы можем явно очищать кэш регулярных выражений, если мы точно знаем, что вот те, которые мы туда запихали, больше нам не понадобятся. Зачем это может быть нужно? Как только регулярные выражения, а, регулярные выражения скомпилировали мы их или просто вызвали в коде, они попадают в кэш. Как только кэш заполняется, как только мы отработали 512 регулярных выражений, кэш сбрасывается весь. Не замещается, не сдвигается, а именно очищается, и снова у нас пустой кэш. Это может быть неожиданно и неудобно.
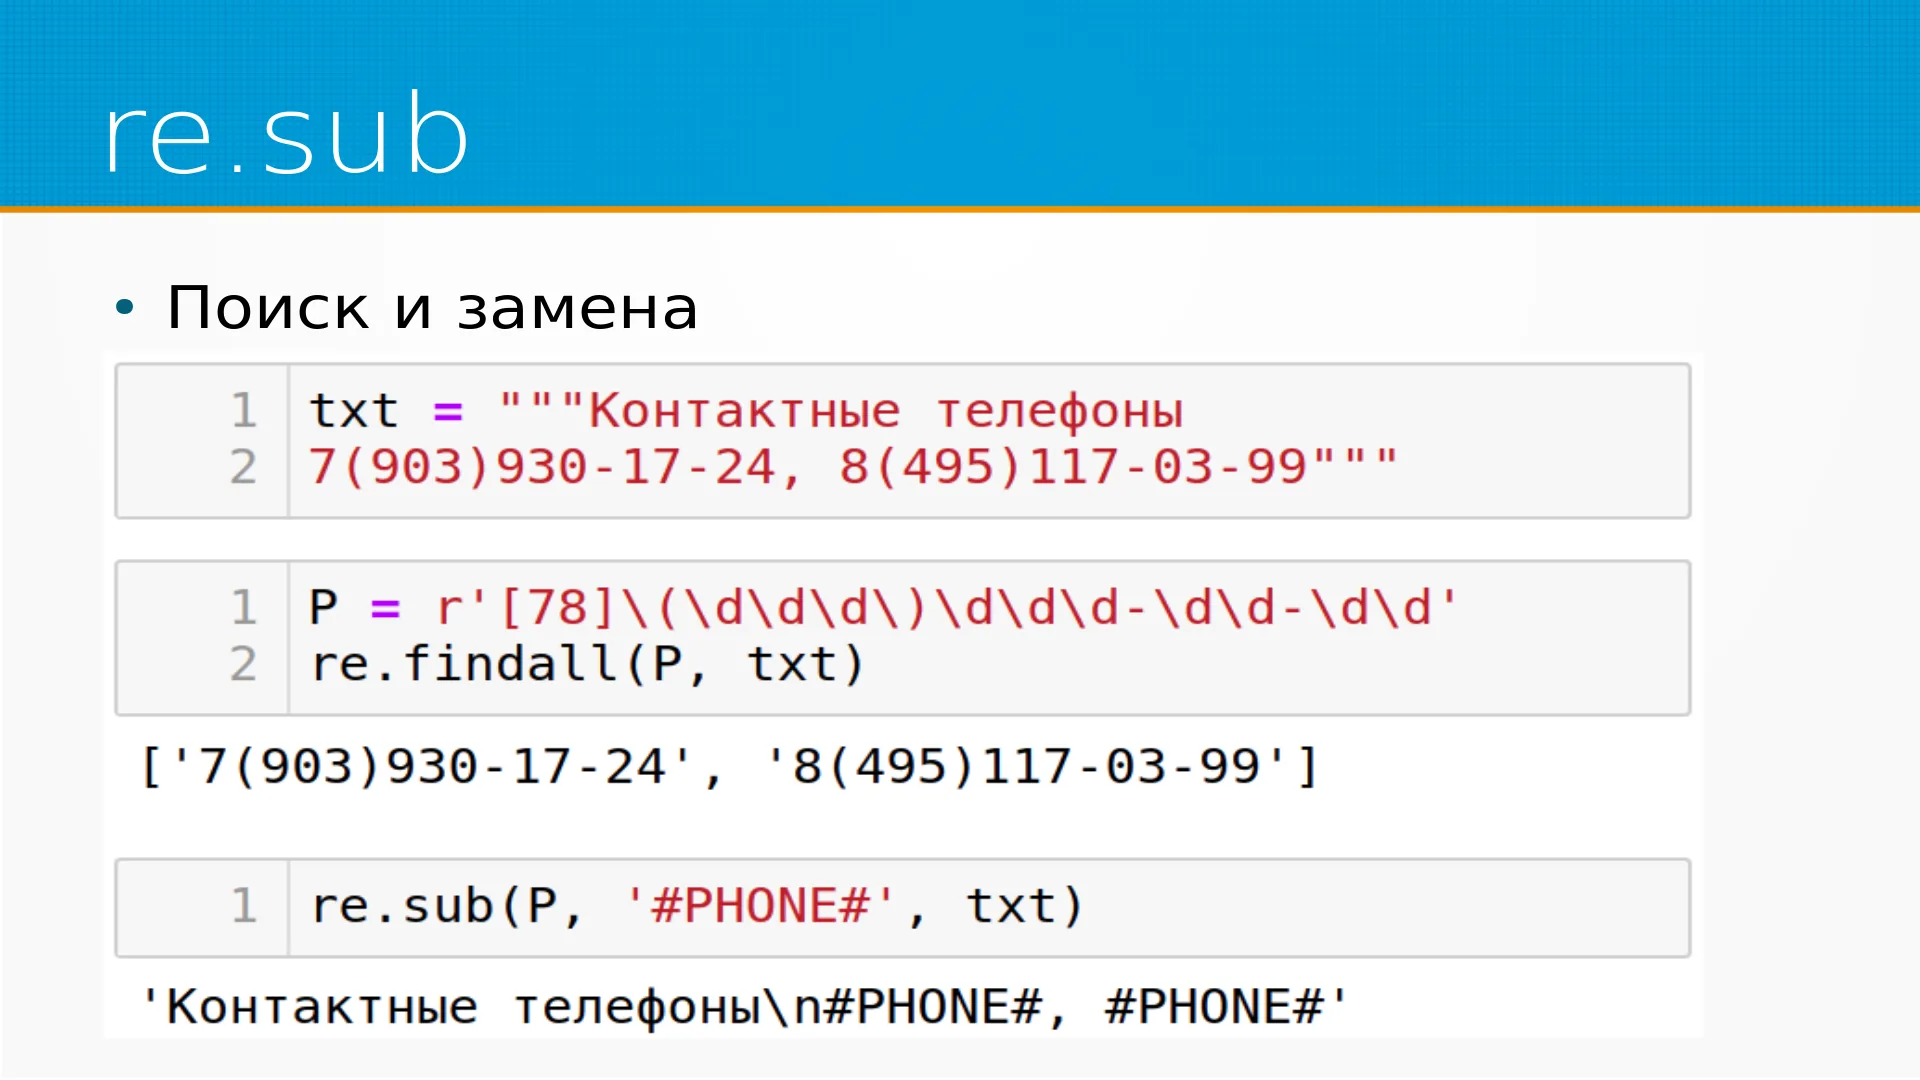
Регулярные выражения можно использовать для поиска и замены. Например, для анонимизации текста или для чистки датасетов, то есть для удаления спецсимволов, он часто применяется. Вот, например, пример, где мы, а, телефоны заменяем на placeholder. Например, для обучения языковой модели.
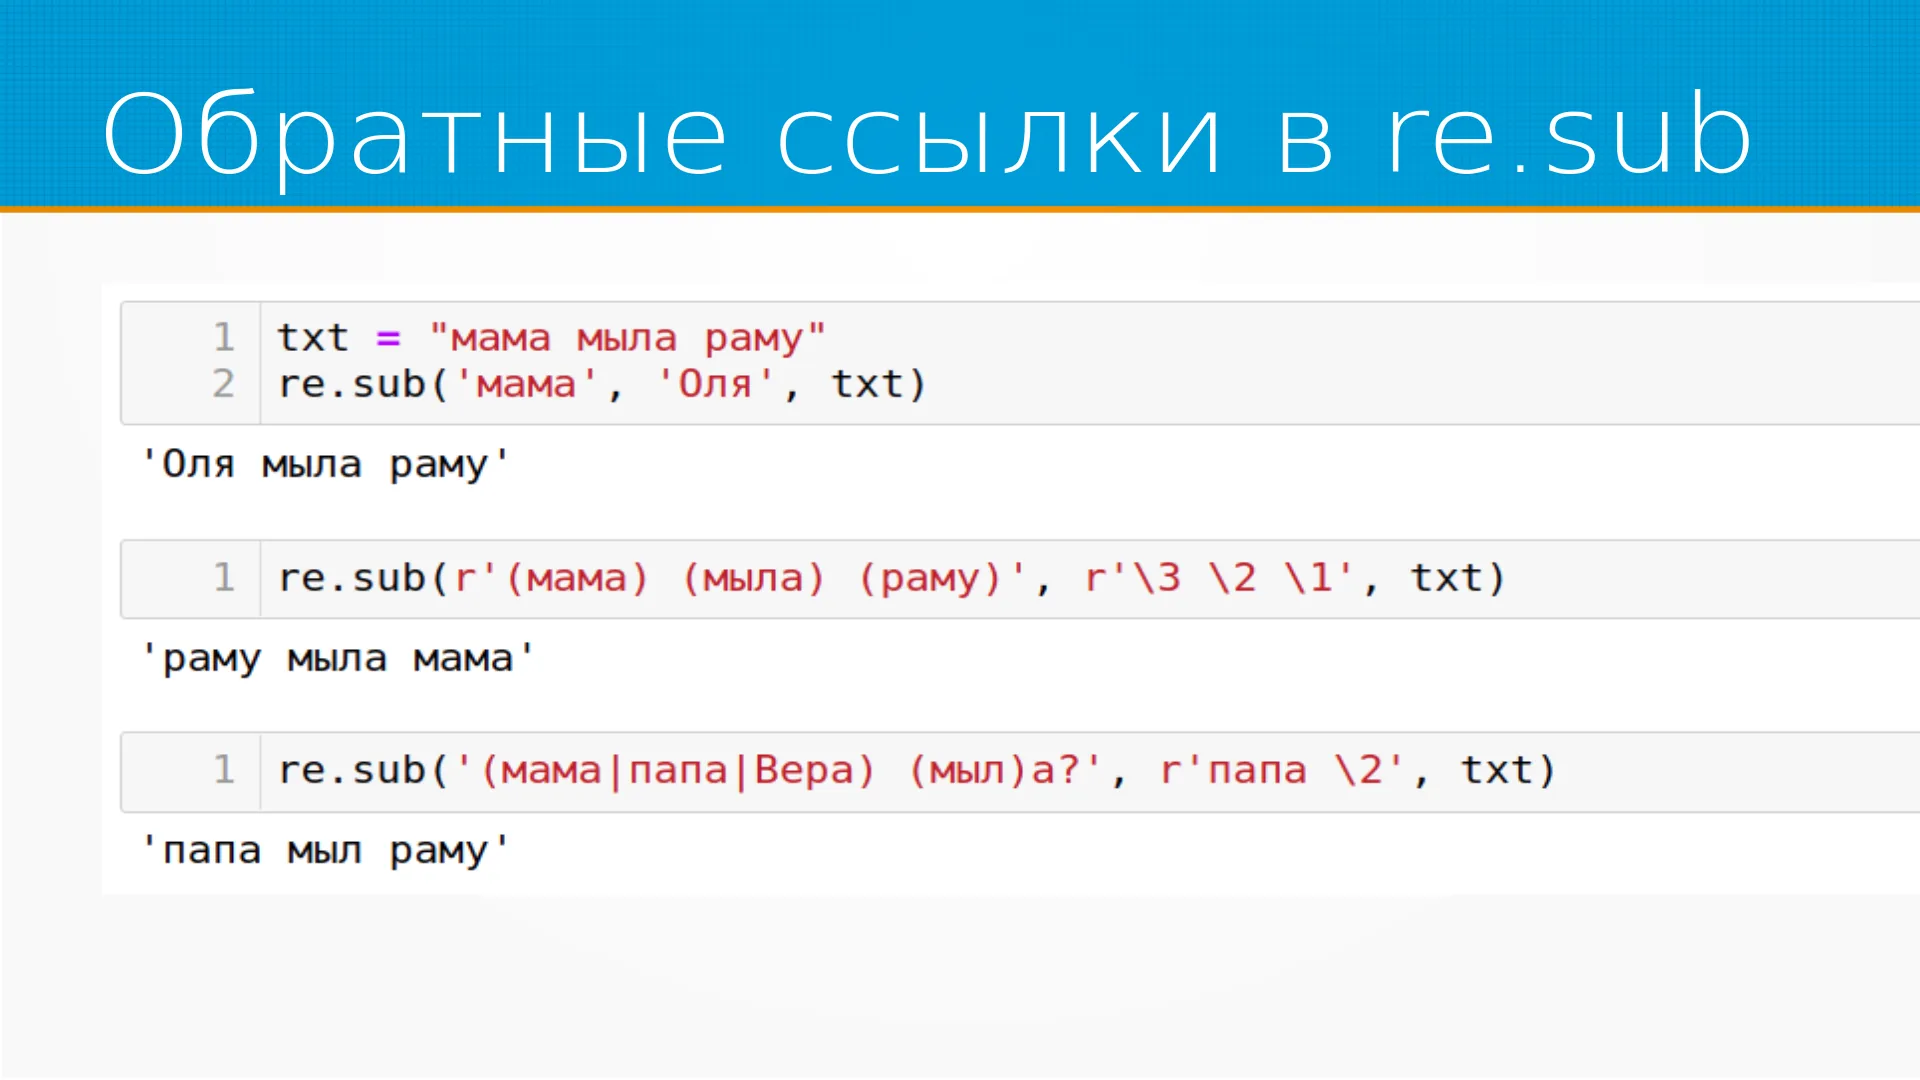
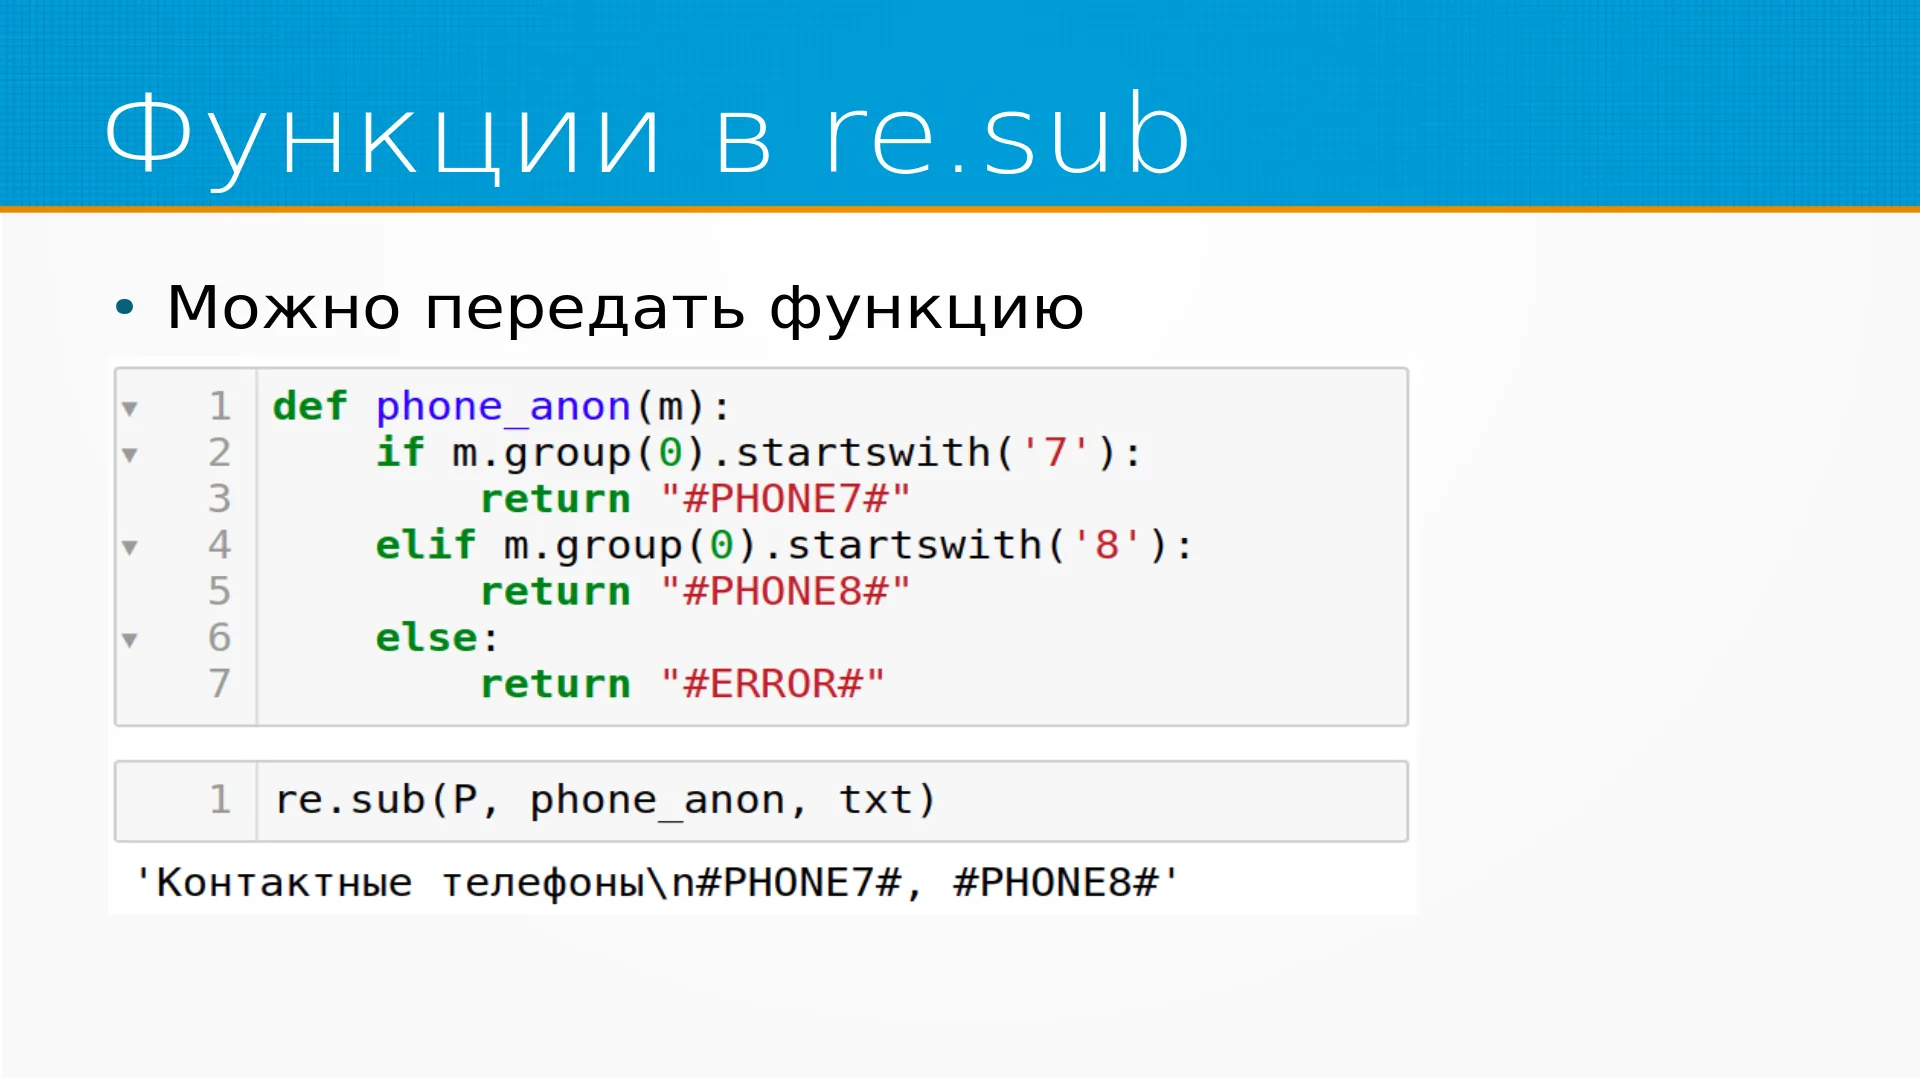
В re.sub мы можем передать строку, на которую заменять. Ещё мы в re.sub можем передать функцию. И тогда регулярное выражение каждый раз, когда они найдут совпадение с нашим регулярным выражением, они вызовут нашу функцию и спросят её, на что же, собственно говоря, заменить. И вот здесь мы, если телефон начинался с семёрки, заменяем его на placeholder phone 7, если с восьмёрки, на phone 8.
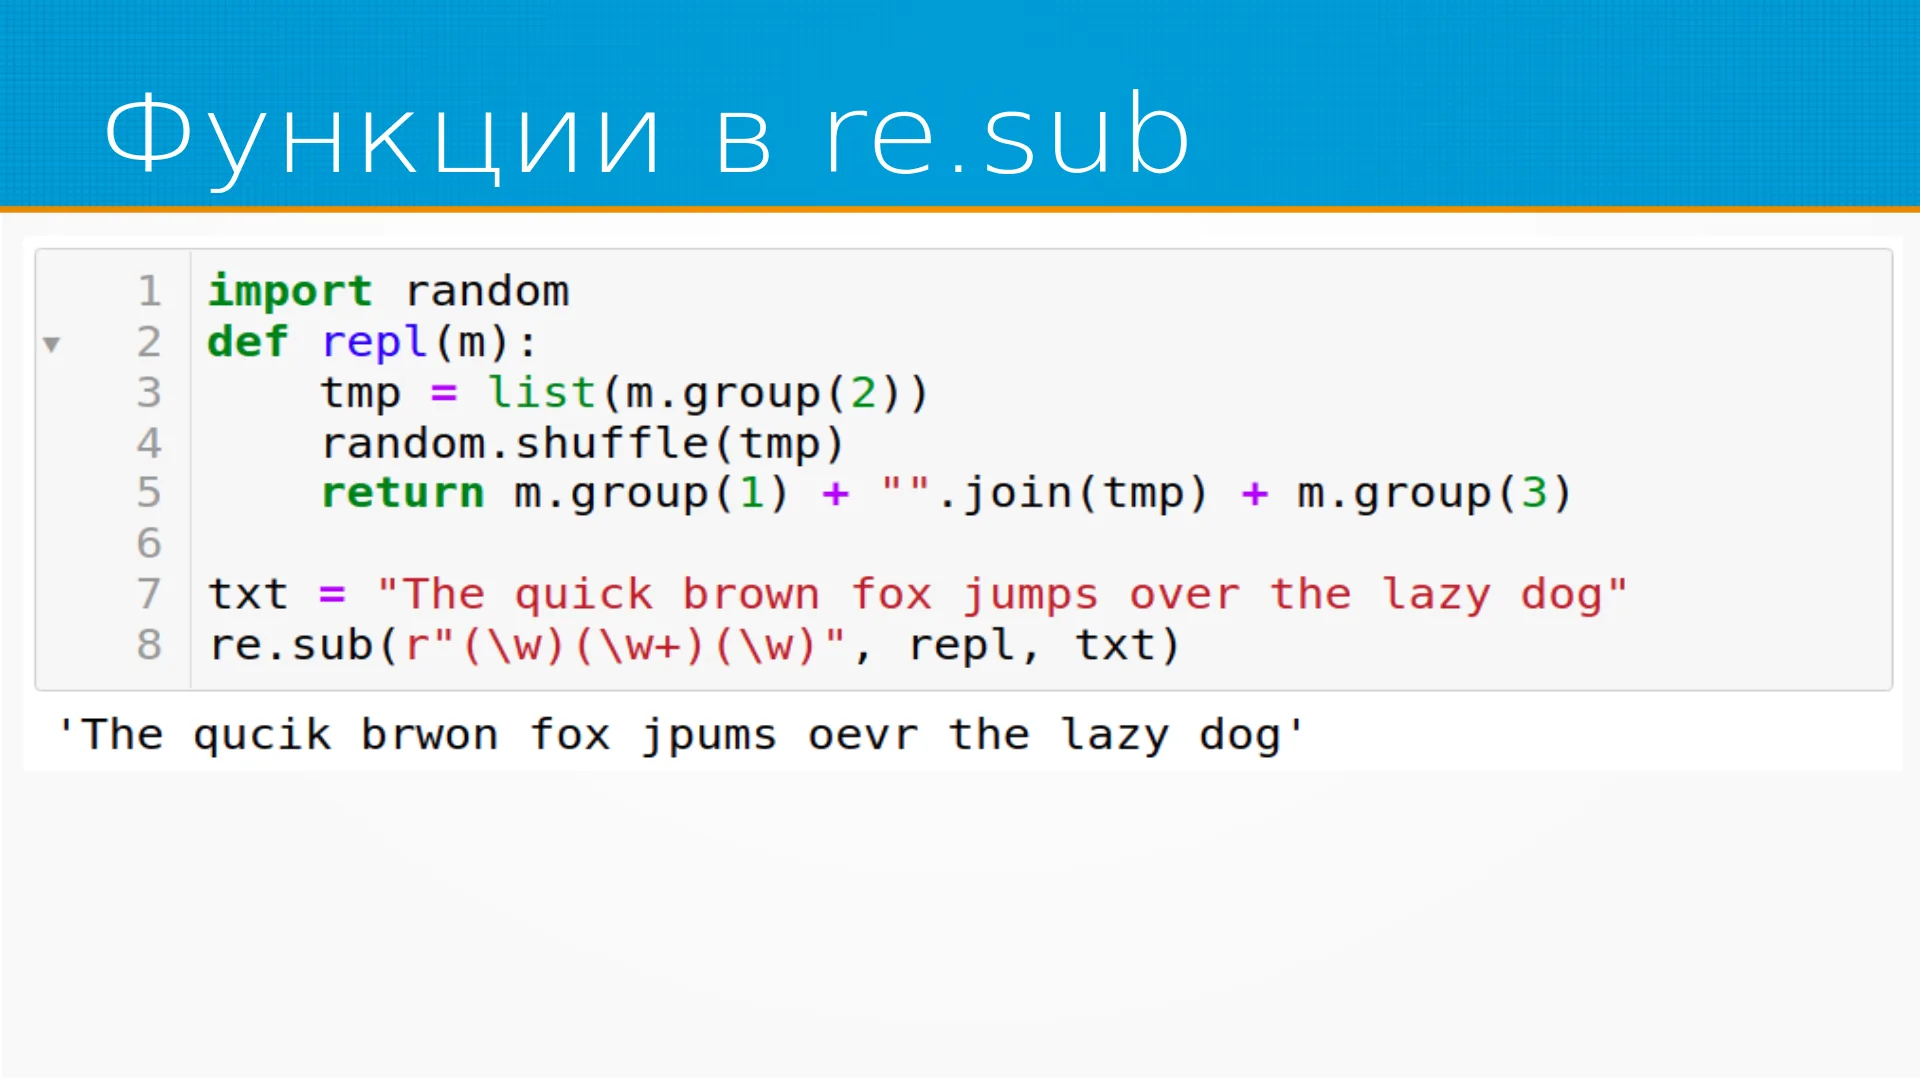
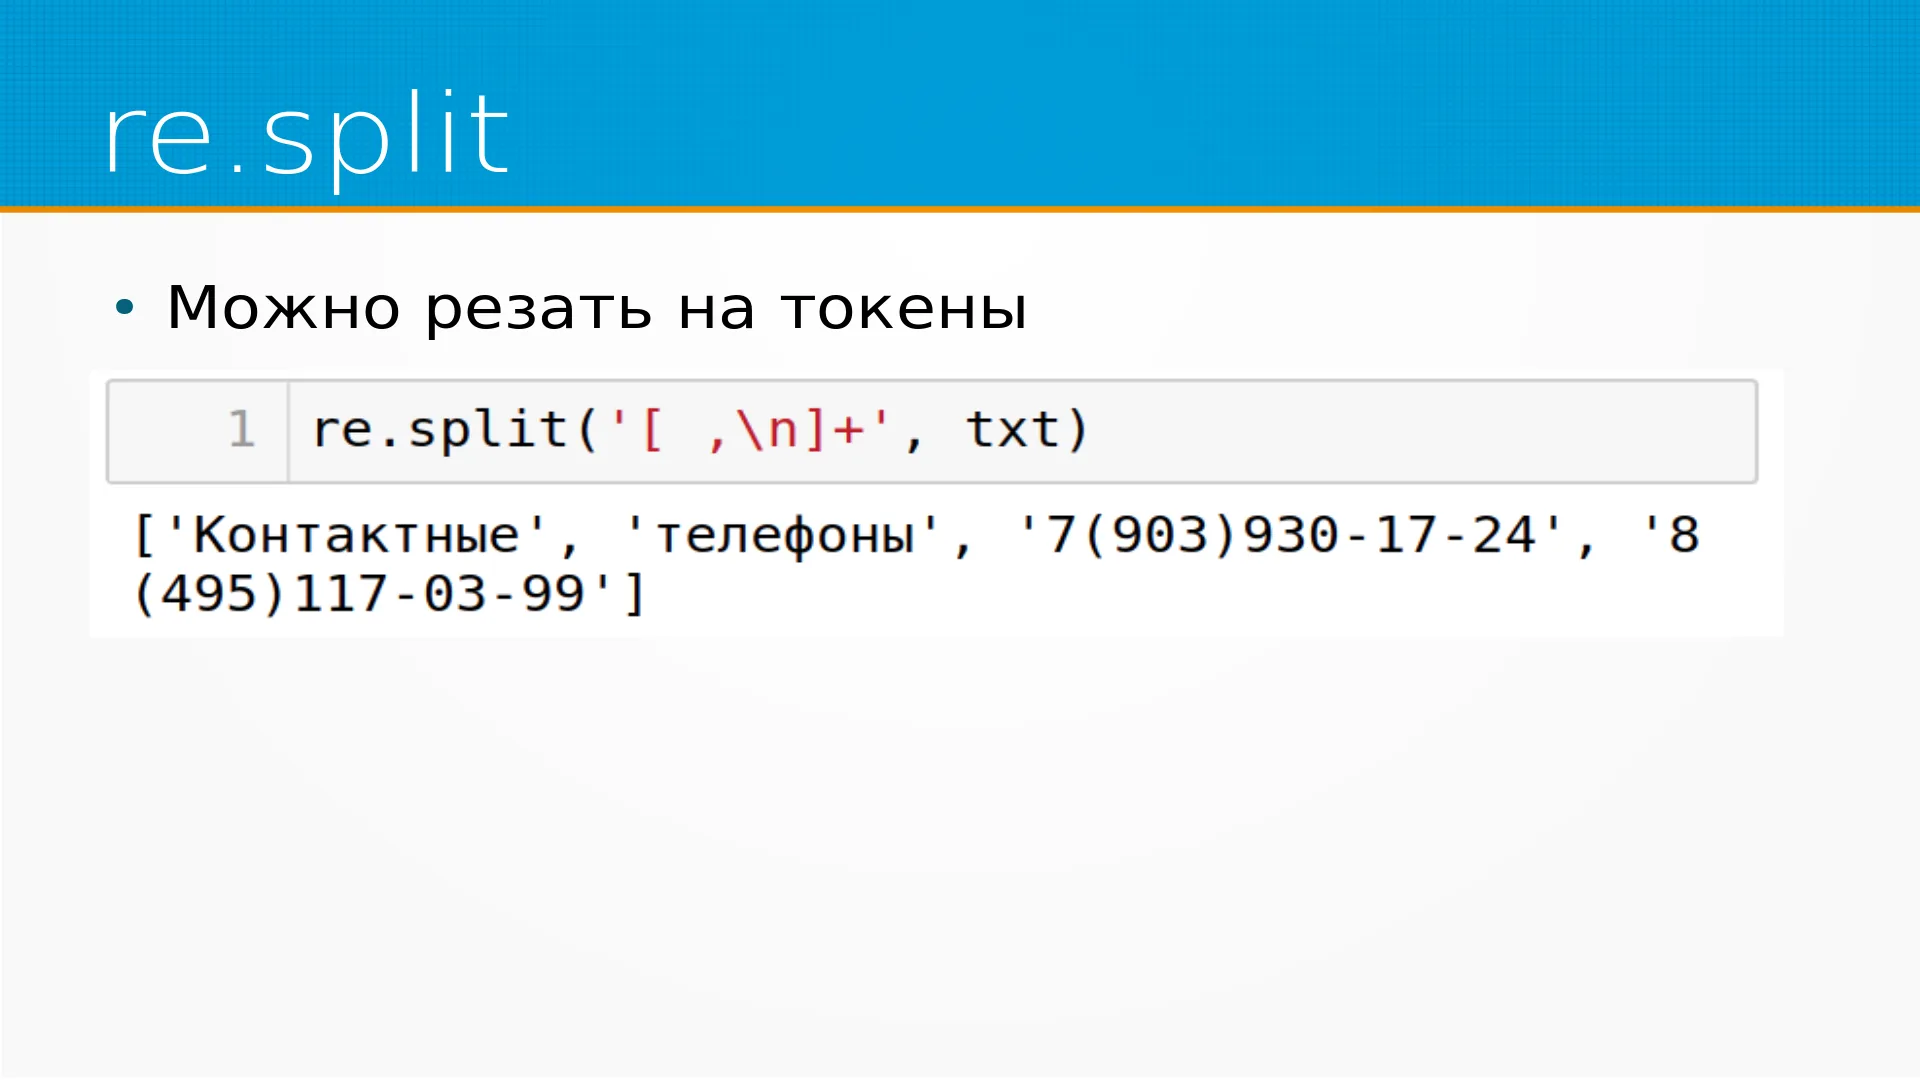
Функция re.split позволяет токенизировать, резать текст на кусочки. Например, вот этот в данном случае мы режем текст по пробелам, Знакам препинания и переводом строки.
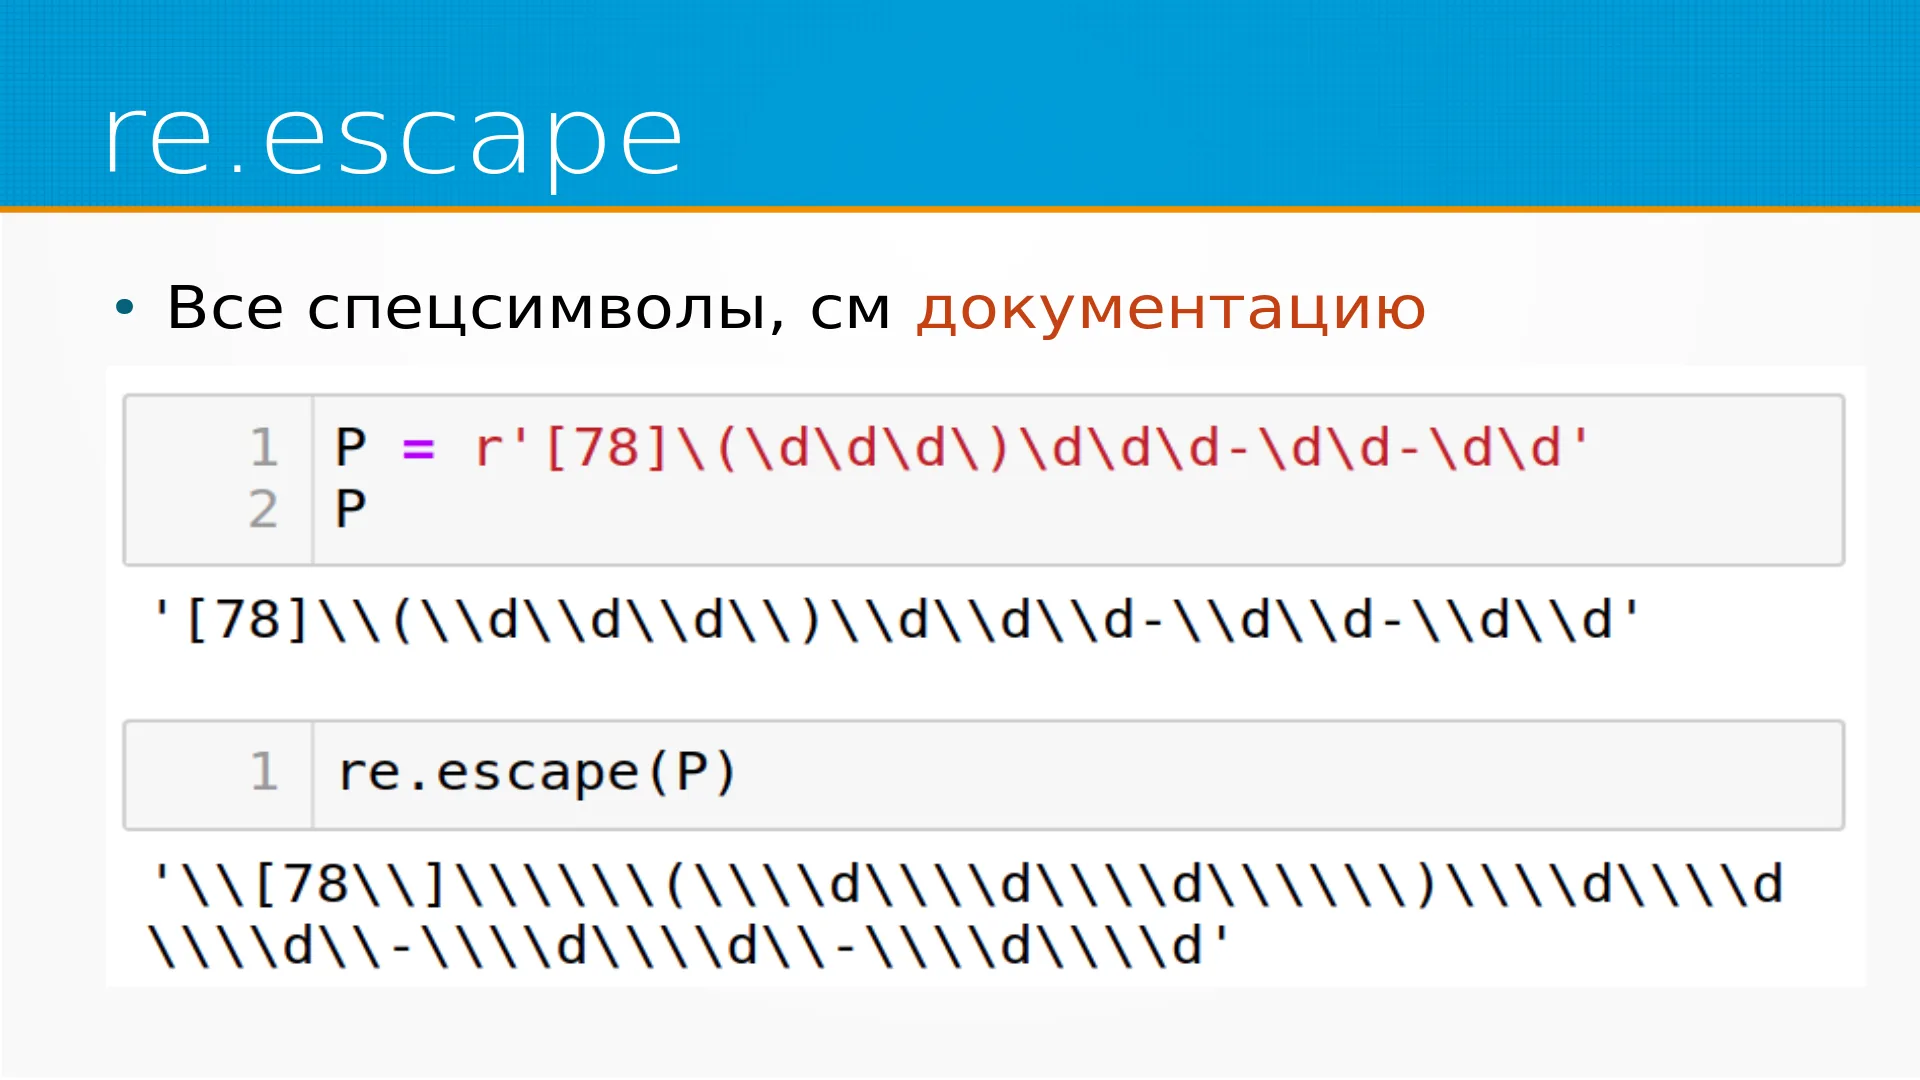
re.escape - это такая страховочная функция, если вы принимаете какой-то вывод и ожидаете, что он может попасть в регулярное выражение, и хотите помешать злоумышленнику устроить у вас какой-нибудь безобразие, вы можете вызывать re.escape, он гарантированно Эскейпит все символы, имеющие специальное значение для регулярных выражений. Вот тут мутный момент, что такое все символы, имеющие значение для регулярных выражений, это надо документацию смотреть, потому что в каждой версии Python это разный набор символов, как ни странно.
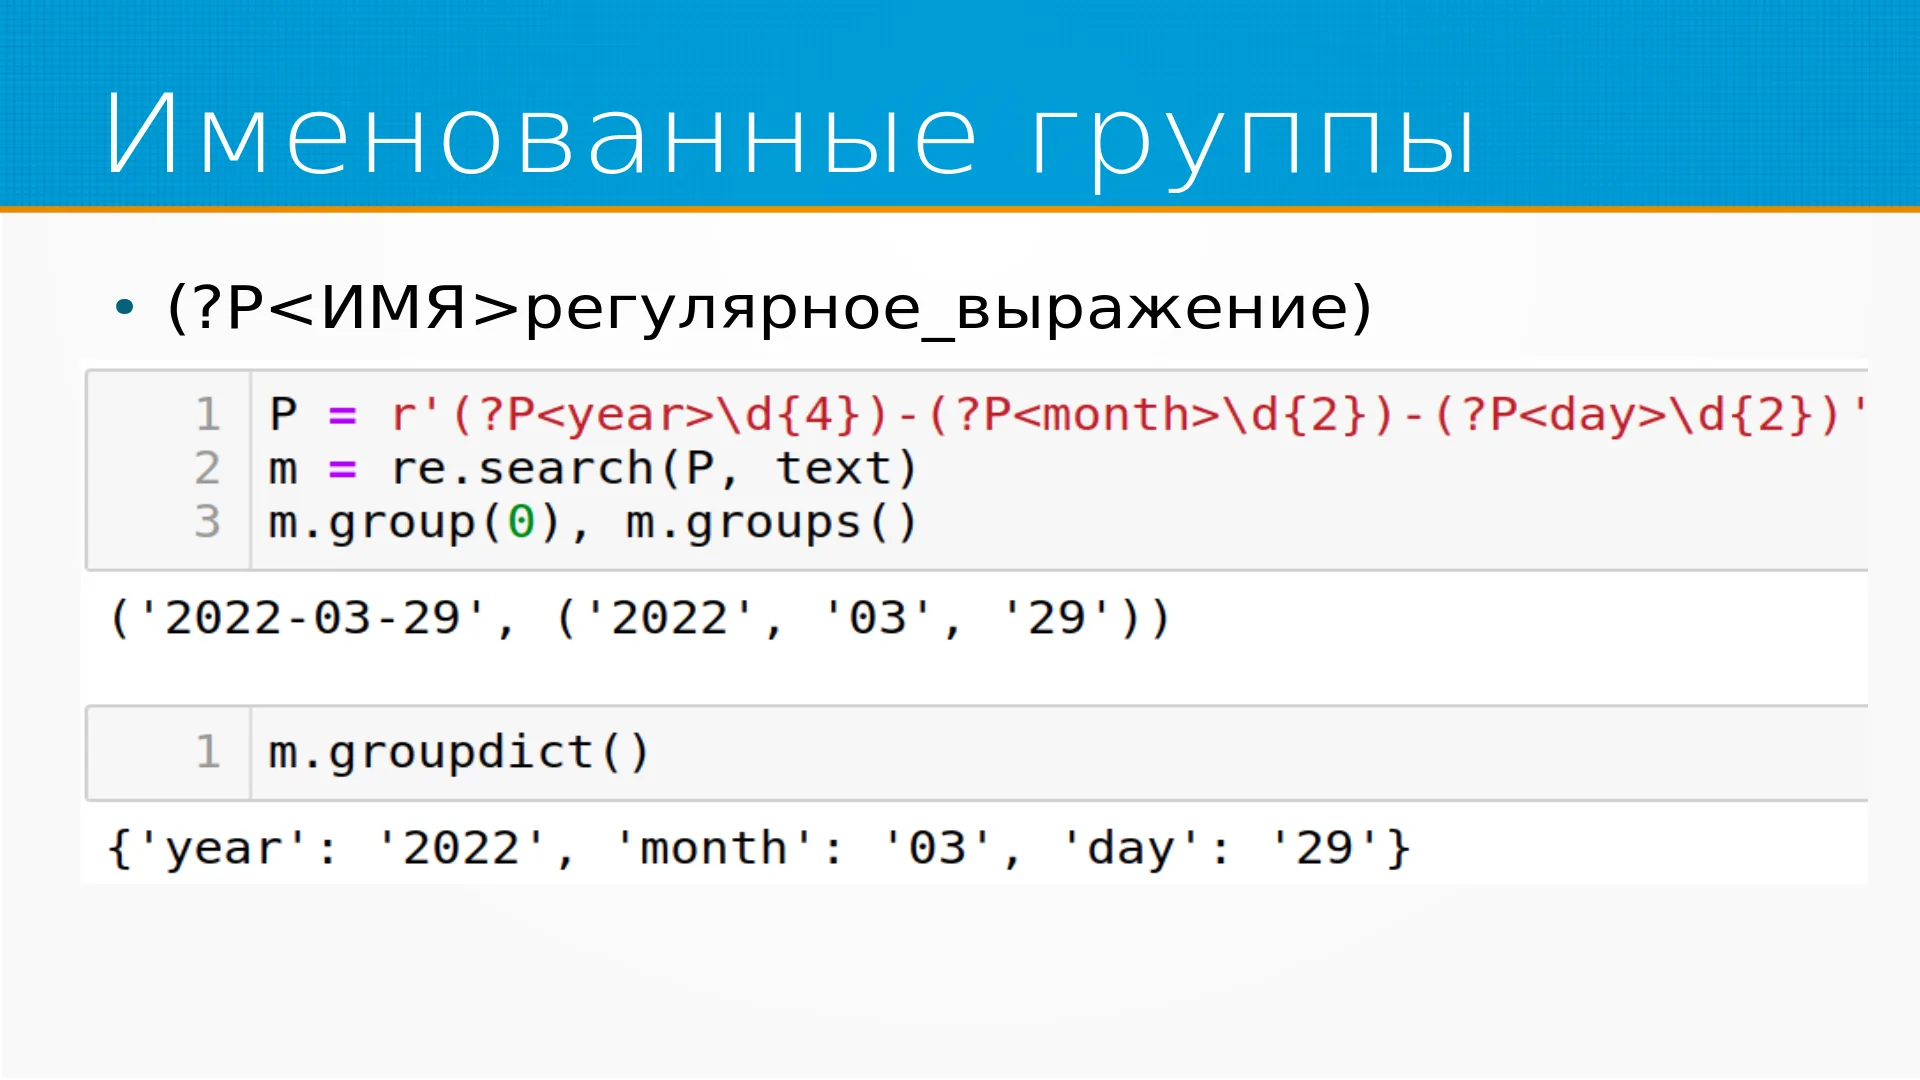
Обычно группы нумерованные. Первая совпавшая группа - это группа номер один, вторая совпавшая группа - номер два, третья - номер три. И когда вы пишете большие тяжёлые регулярные выражения, во-первых, он может быть неудобно. Группа, которую вы хотели бы использовать первой, например, она у вас в регулярном выражении стоит третьей. Во-вторых, его неудобно поддерживать. Вы что-нибудь дописали, поставили ещё скобки, и вам надо везде переправлять индексы, что было первой группой, станет второй и так далее и тому подобное. В Python есть возможность задавать именованные группы. Именованная группа - это группа с помеченной вопросительным знаком P и в угловых скобках имя группы. Вот здесь мы объявляем три именованные группы: год, месяц, день, и вытаскиваем их, эти группы. С ним к ним можно также обращаться по порядку.
Но можно обращаться к ним по имени. Можно дёрнуть groups dict, и нам вернётся словарь с этими группами.
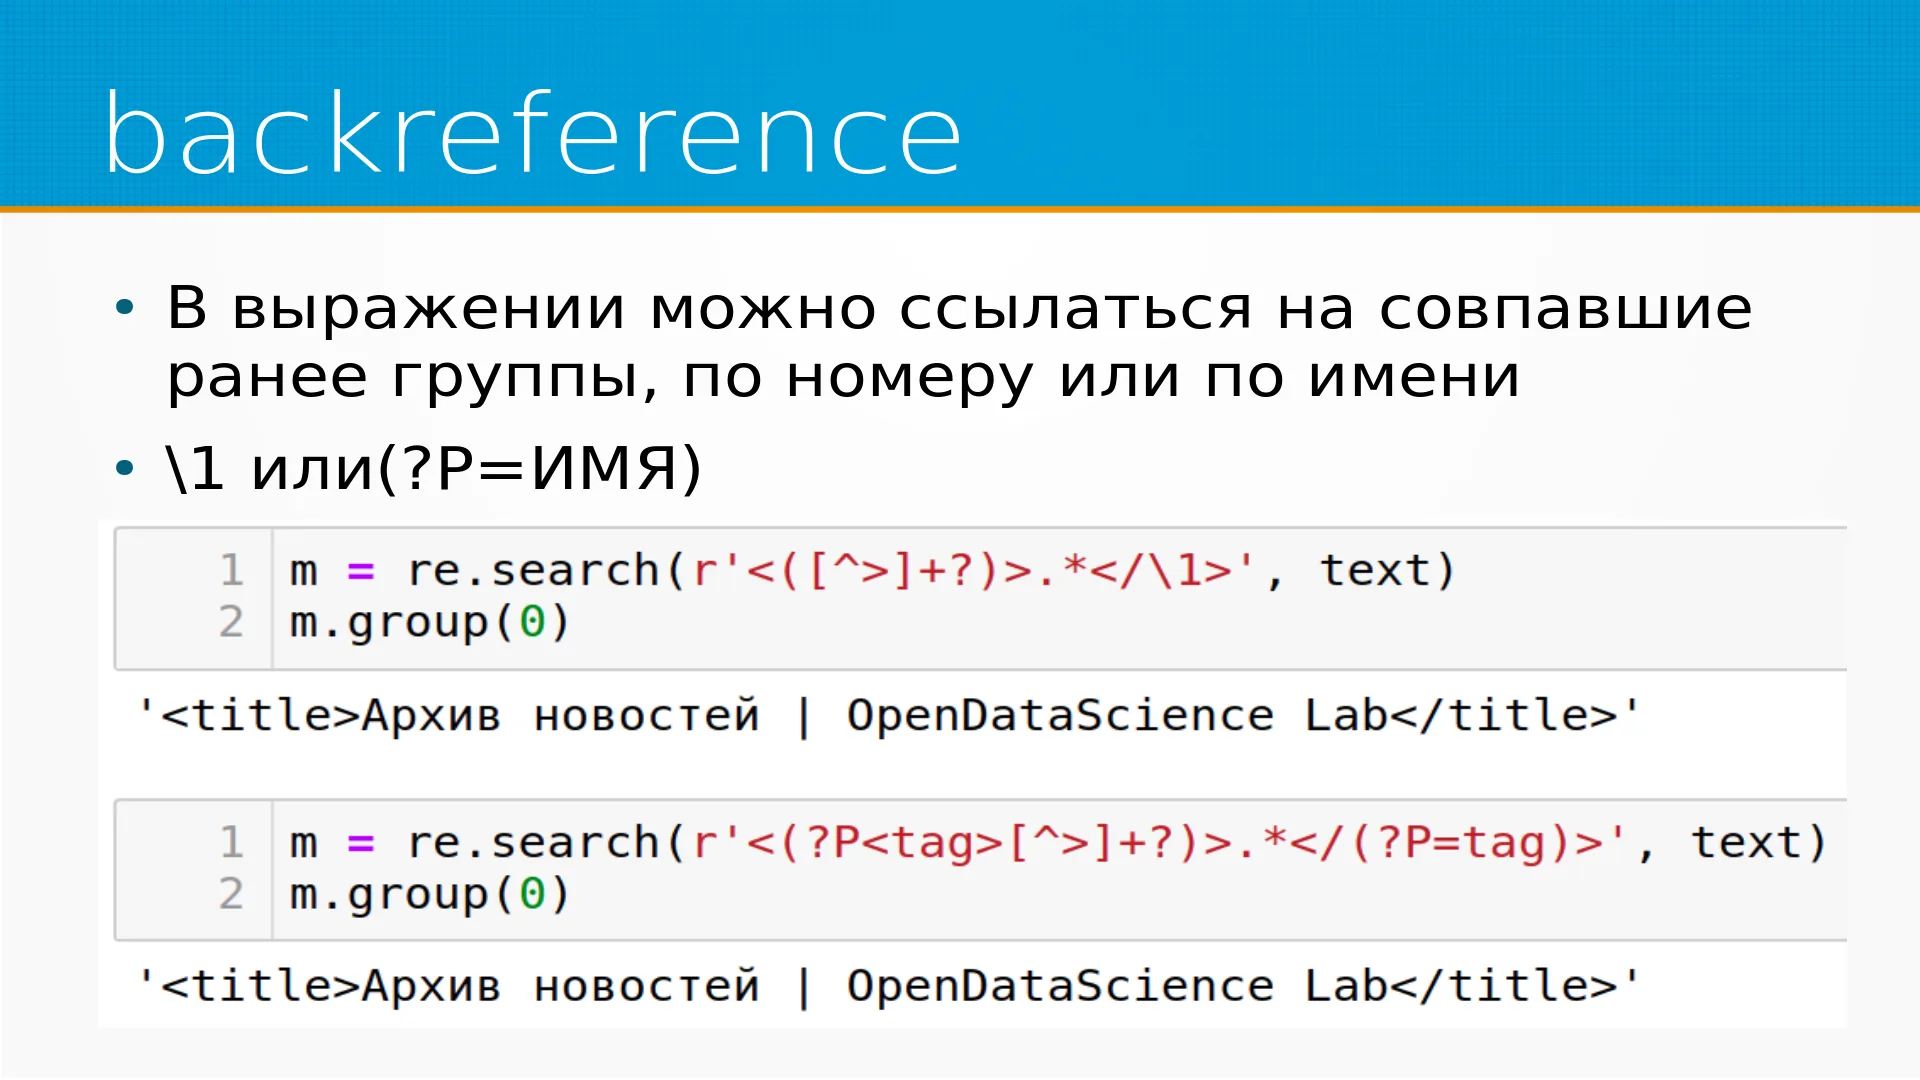
В самом регулярном выражении можно ссылаться на совпавшие ранее группы. Например, по Открытому тегу находиться соответствующий ему закрытый. Можно ссылаться по номеру совпавшей группы или по её имени. Вот, например, здесь это регулярное выражение ищет первую пару тегов, которая у нас есть на сайте. Первая пара тегов - это title. Причём мы можем как ссылаться на них обратная косая 1, то есть первая совпавшая группа, так и мы можем эту группу именованную сделать группа tag, и тогда
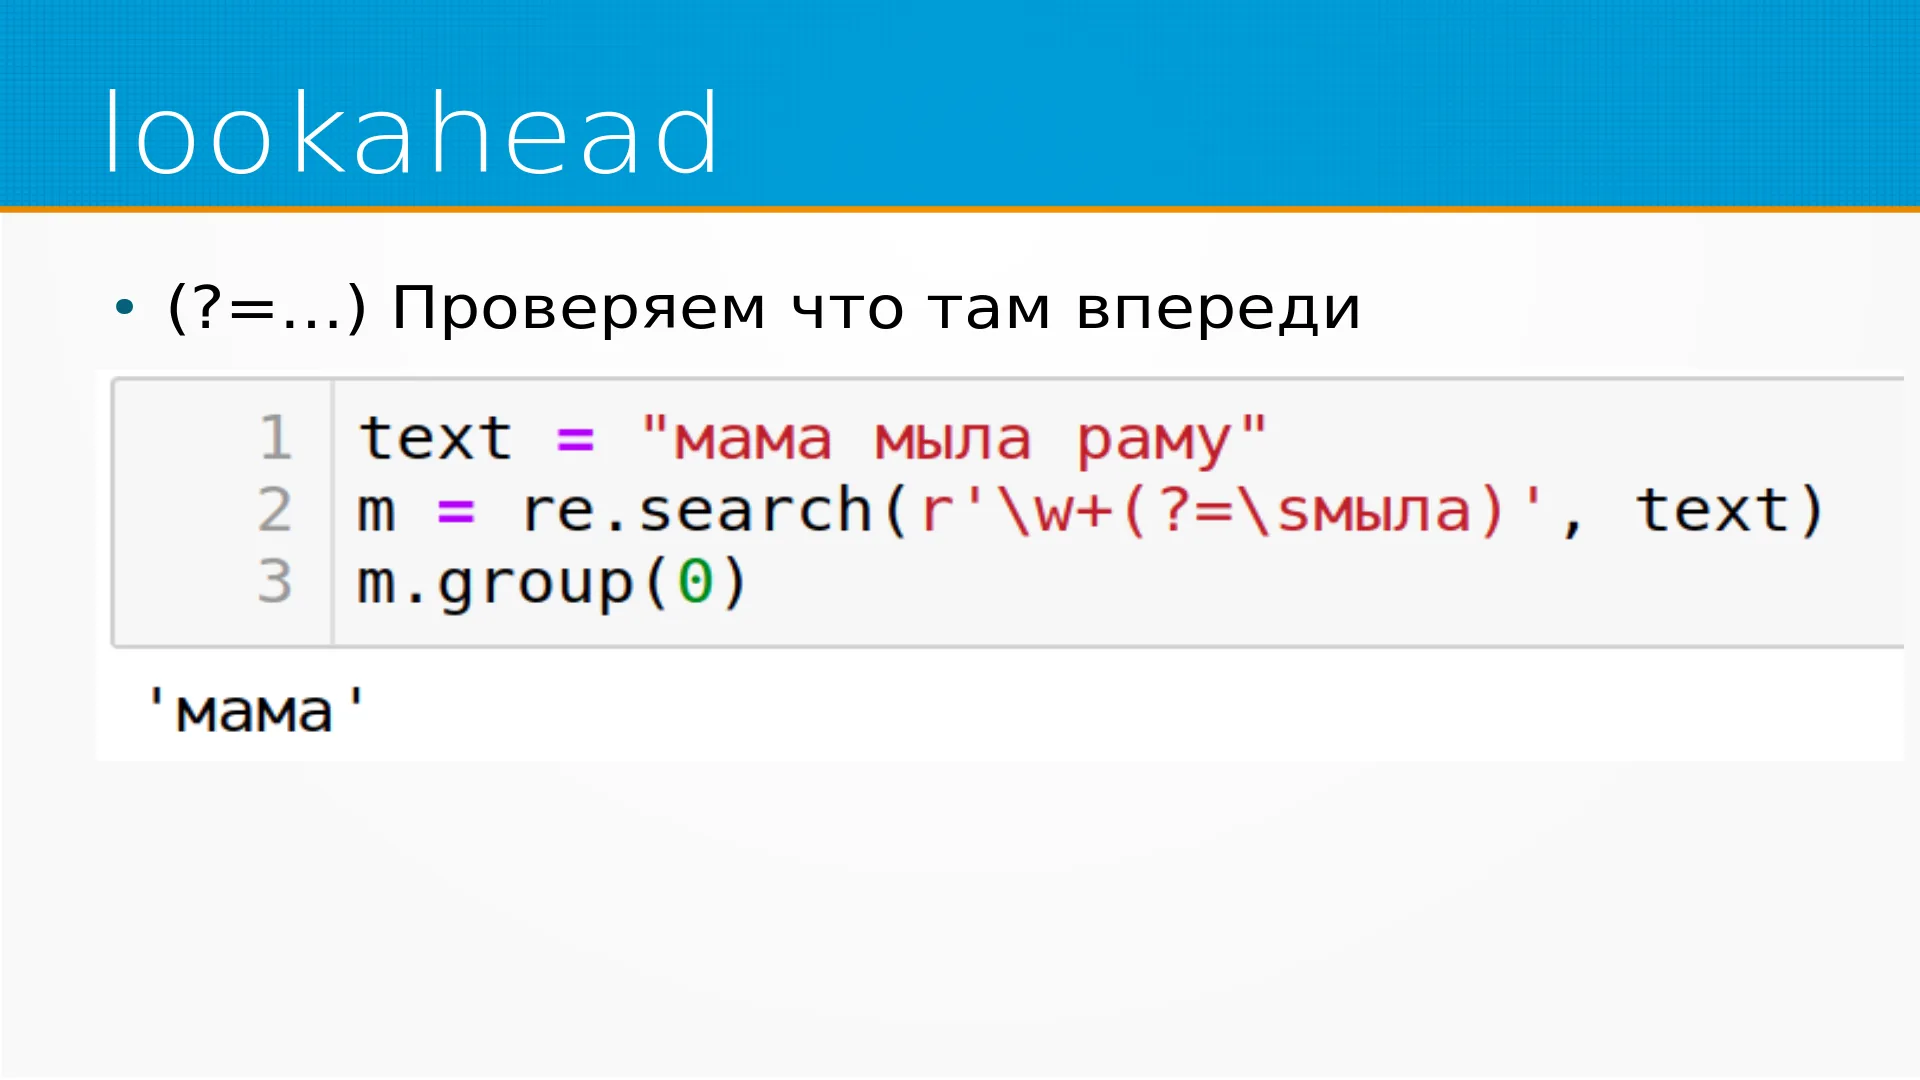
группа tag совпавшая. Мы можем писать регулярные выражения, которые будут совпадать с некоторым текстом, за которым идёт что-то. Условие, что мы совпадаем с текстом при условии, что за этим текстом идёт некоторое другое текст. Но с тем текстом после неё мы не совпадаем. Это удобно в некоторых случаях. Вот, например, мама мыла раму. Мы говорим: мы совпадаем со словом мама при условии, что после него идёт слово мыло. Но с самим мама мы не совпадаем.
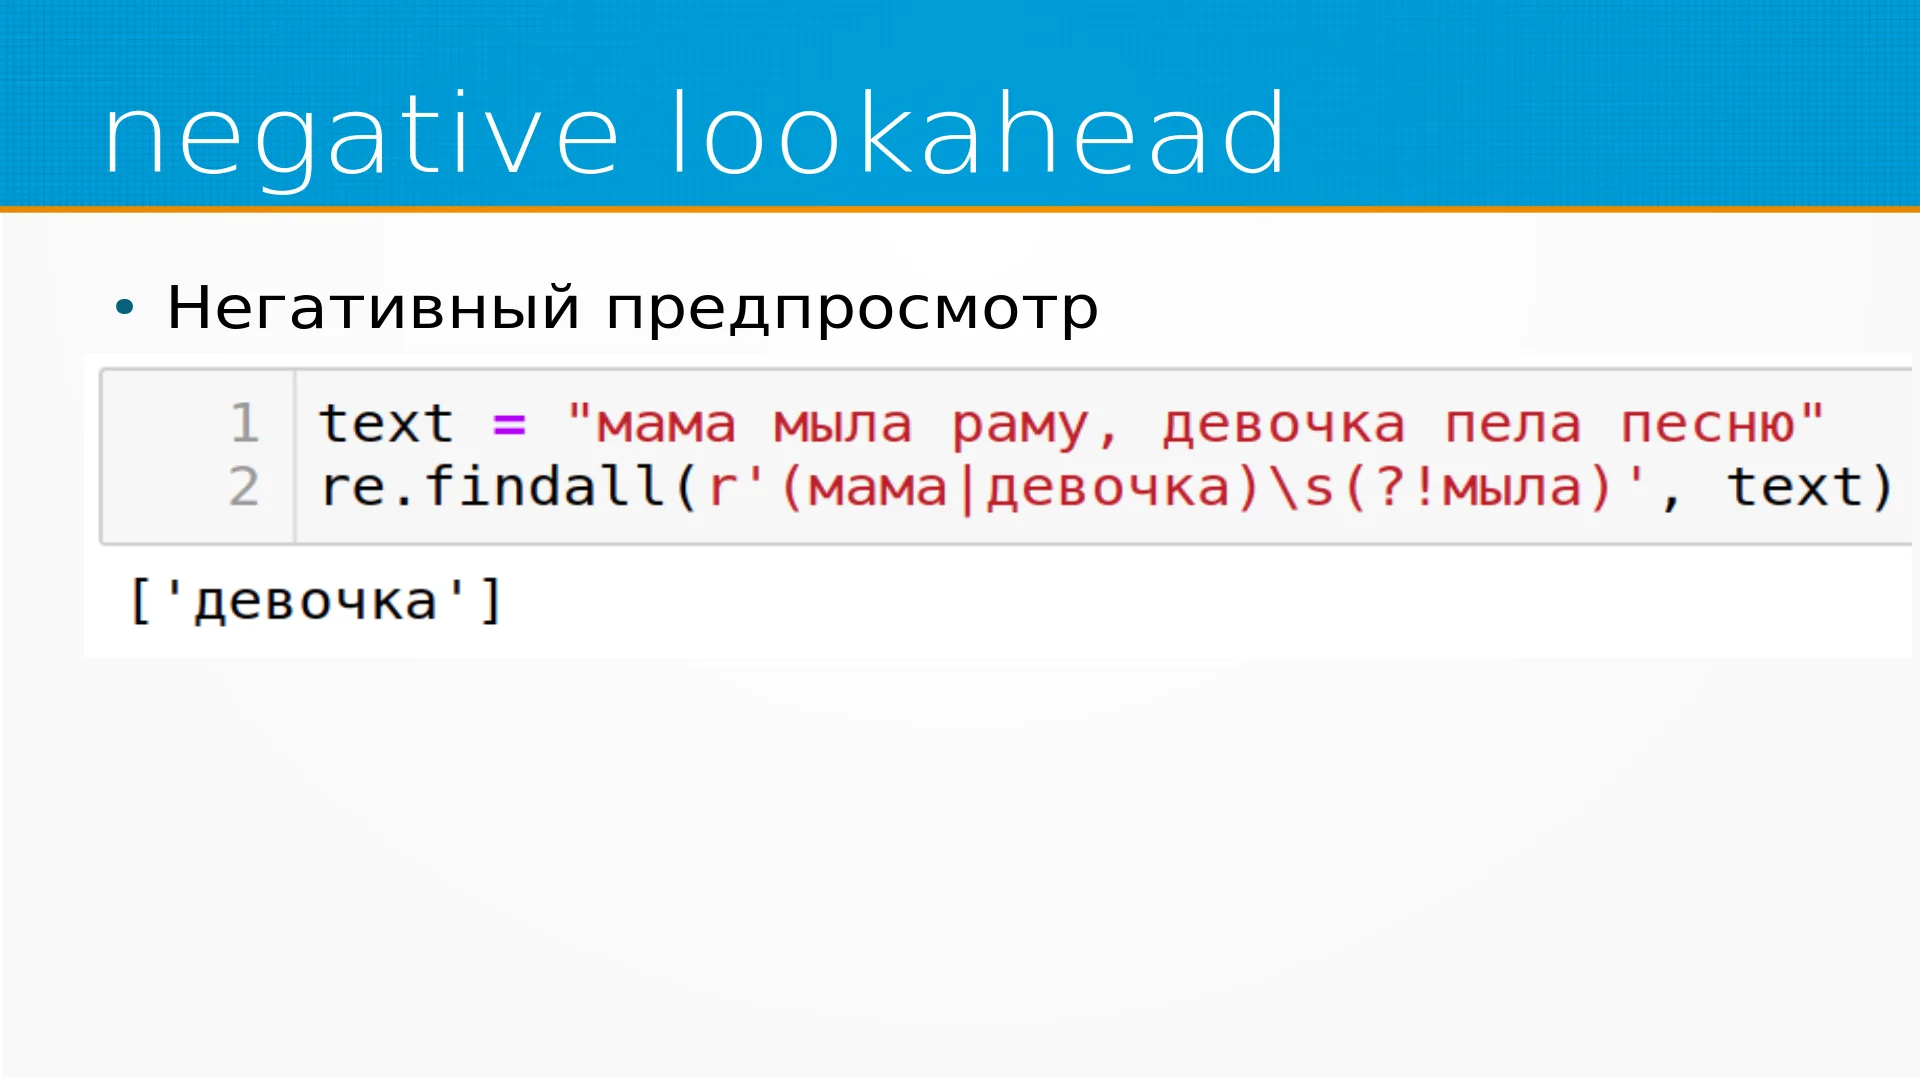
Lookahead может быть также негативный. Мы совпадаем со всеми словами, за которыми не идёт что-то. Допустим, вот мама мыла раму, девочка мыла песню, мама или девочка, что-нибудь, что не мыло.
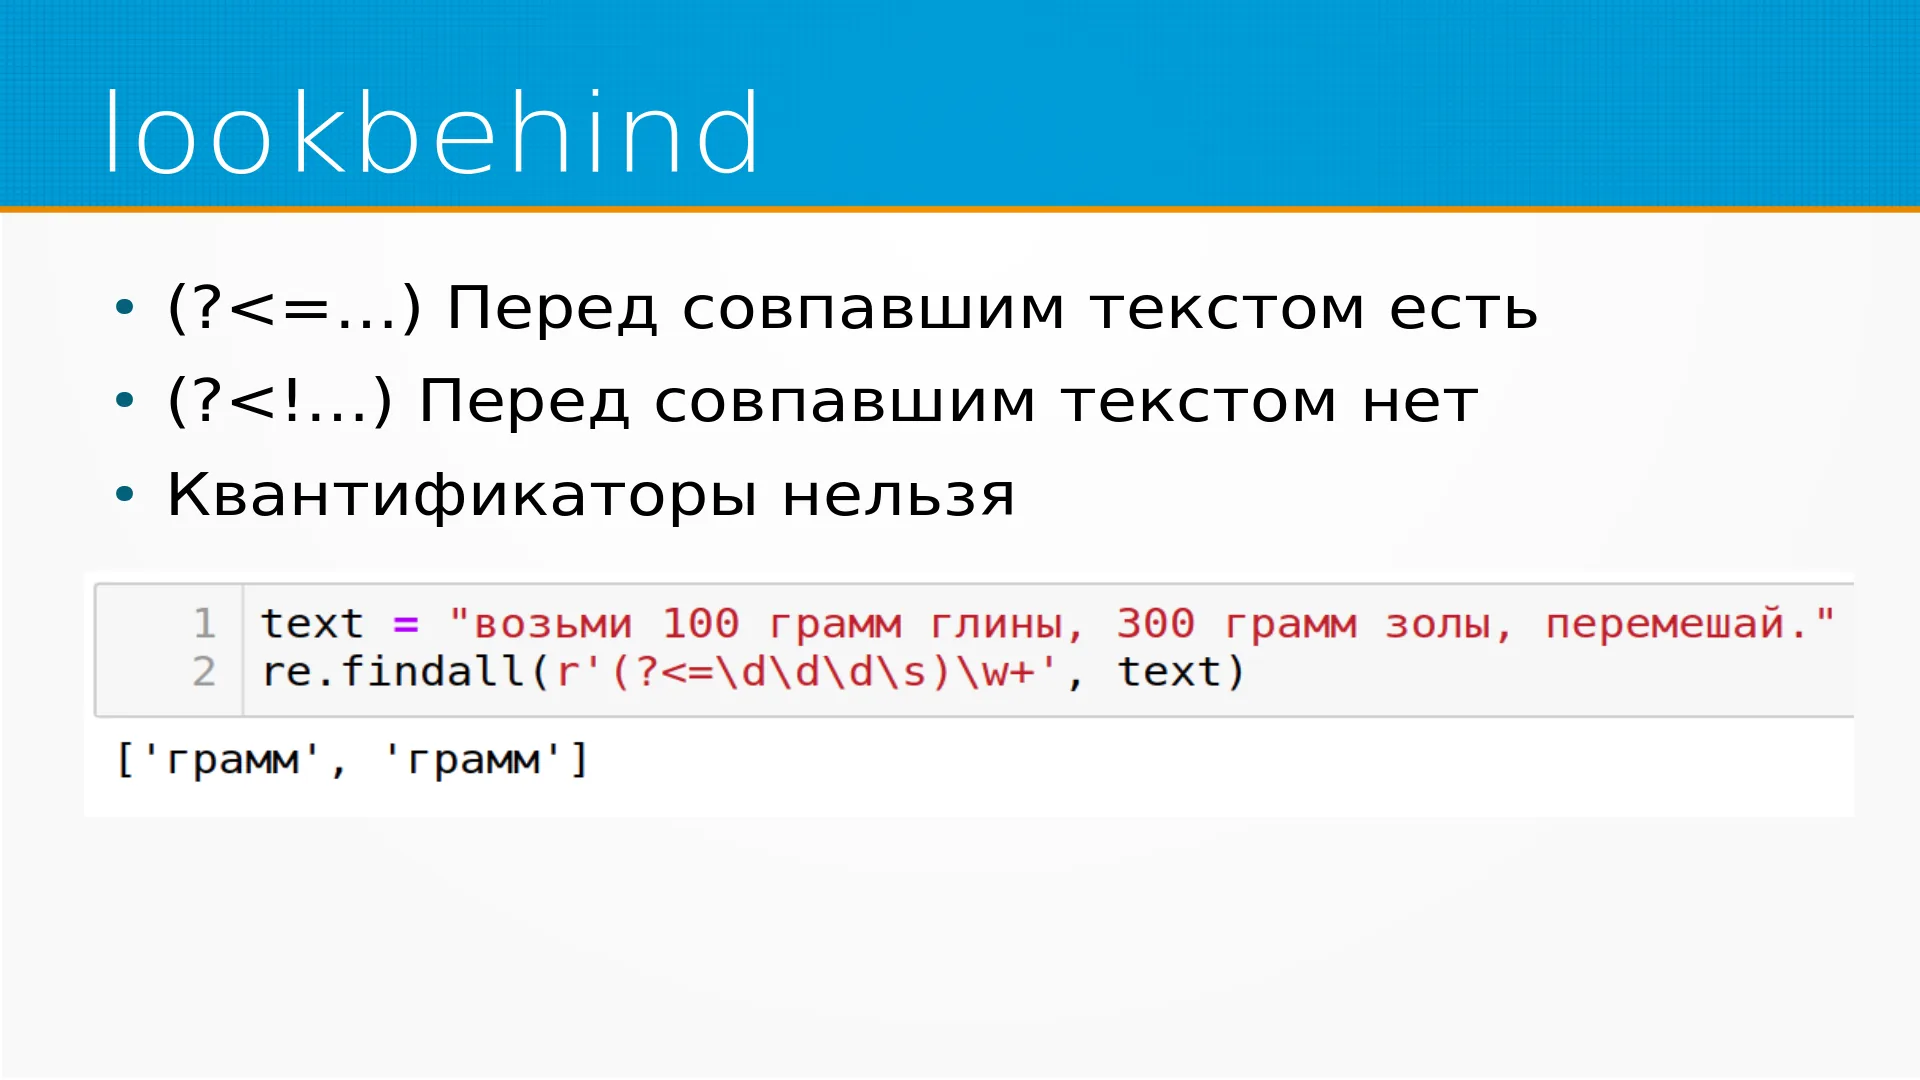
Есть lookbehind, то есть тоже точно так же, как предпросмотр, мы смотрим перед регулярным выражением, проверяем, что совпало. Можем смотреть, чтобы совпало за до регулярного выражения. Какая тут есть проблема? Вот если мы посмотрим, как я тут сделал совпадение с числом, несколько классов цифры. Хорошо было бы здесь поставить косая D плюс, например, то есть несколько цифр подряд идущих. Но lookbehind так не работает, потому что это слишком сложно для конечного автомата, и он нам запрещает это делать.
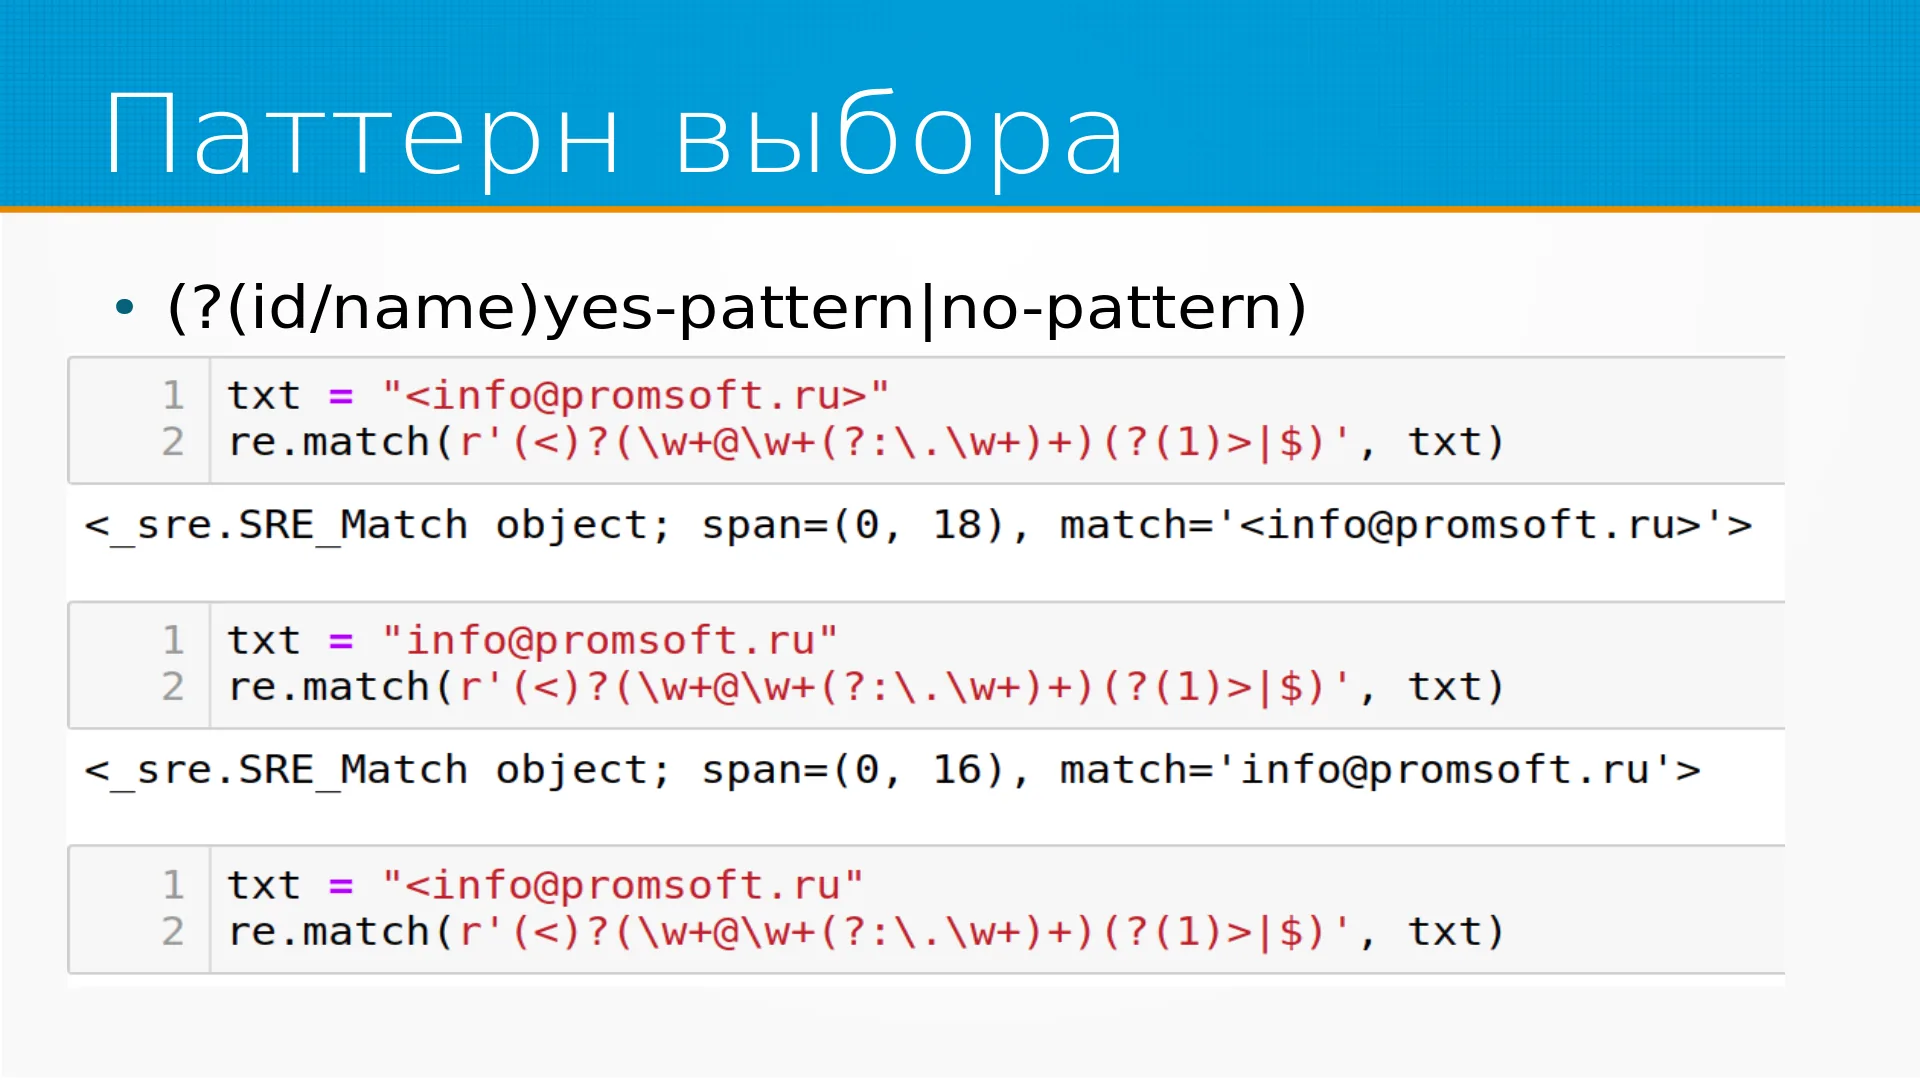
Достаточно сложная вещь, последняя, на самом-то деле, сложная вещь в регулярных выражениях, которую сегодня хотел обсудить, это паттерн выбора. Паттерн выбора - это сложная конструкция, при условии, что у нас ранее в регулярном выражении совпала Именованная или нумерованная группа, мы ищем одно регулярное выражение. Если она не совпала, мы ищем другое. Вот тут есть пример регулярного выражения, которое совпадает с емейлом в угловых скобках или с емейлом без угловых скобок, но не совпадёт с емейлом, у которого одна угловая скобка. Сначала мы пытаемся совпасть первой группой, которая содержит угловую скобку. И если она совпала, эта первая группа, то мы ищем, а, в конце закрывающую угловую скобку. Если она не совпала, мы в конце ищем конец строки.
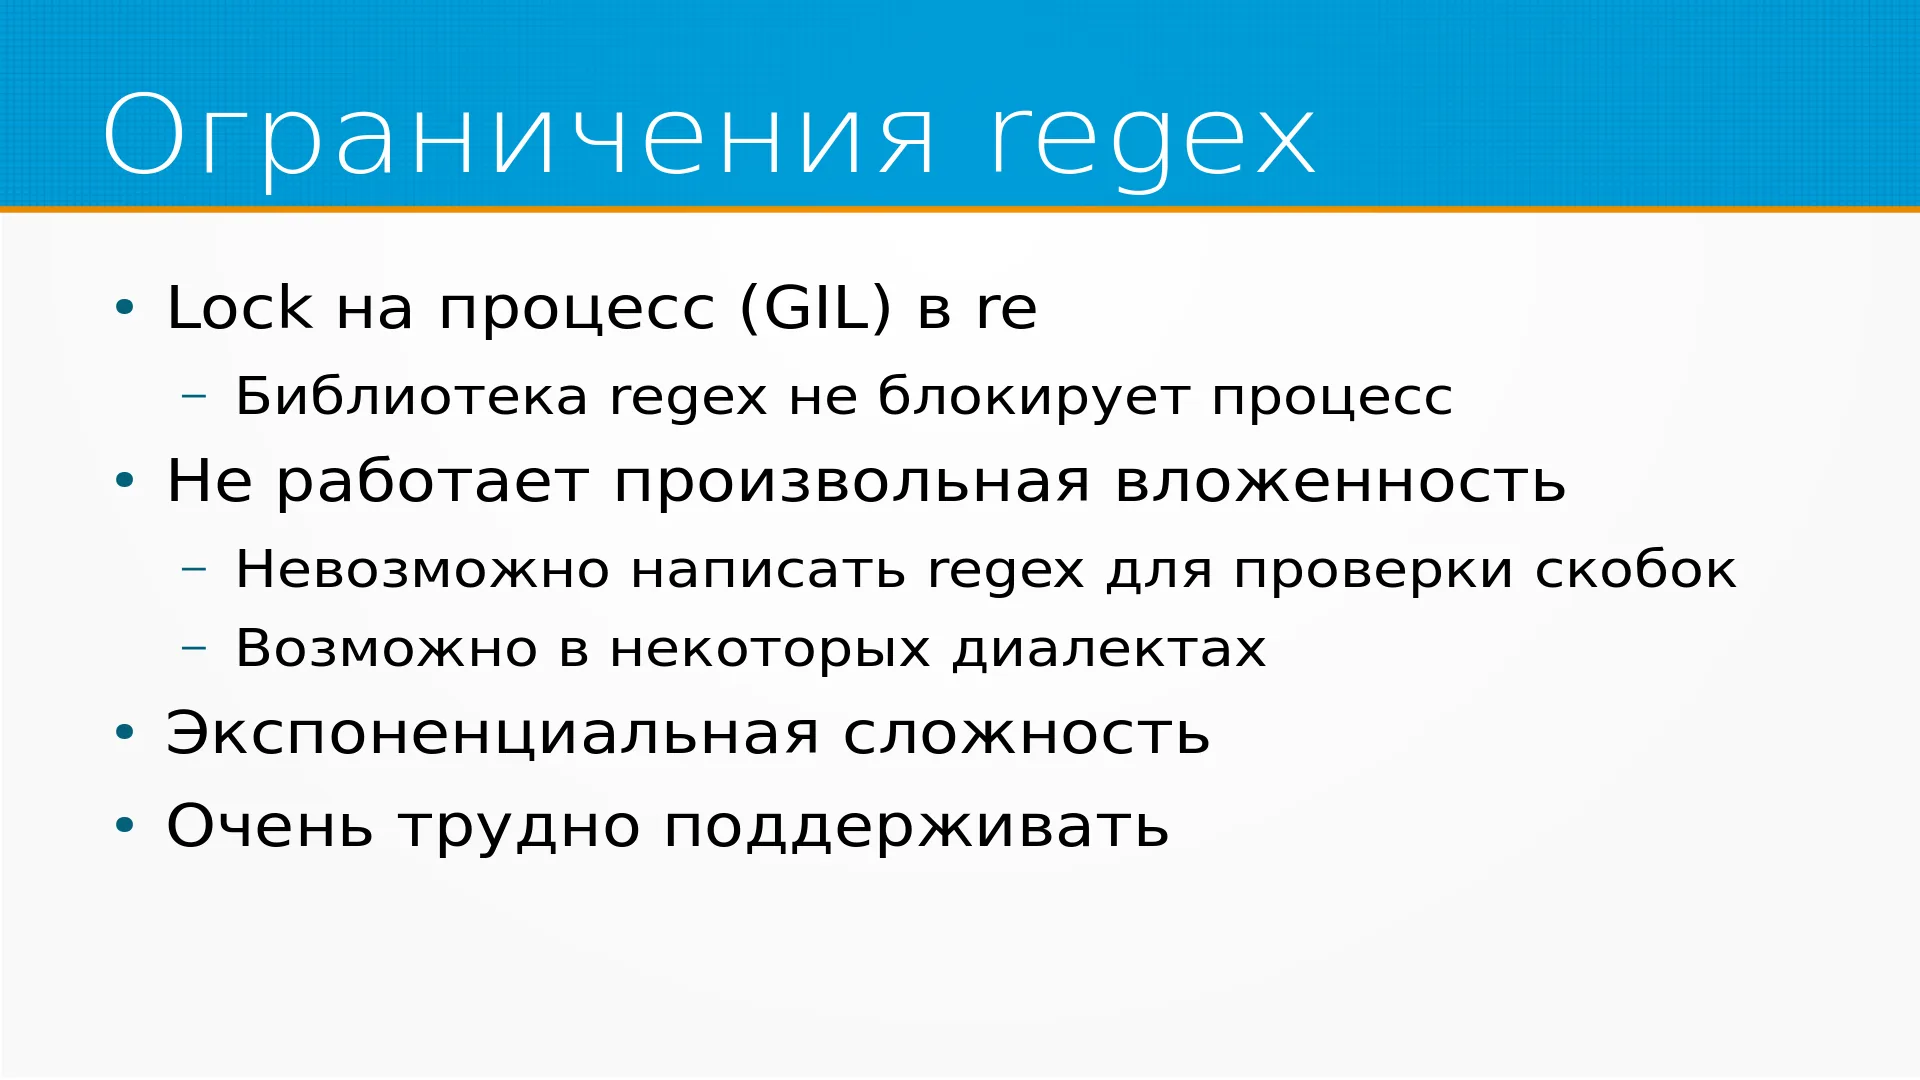
Читать их трудно, писать трудно регулярные выражения такие. У регулярных выражений есть ряд важных ограничений. Во-первых, стандартная библиотека re Ставит лок на весь процесс. Вы такие запускаете регулярное выражение в треде, она блокирует весь процесс у вас. Затем тред вы не убьёте. Если в нём выполняется регулярное выражение, у вас GIL заблокирован, пока регулярное выражение работает. Если вы наткнулись на тайм-бомбу, то вам кранты. Действительно, средствами Python вы ничего с этим не сделаете. Есть библиотека regex, частично разработанная как раз, чтобы решить эту проблему. Там она не блокирует процесс. Потом в библиотеках в библиотеке re не работает произвольная вложенность. Например, написать регулярное выражение, которое проверяло бы баланс скобок, что у нас открывающих скобок столько же, сколько закрывающих, на регулярных выражениях написать невозможно.
В общем случае, то есть можно написать для двух скобок, для трёх скобок, для четырёх скобок, но в общем случае написать нельзя. И это просто, ну вот такое ограничение конечных автоматов. В некоторых диалектах регулярных выражениях это сделать можно. Но в re нельзя. Ещё в регулярках вы очень легко натыкаетесь на экспоненциальную сложность это я показывал. И очень трудно поддерживать, об этом легко догадаться, глядя вот в эту вот регулярку. Предположим, что вы её написали, а потом кто-нибудь приходит, особенно если он несколько моложе и менее опытный, чем вы, думает: что тут написано? Что они курили эти ребята? Вот. И причём, на самом деле, как только в проекте заводится одно регулярное выражение, очень скоро у вас их там тысячи, поэтому вы спускаете этого демона внутрь.
И он начинает там воротить всё, что угодно. У нас, говорит, была одна проблема обработки текстов, мы решили решить её регулярными выражениями, теперь у нас две проблемы: обработка текстов и регулярные выражения.
Дмитрий: Из полезного: документация по re у Питона очень хорошо написана. Библиотека Regex, которая в теории совместима с библиотекой re стандартной питоновской, а она документирована очень скудно, ну зато она крутая. Есть хороший видеоучебник, в котором рассказано всё, что я не рассказал про регулярные выражения. Есть прекрасная книга Фридла, фактически Библия регулярных выражений. Регулярные выражения ведь есть не только в Питоне, не столько, они в Питоне Perl-совместимые регулярные выражения. Настоящие пацанские регулярные выражения, они в Перле, и там есть вещи, которых в Питоне вы не мечтали, к счастью. Ещё регулярные выражения работают в базах данных, например, в MongoDB, с которой мы много работаем, в MySQL.
Хороший учебник по регуляркам в JavaScript, вот тут тоже по ссылке есть. Наверное, и всё. Есть ли какие-нибудь вопросы? Кто-нибудь не уснул?
Из зала: Вот про скорость хочется узнать, как быстрее.
Дмитрий: Самый быстрый способ работать с регулярными выражениями - это не использовать регулярные выражения.
Из зала: Что тогда вместо них?
Дмитрий: Если вам нужно проверить, что текст начинается с какой-то строки буквально,
Из зала: Startswith.
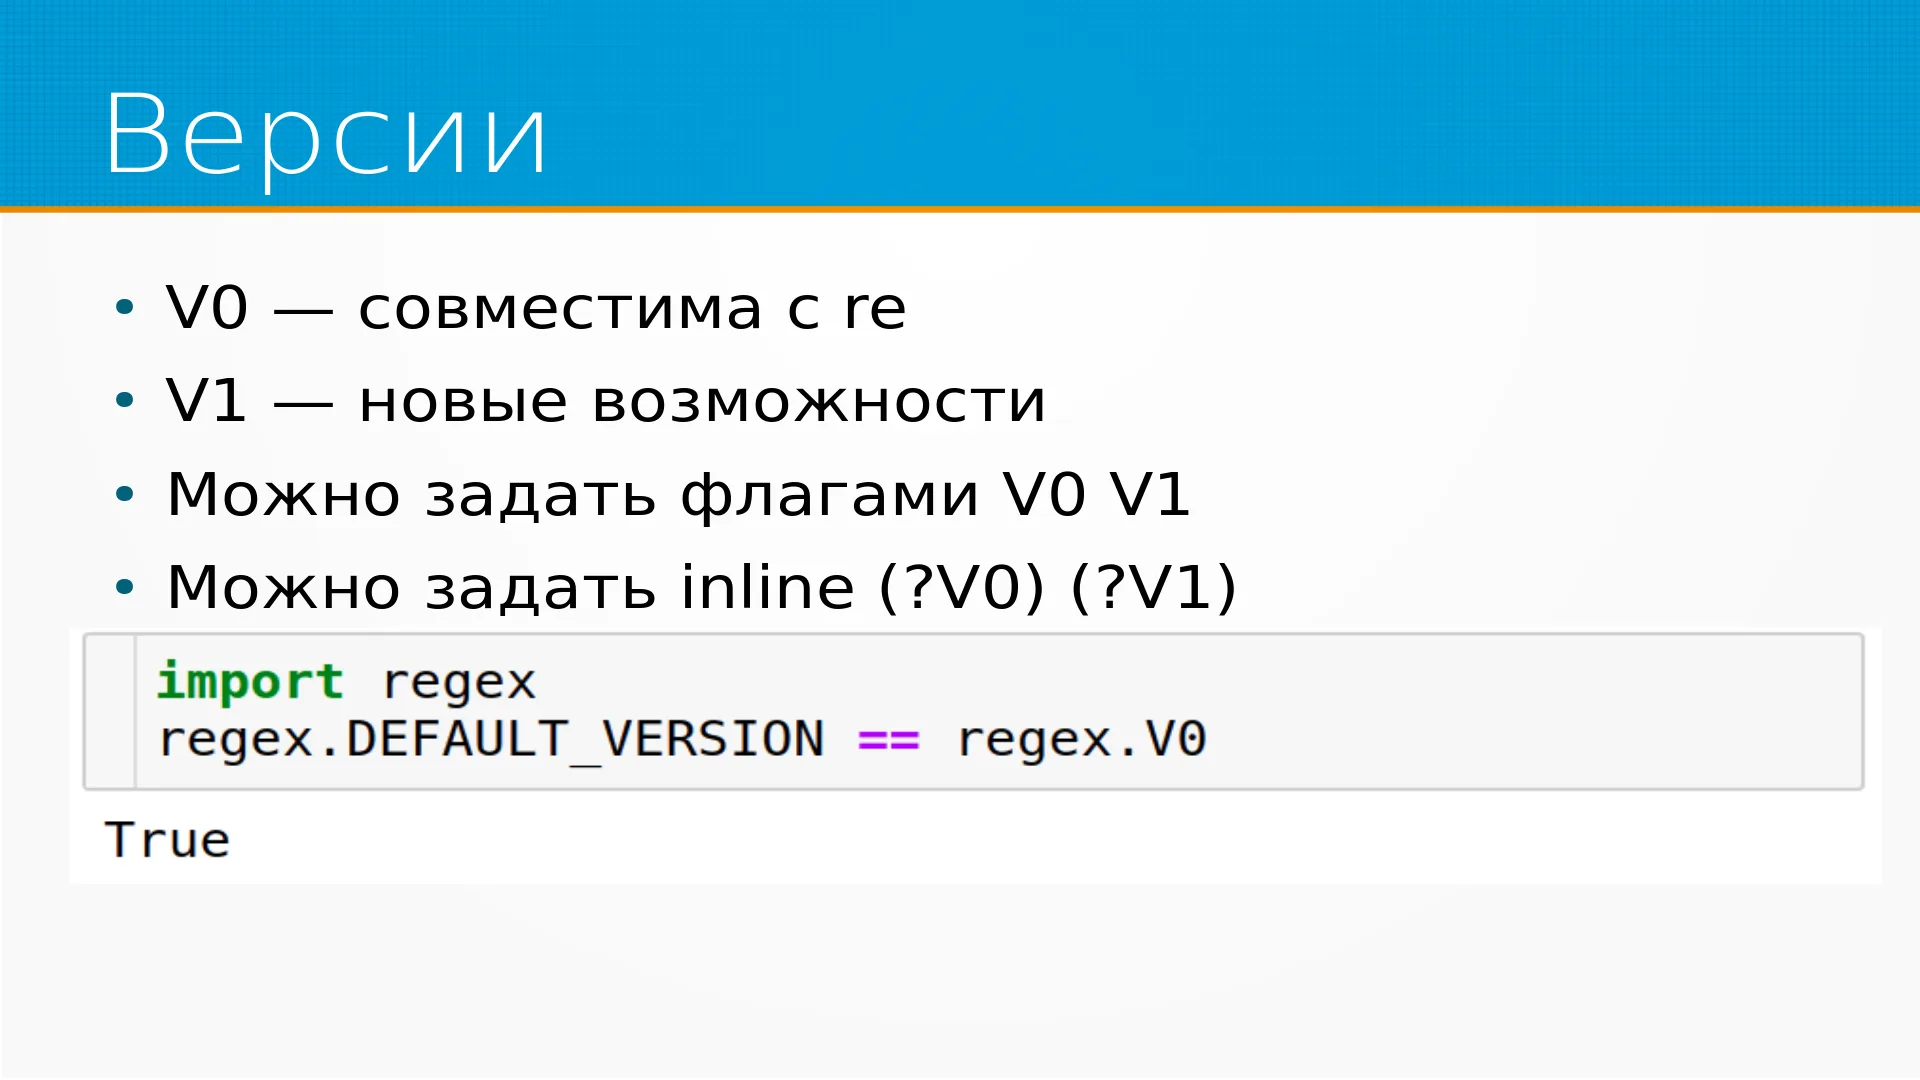
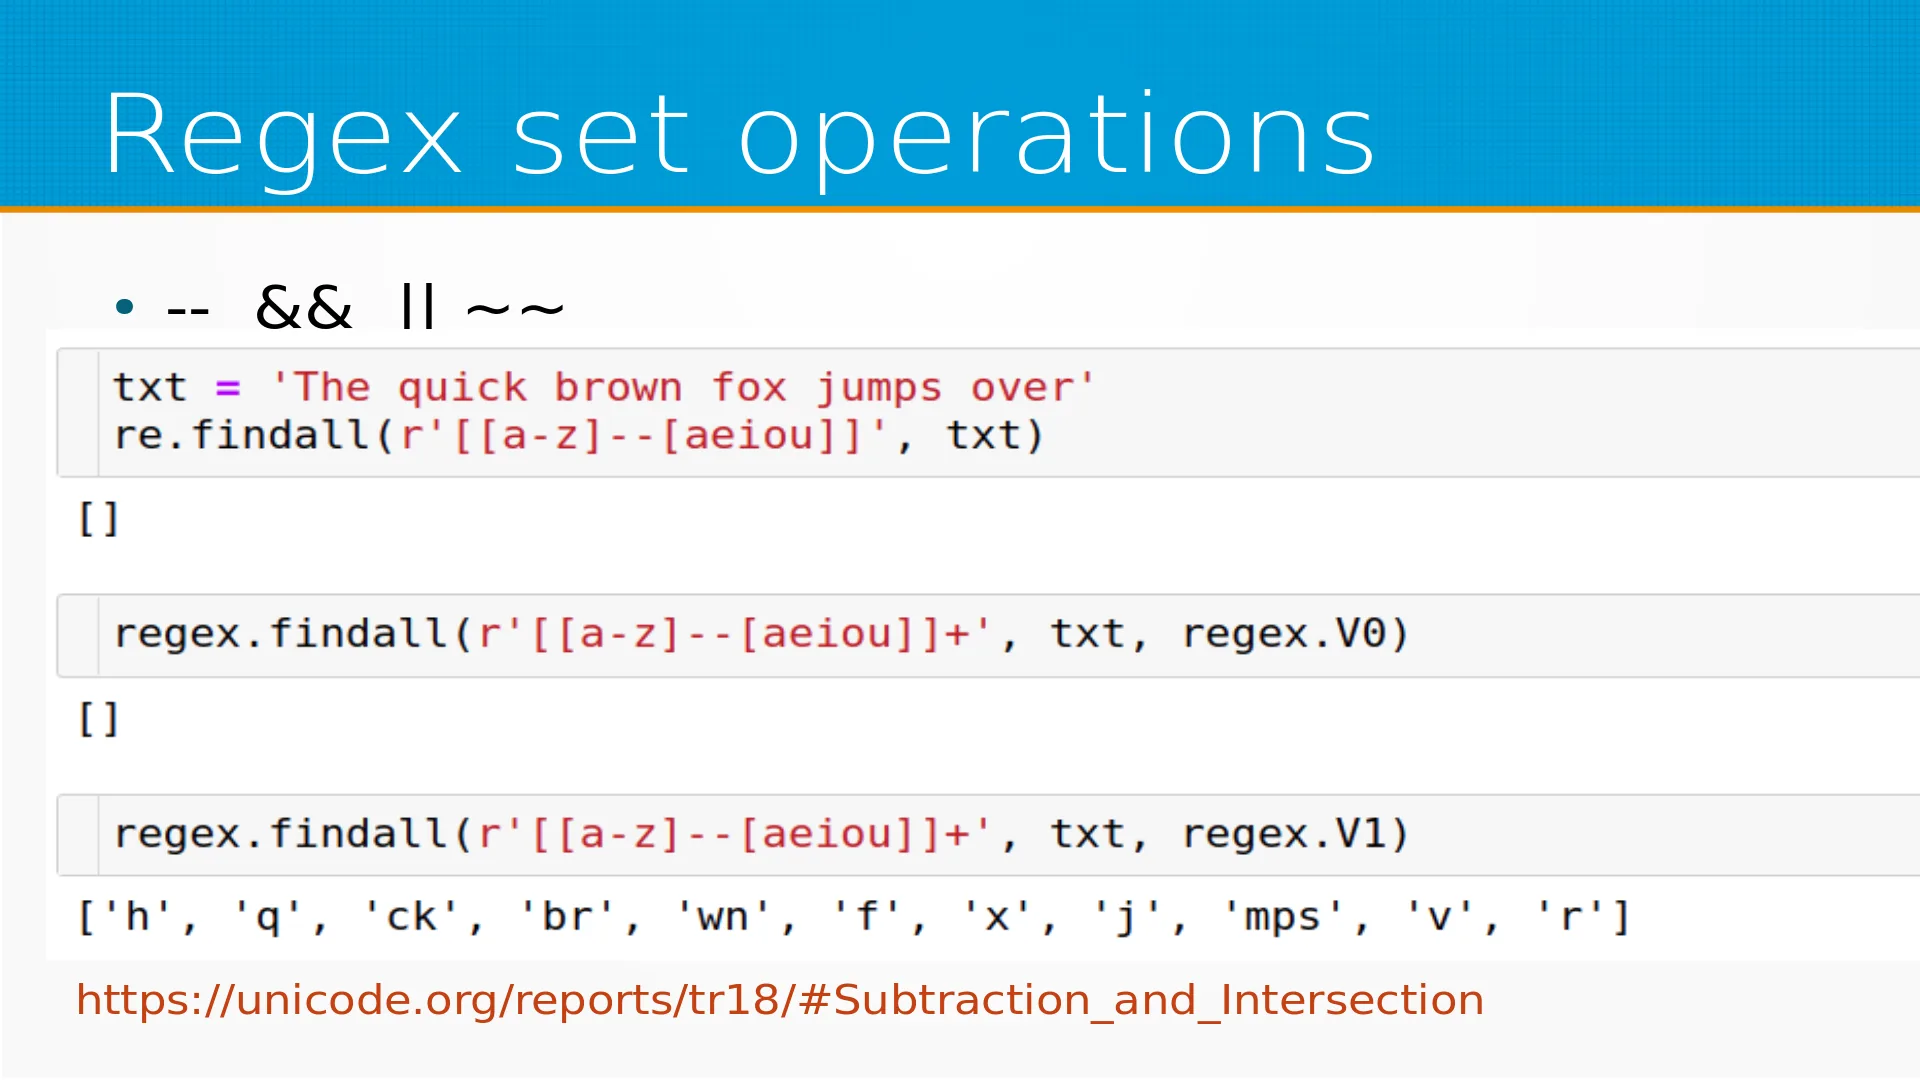
Дмитрий: Используйте startswith. Если вам, а, нужно заменить какой-нибудь текст без если вам не нужен сложный конечный автомат, используйте, а, str.replace. Если вам, а, нужна простая замена по шаблону, используйте языки шаблонизации. Если вам нужно писать сложные регулярные выражения, в которых вы хотите использовать полный фарш и не хотите, чтобы они у вас блокировали GIL, используйте библиотеку Regex. Это почти без вариантов. Мы, кстати, Regex использовали. Там, например, есть такая, ну вот, Александр Николаевич использовал. Там есть такие вещи, например, как операции над множественными символов. У вас есть вы определили один символьный класс и определили другой символьный класс, как вычитание из этого символьного класса это, то есть мы классы символьные можем вычитать, складывать и так далее и тому подобное.
Там есть предопределённые символьные класс, классы, например, символьный класс все знаки пунктуации Юникода и так далее. Весь этот фарш, который вы в re городите руками, он там есть готовый. Из недостатков - это протекающая абстракция. Автор говорит: "Оно у меня полностью совместимо". На самом деле всё надо проверять, будет оно полностью совместимо или нет. Ещё это у нас недетерминированные конечные автоматы. Есть, а, библиотеки, в которых реализованы детерминированные конечные автоматы, а также есть ревнивые регулярные выражения. Ревнивые регулярные выражения - это когда оно совпадает вот как только оно могло начать совпасть, вот оно с этого места и совпадает. Это делает его катастрофически быстрым, потому что там нет вот этого отката, в принципе.
Но в Python re оно не поддерживается, оно делается через дополнительный плюсик, если память не изменяет, за квантификатором. Плюс-плюс - это или звёздочка-плюс - это у нас такие ревнивые плюс или ревнивая звёздочка. Он совпадает с того места, где только мог начать совпасть. И есть библиотеки, реализации, библиотеки регулярных выражений, которые, в принципе, не являются детерминированными конечными автоматами, то есть они не поддерживают откат. И они тоже фантастически быстрые.
Дмитрий: Наверное, так.
Из зала: В целом можно просто библиотеку re заменить на какую-то более современную?
Дмитрий: Да, не более современную, ну Regex, Regex более современная, можно сказать. Re она
Из зала: Там просто лок опять же.
Дмитрий: Да, на re просто так много всего завязано в мире Питона, ну то есть re - это для то же самое для Питона, наверное, что для Data Science NumPy. Вот, то есть
Из зала: Torch на re, да, написан?
Дмитрий: В Torch используется re, да, вот.
Из зала: Интересно.
Дмитрий: На самом-то деле
Из зала: Обратная совместимость.
Дмитрий: Да, во-первых, обратная совместимость, во-вторых, а мы же можем не иметь эту библиотеку Regex.
Дмитрий: Возможно, они не хотели от неё зависеть.
Из зала: Точно.
Дмитрий: Возможно, что, ну и опять же, регулярные выражения, если мы смотрим, какие там стоят, они такие там скупая мужская и женская слеза, то есть как бы. Их, правда, вот тут много, то есть гигантский массив, они вместо того, чтобы собрать их через end, через or, они их сложили в массив и честно в цикле проверяют.
Из зала: Быстрее так?
Дмитрий: Не факт, что так быстрее. Быстрее было бы через or. Я думаю, что всё-таки в PyTorch индусские корни учитывая, что и сам автор-то индус, поэтому как бы ему даже, наверное, это не обидно. Просто он местами плохо написан, местами прекрасно, местами плохо. И работает, и пусть работает. Регулярки очень быстрые, на самом-то деле. Когда я говорю, что они могут зависать, это вот пока вы стомегабайтные файлы текстовые ими не разбираете, скорее и пока вы не пишете вот такие вот бомбы,
Дмитрий: тайм-бомбы, да, у вас всё будет хорошо.
Из зала: Этот, а Yargy Parser, есть такая штука, она, к примеру, используется для парсинга адресов. И вот давно-давно. Она на re написана?
Дмитрий: Нет. Дело в том, что у неё своя реализация автомата, она не на re написана.
Из зала: Угу. Она быстрее, не знаете?
Дмитрий: Она достаточно быстрая, она, в принципе Yargy Parser, он немножко по-другому работает сам по себе. Наташа на них сделана, Наташа быстрая.
Из зала: Да, да, да. Это вот.
Дмитрий: Она удобно работает тем, что вы там вот эти газетиры делаете, то есть предопределённые списки слов, словные классы. Чего тут просто не сделать, то есть. И заклинить его сложнее Yargy Parser. Он просто немножко другой.
Из зала: Это вот для тех, кто не знает, это хороший способ извлекать адреса бесплатно, без Data.
Дмитрий: На самом-то деле, для разбора текста, именно, если вам нужно разбирать не какой попало текст, какие-нибудь логи, а человеческий язык, а, Наташа, построенная вокруг Yargy Parser, это, наверное, самое первое, что надо смотреть. Если вам нужно разбирать текст, в котором упоминаются люди, фамилии, имена, килограммы в общем, адреса, берите Наташу, не мучайтесь. Вот, наверное, так. Есть ещё какие-то вопросы?
Дмитрий: Все так всё знают про регулярные выражения, да?
Из зала: Нет, на самом деле у вас прикольно про символ. Тайм-бомбы.
Дмитрий: Ага. Я скину презентацию в чат. И, наверное, тогда, если вопросов больше нет, тогда, наверное, и всё.
Из зала: Спасибо.
Дмитрий: Оп. Запись я тоже выгружу.