- 19.03.2024
- 30.10.2026
- выступления
- #NLP
На канале DS Talks разбирали статью GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection.
Слайды: galore.pdf
Текстовая расшифровка доклада (автоматическая, еще не вычитана):
Ведущий: Ага, тогда можно начинать.
Дмитрий: Ага, клёво, всем привет. Меня зовут, как и раньше, Дмитрий Колодезев, и мы сегодня разберём статью GaLore про Memory-Efficient LLM Training. Собственно, главная картинка этой статьи, на ней нарисовано потребление памяти при использовании разных техник оптимизации.
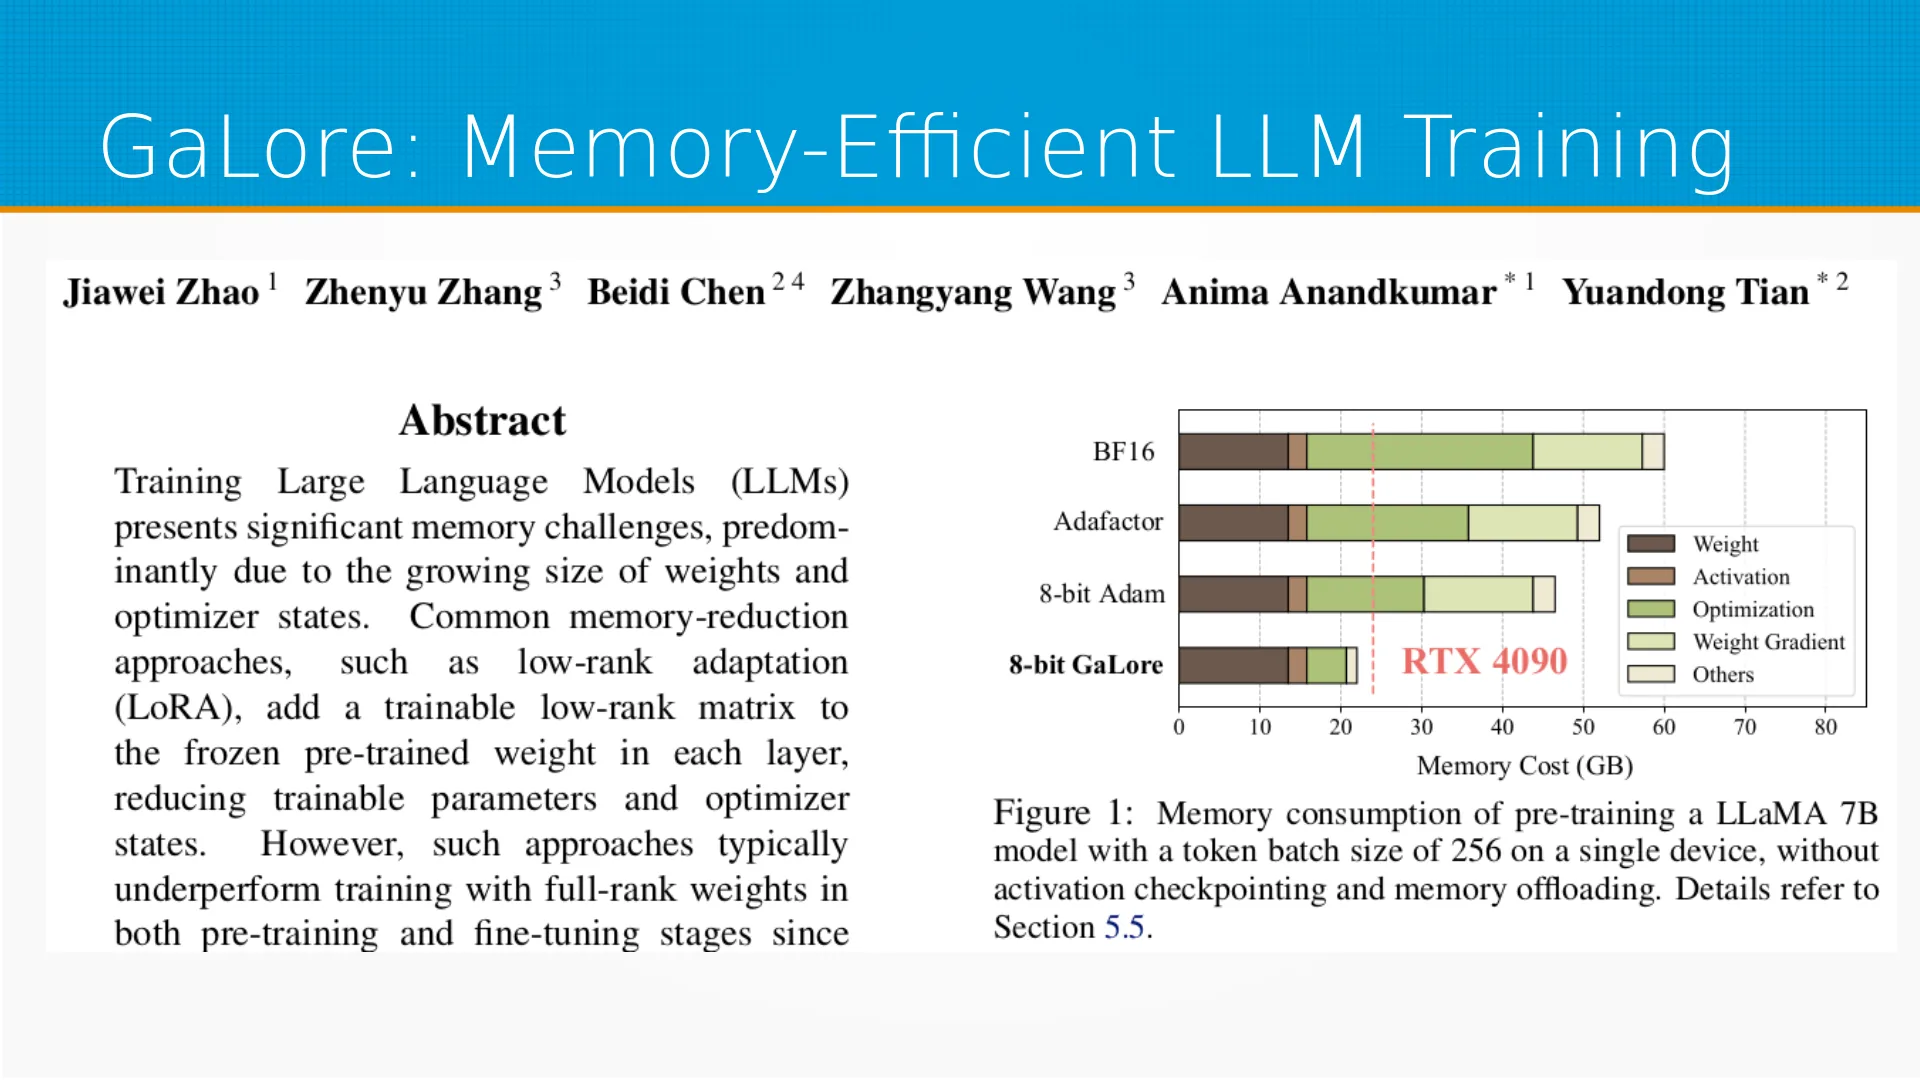
И получается, что 7B LLaMA мы можем запихать в нашу бытовую видеокарту, и у нас ещё немножечко останется памяти. Это прикольно. Кто авторы этого чудесного произведения?
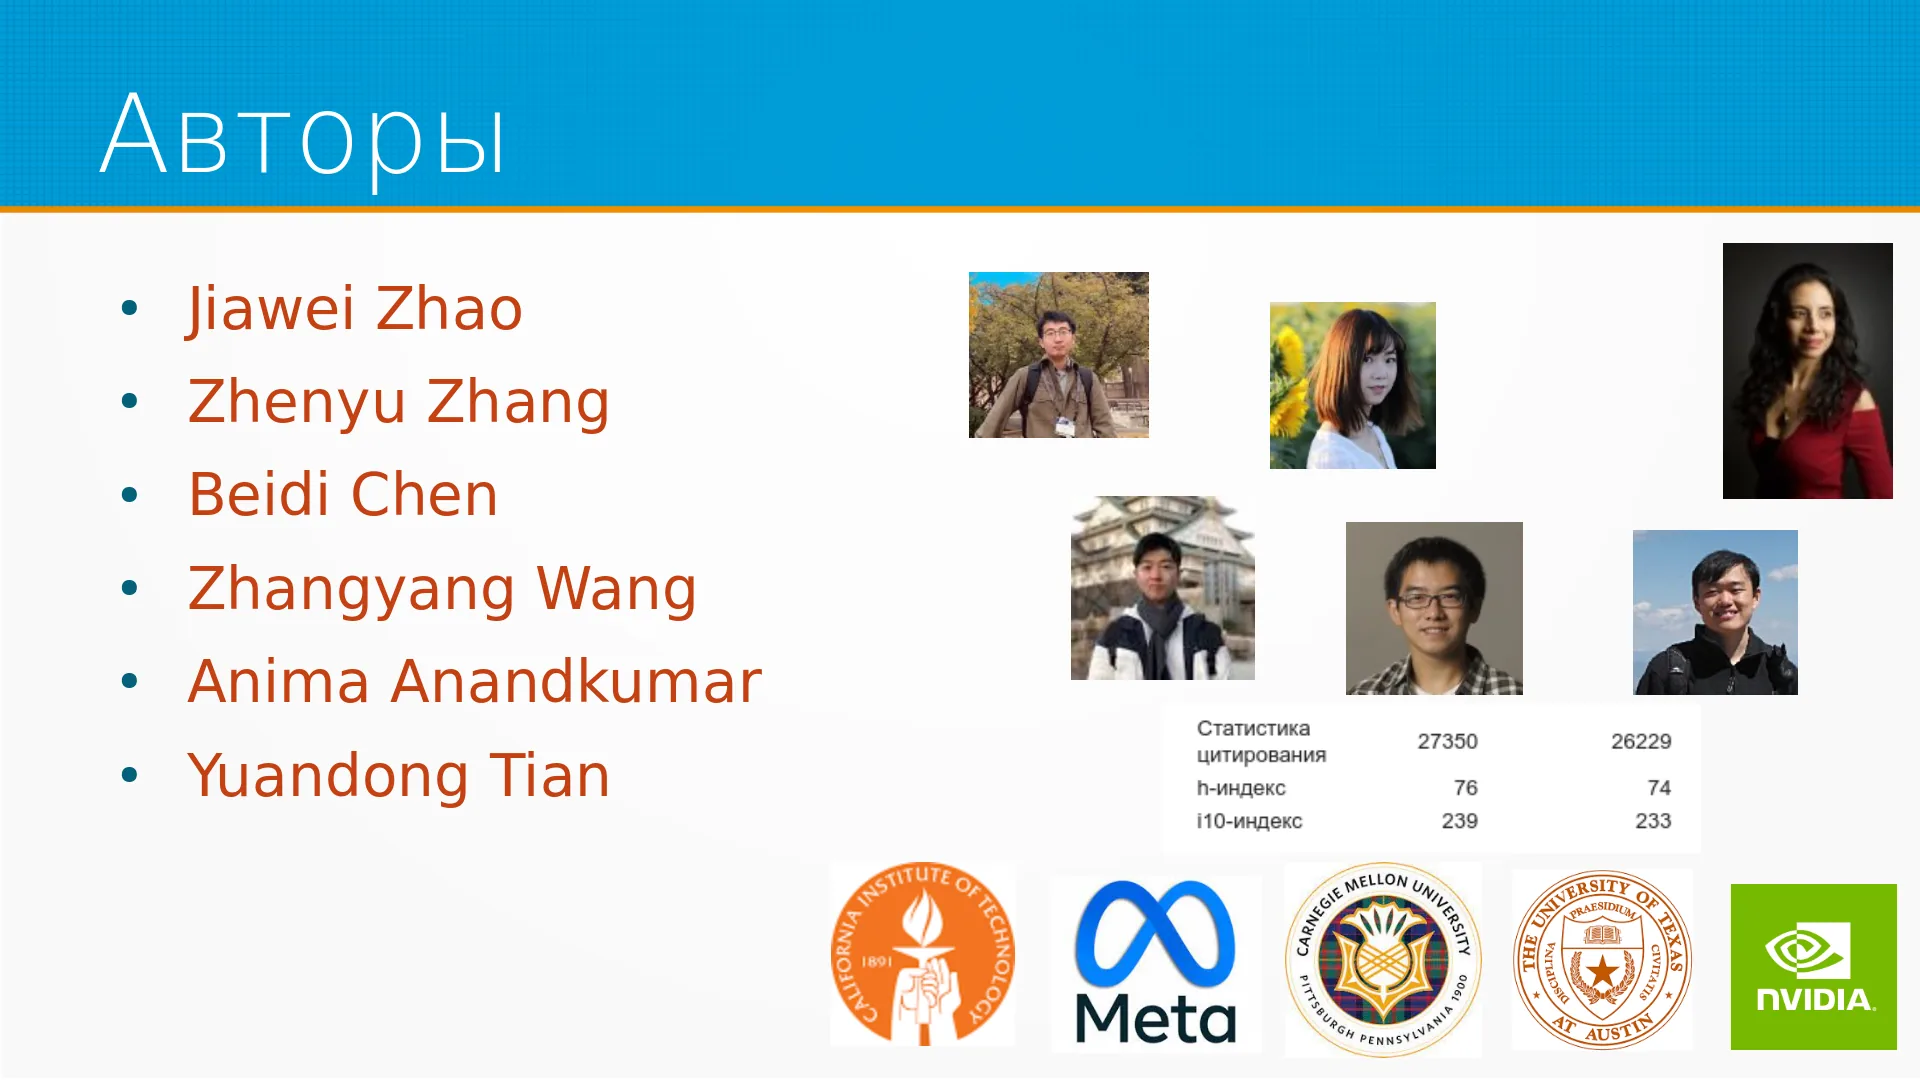
Пять китайцев и женщина из Индии, причём китайцы тут не простые, как на подбор. Вот тут самый породистый китаец внизу, у него индекс 76 и 27.000 цитирований. Но он тут не один такой. У этой девушки в красном, например, у неё в этом году вышло 25 статей, и у одной из них уже 67 цитирований. Поэтому, если вы не можете закончить свою статью, вот учитесь. Ребята работают в Калтехе, работают в Мете, работают в Карнеги Меллон, работают в университете Остин. И ещё вот эта девушка в красном, она связана с с Nvidia, хотя об этом в статье не написано. В общем клеймо негде ставить, породистые очень ребята.
Я почитал, кстати, статьи, а у них на Google Scholar и сразу некоторое количество себе вытащил интересных, потому что это статьи не для галочки, прямо интересно написаны некоторые. Вот по поводу самой статьи. 6 марта они её выложили на Архиве, 7 марта они выложили репозиторий с кодом и библиотеку pip, которую можно поставить и использовать просто
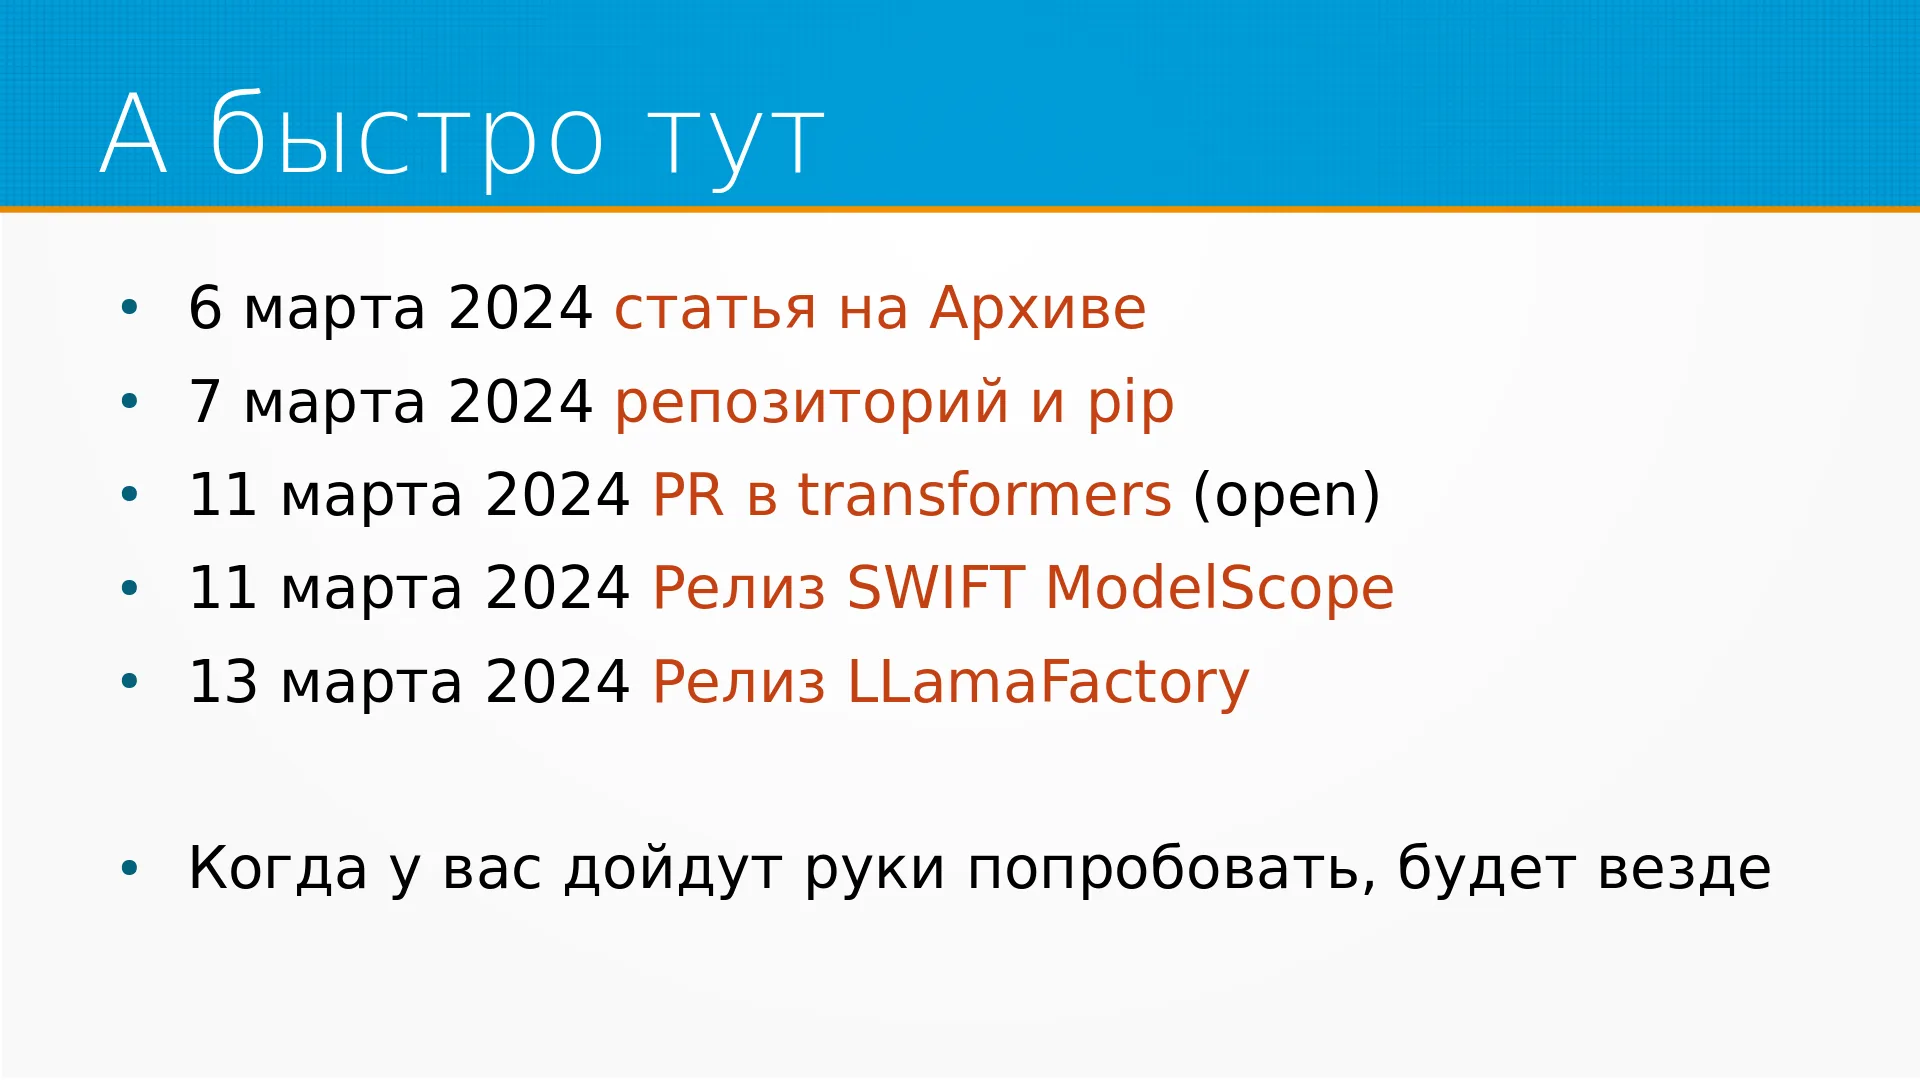
в своём коде. Он ещё не закрыт. 11 же марта библиотека ModelScope её зарелизила с поддержкой этой техники, и 13 марта LLaMA Factory зарелизила. Как только эту статью увидели, все сразу в неё вцепились и давай её реализовывать. И, в общем, когда у вас дойдут руки её попробовать, она уже будет реализована везде.
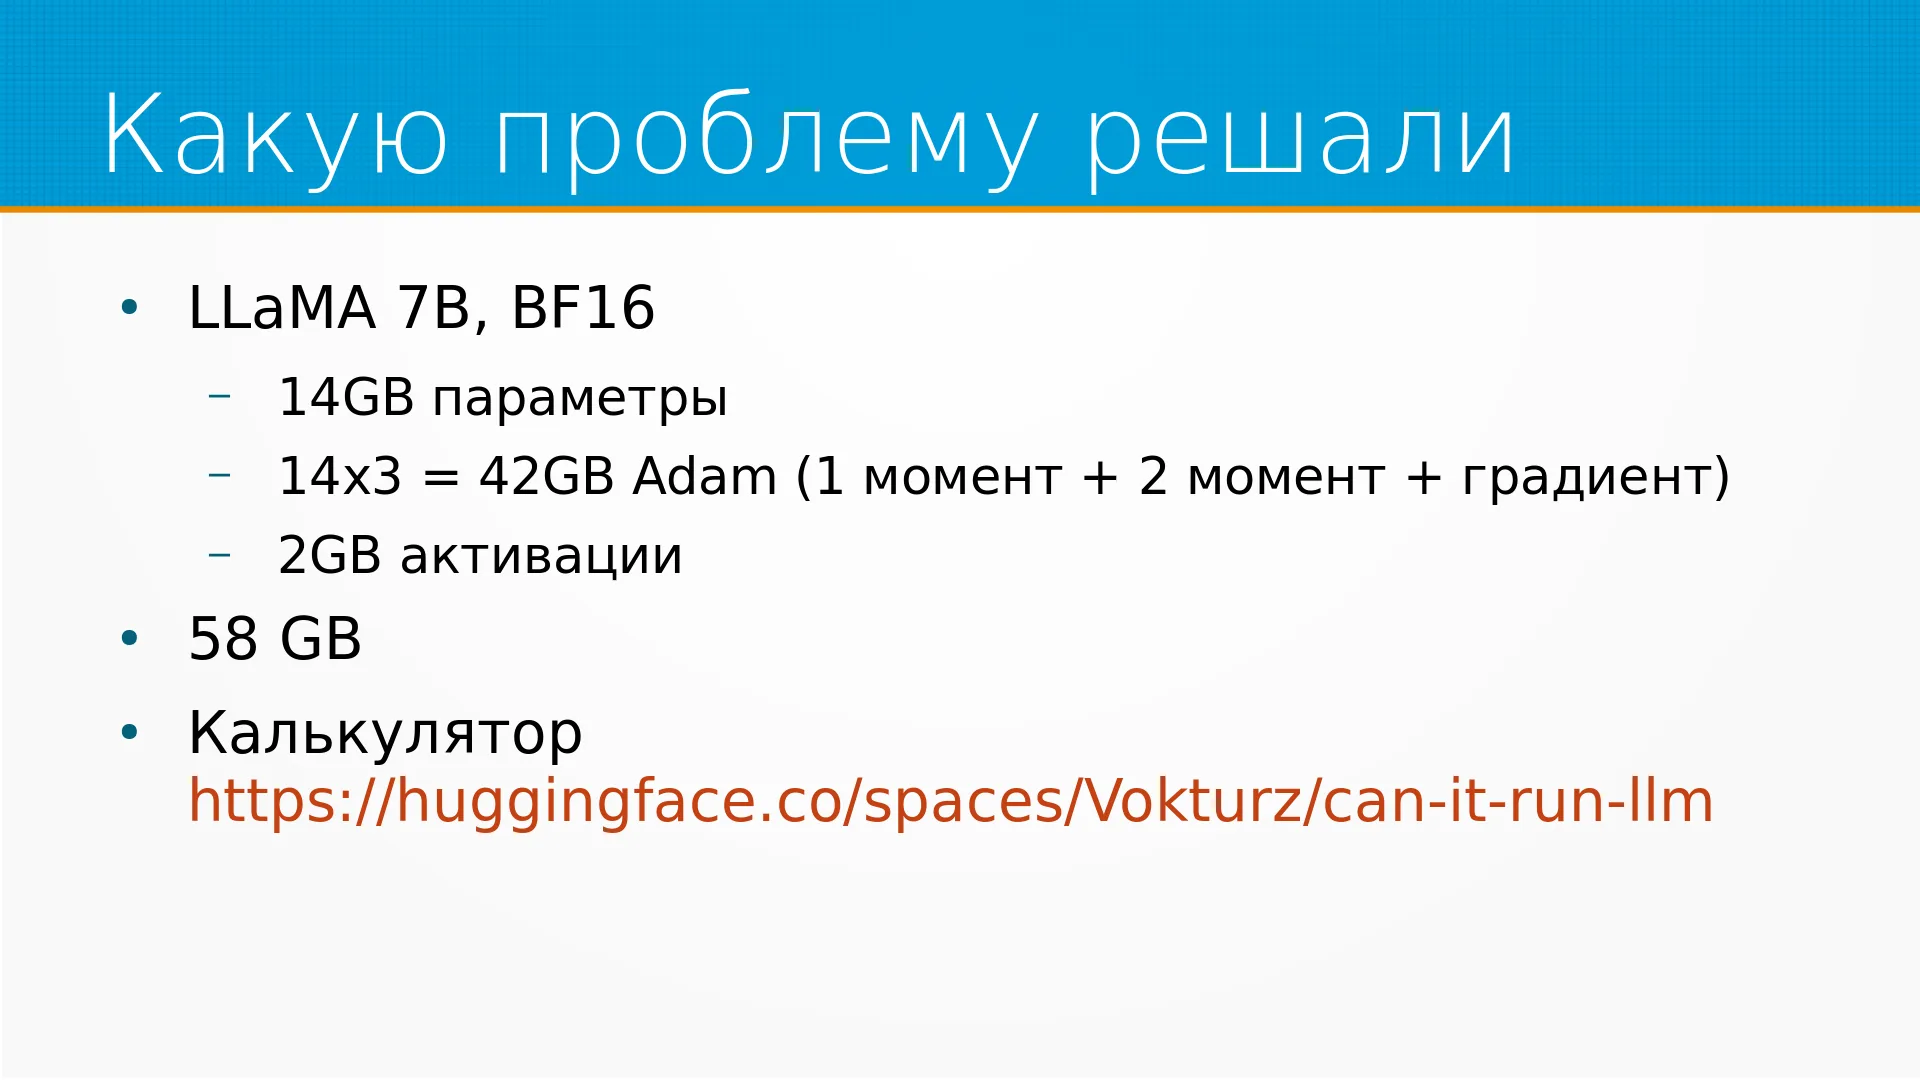
Какую проблему они решали? Есть такая штука, что когда берёшь учить модель, доучивать, не понимаешь, почему же она в память не влазит. В память она не влазит не из-за весов модели обычно, а из-за весов оптимизатора Adam. Например, если мы берём LLaMA 7B и в половинной точности её пытаемся учить, то у нас 14 ГБ занимают параметры. И ещё 42 ГБ у нас занимает Adam. Неожиданно так. И 2 ГБ активации, итого 58 ГБ. И почему Adam занимает так много места? Потому что он хранит первый момент для каждого веса, второй момент для каждого веса и градиент ему ещё нужен. И есть на Hugging Face прикольный калькулятор который считает, сколько вам памяти, сколько вам видеокарточек, каких для какой сетки нужно, в какой квантизации и так далее.
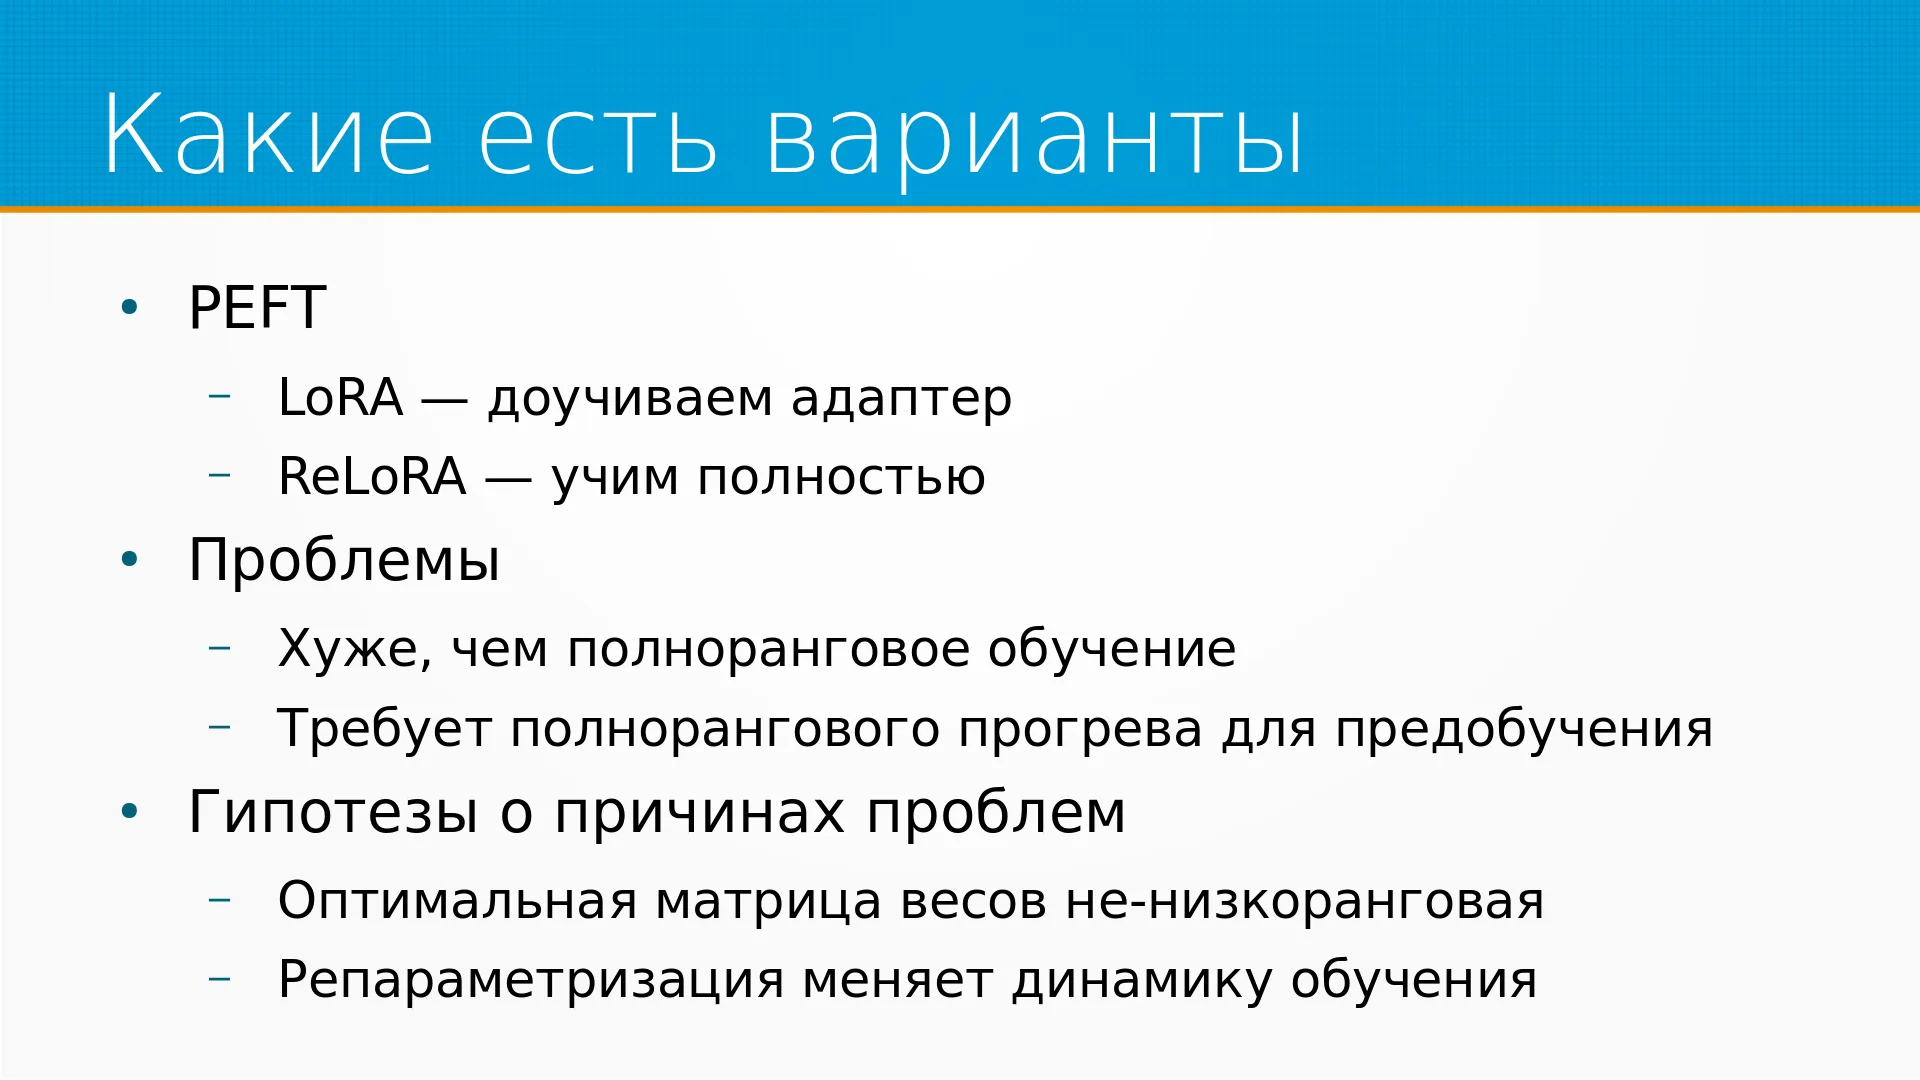
Вот, какие вообще есть варианты учить большие сетки на маленьких картах? Есть разные экзотические варианты, но чаще всего используется просто LoRA. В LoRA мы доучиваем некий адаптер более низкой размерности, то есть мы строим проектор из нашего пространства весов, и выучиваем, сами веса замораживаем, а выучиваем добавку к ним. Некоторую матрицу более низкой размерности, которую мы потом назад разворачиваем в высокую размерность и добавляем к весам модели при инфинити. Это открывает кучу интересных технических возможностей, например, такую, как быстрое переключение между адаптерами с одной и той же модели прямо в памяти, когда они туда включаются и так далее. И открывает кучу проблем. Один из вариантов LoRA - это ReLoRA, когда мы не только не не просто учим наш адаптер, но потом вот эти вот веса время от времени, которые мы должны были добавить, вот эту добавочку мы добавляем к основным весам и дальше учим. Это несколько улучшает качество, но проблемы всё равно остаются. Проблем главных две.
Во-первых, всё равно получается, что это хуже, чем полноранговое обучение или файн-тюнинг. И второе, что если с нуля мы так сетку не обучим. Мы можем дообучить хорошо обученную сетку, но учить с нуля сетки так невозможно. Вот, есть гипотеза о причинах страдания. Основная, что оптимальная матрица весов, она не низкоранговая. Когда мы учим LoRA, мы на самом-то деле учим ищем минимумы в низкоранговом пространстве. Задача сама сложнее, чем LoRA. И, соответственно, найти её не получается. Вторая проблема гипотеза о причинах страдания, это то, что вот такая репараметризация, она меняет динамику обучения, попросту говоря, оптимизатору Adam неудобно работать с LoRA.
Поэтому получается хуже. И вот ребята придумали GaLore, такой такой подход, когда мы не учим низкоранговый адаптер к весам.
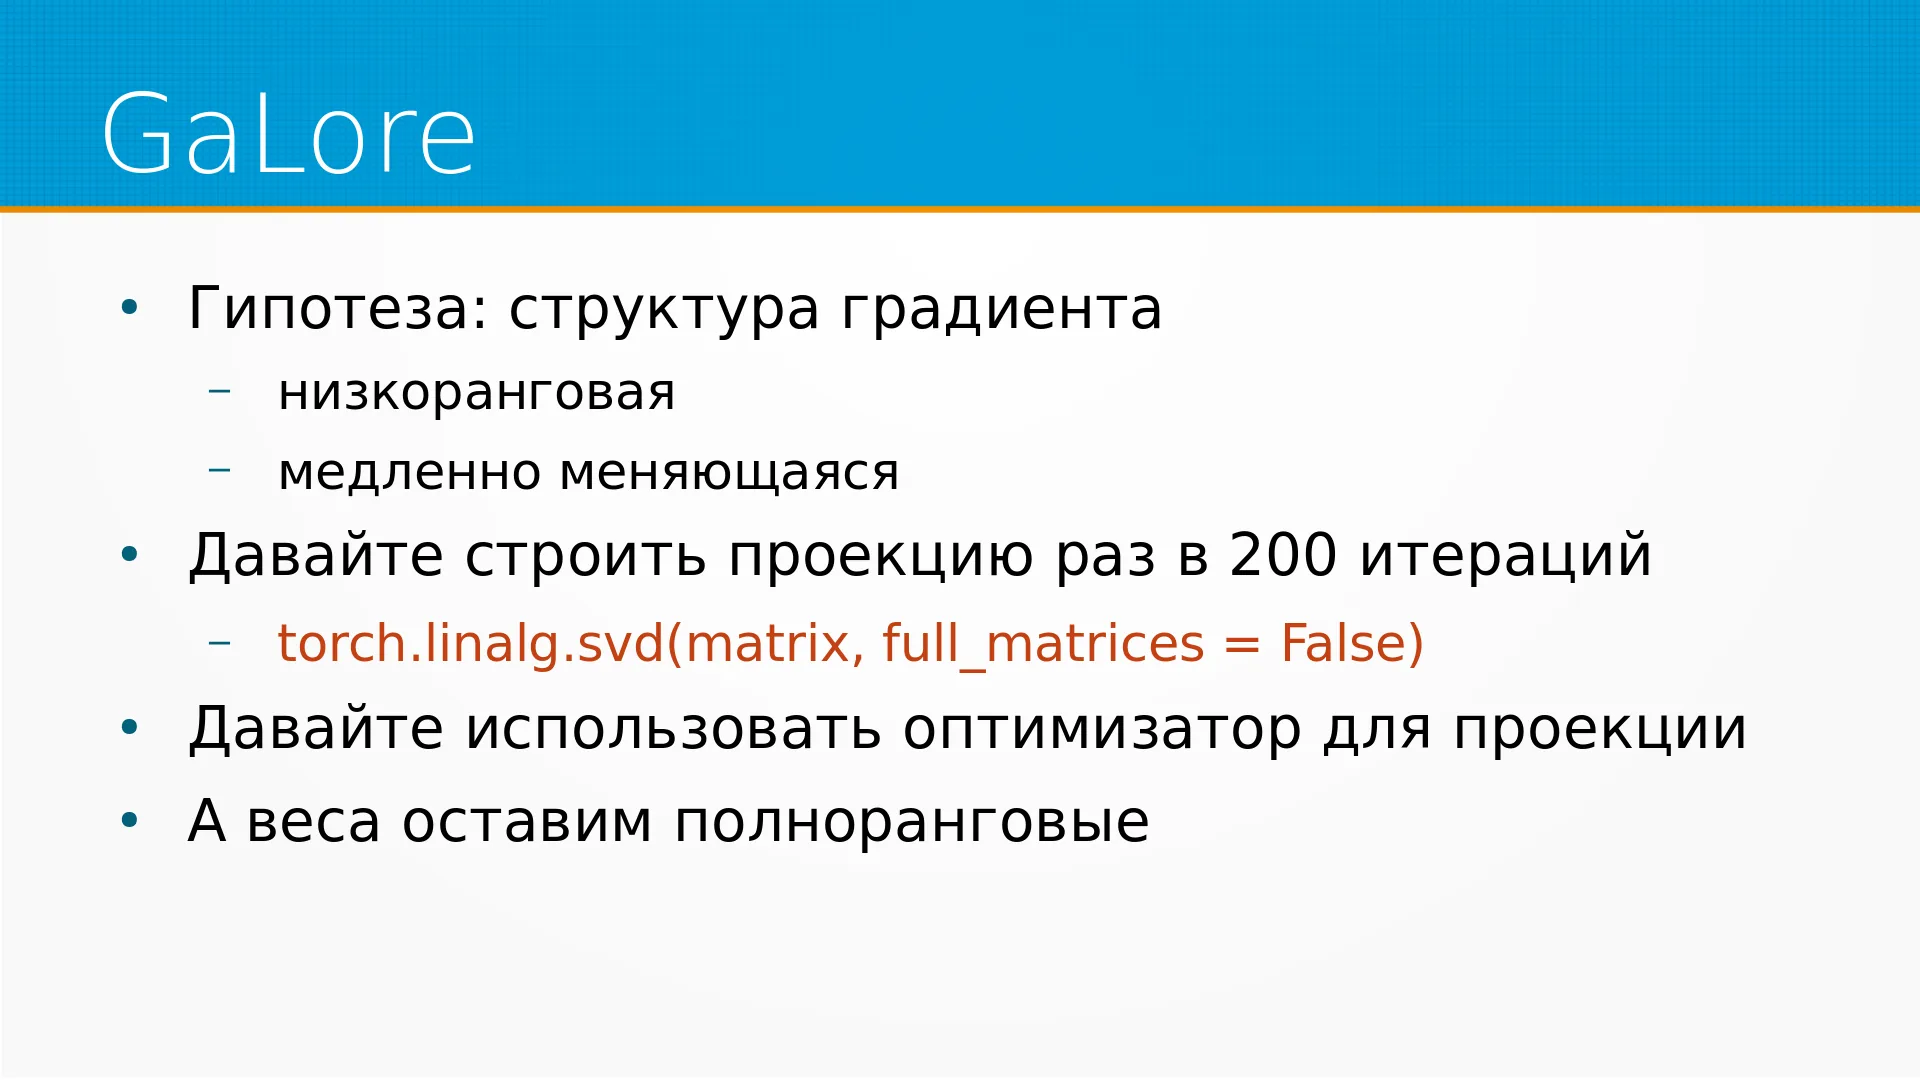
Веса мы учим в полном ранге. Вместо этого мы используем низкоранговую проекцию градиента. Они выдвинули такую гипотезу, что структура градиента, она низкоранговая. Грубо говоря у нас градиент лежит на каком-нибудь многообразии, его можно без особенных потерь дисперсии спроецировать на пространство сильно меньшей размерности. И что вот эта структура градиента, как он лежит в этом пространстве высокой размерности, она медленно меняется, то есть он медленно разворачивается. И они говорят: "Давайте мы будем раз в 200 итераций строить проекцию градиента в пространство более низкой размерности". Не заморачиваясь, просто SVD. И уже эту проекцию градиента мы будем оптимизировать обычным человеческим градиентом оптимизатором. У нас матричное преобразование, и как бы градиент через него спокойно туда прошёл. Оптимизатор с ним работает, как ему удобно.
Оптимизатор можем использовать любой: Adam, SGD, вот прямо что нам нравится, то и будем использовать. Потом, когда оптимизатор эту нашу проекцию градиента как-то использует, соптимизирует, мы назад распроекцируем, обратное преобразование сделаем. И сдвинем наши веса в нужную сторону, наши полноранговые. Мы ищем минимум в нашем пространстве высокой размерности, но считаем, что градиент у нас лежит в пространстве низкой размерности.
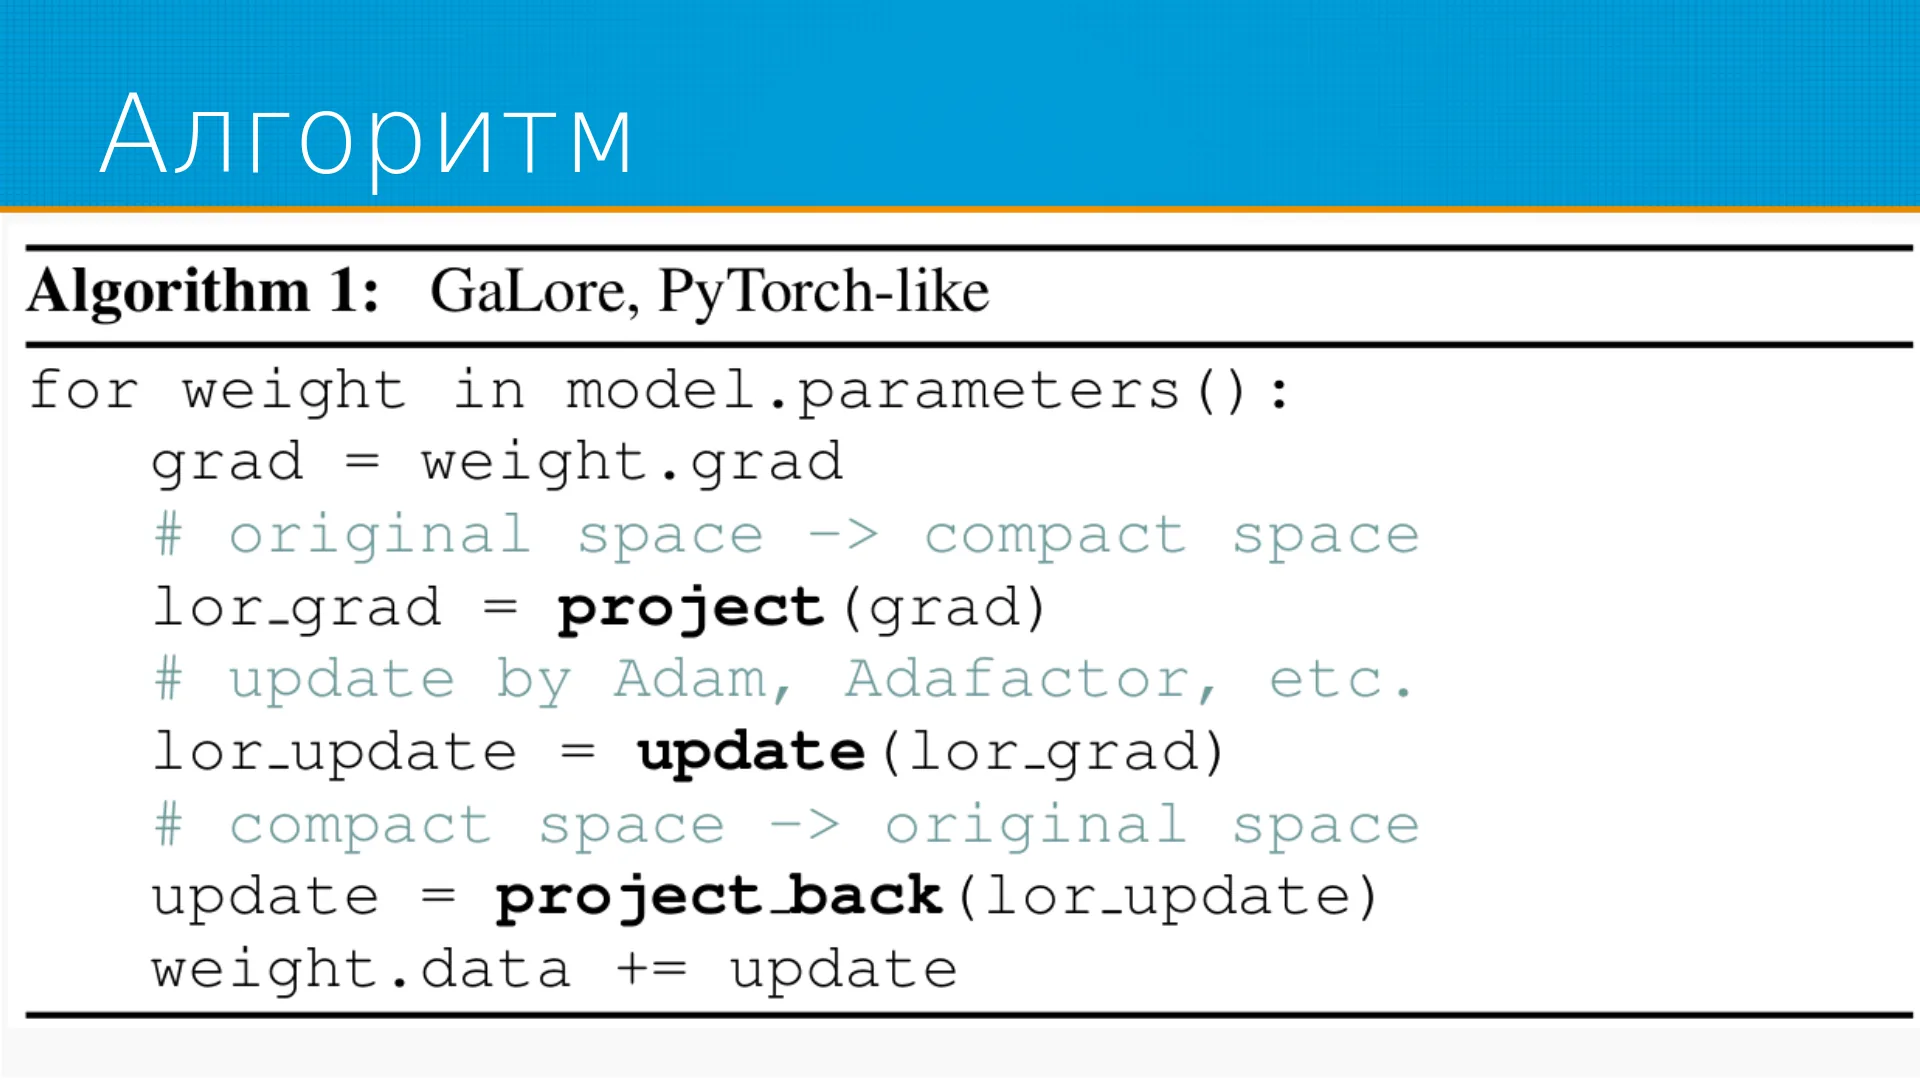
Сейчас будет чуть понятнее. Вот, то есть алгоритм вот такой немудрящий. Понятно, почему его сразу все реализовали, потому что он действительно простой. Мы получаем наш градиент от весов, проецируем его в низкую размерность, как-то обновляем нашим оптимизатором и проецируем назад и прибавляем к весам. Всё, больше тут ничего нет. Есть одна проблема, что мы выучили вот эту проекцию.
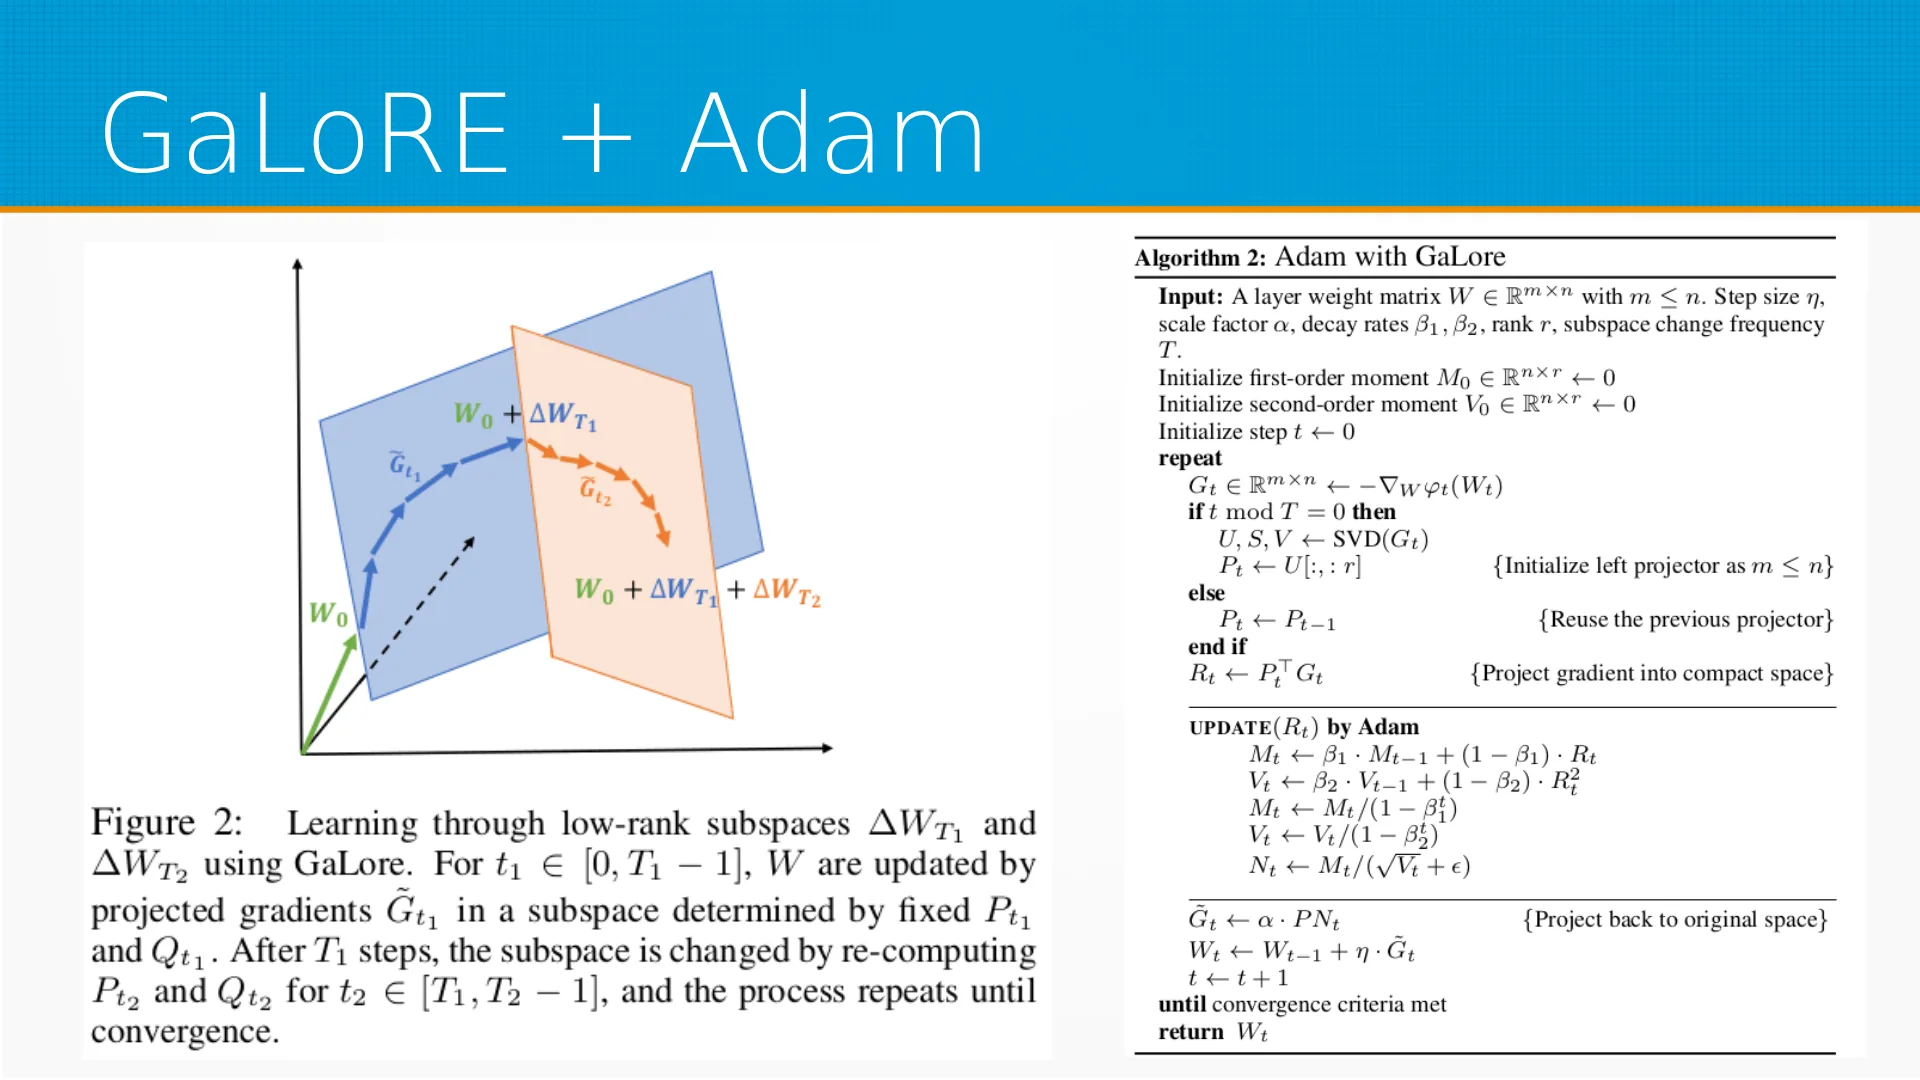
Градиенты двигаются, и в какой-то момент, на самом-то деле ориентация градиента может поменяться. Они говорят: "Ну, хорошо, мы вот раз в 200 или сколько там, от 50 до 1.000 итераций выучим заново эту проекцию". Это небольшой оверхед добавит, но дальше мы будем двигаться по вот этой вот новой подповерхности. Под под под под пространству. И собственно, алгоритм оптимизации с GaLore, он такой немудрящий. Тот же самый Adam, просто проекция до и обратная проекция после.
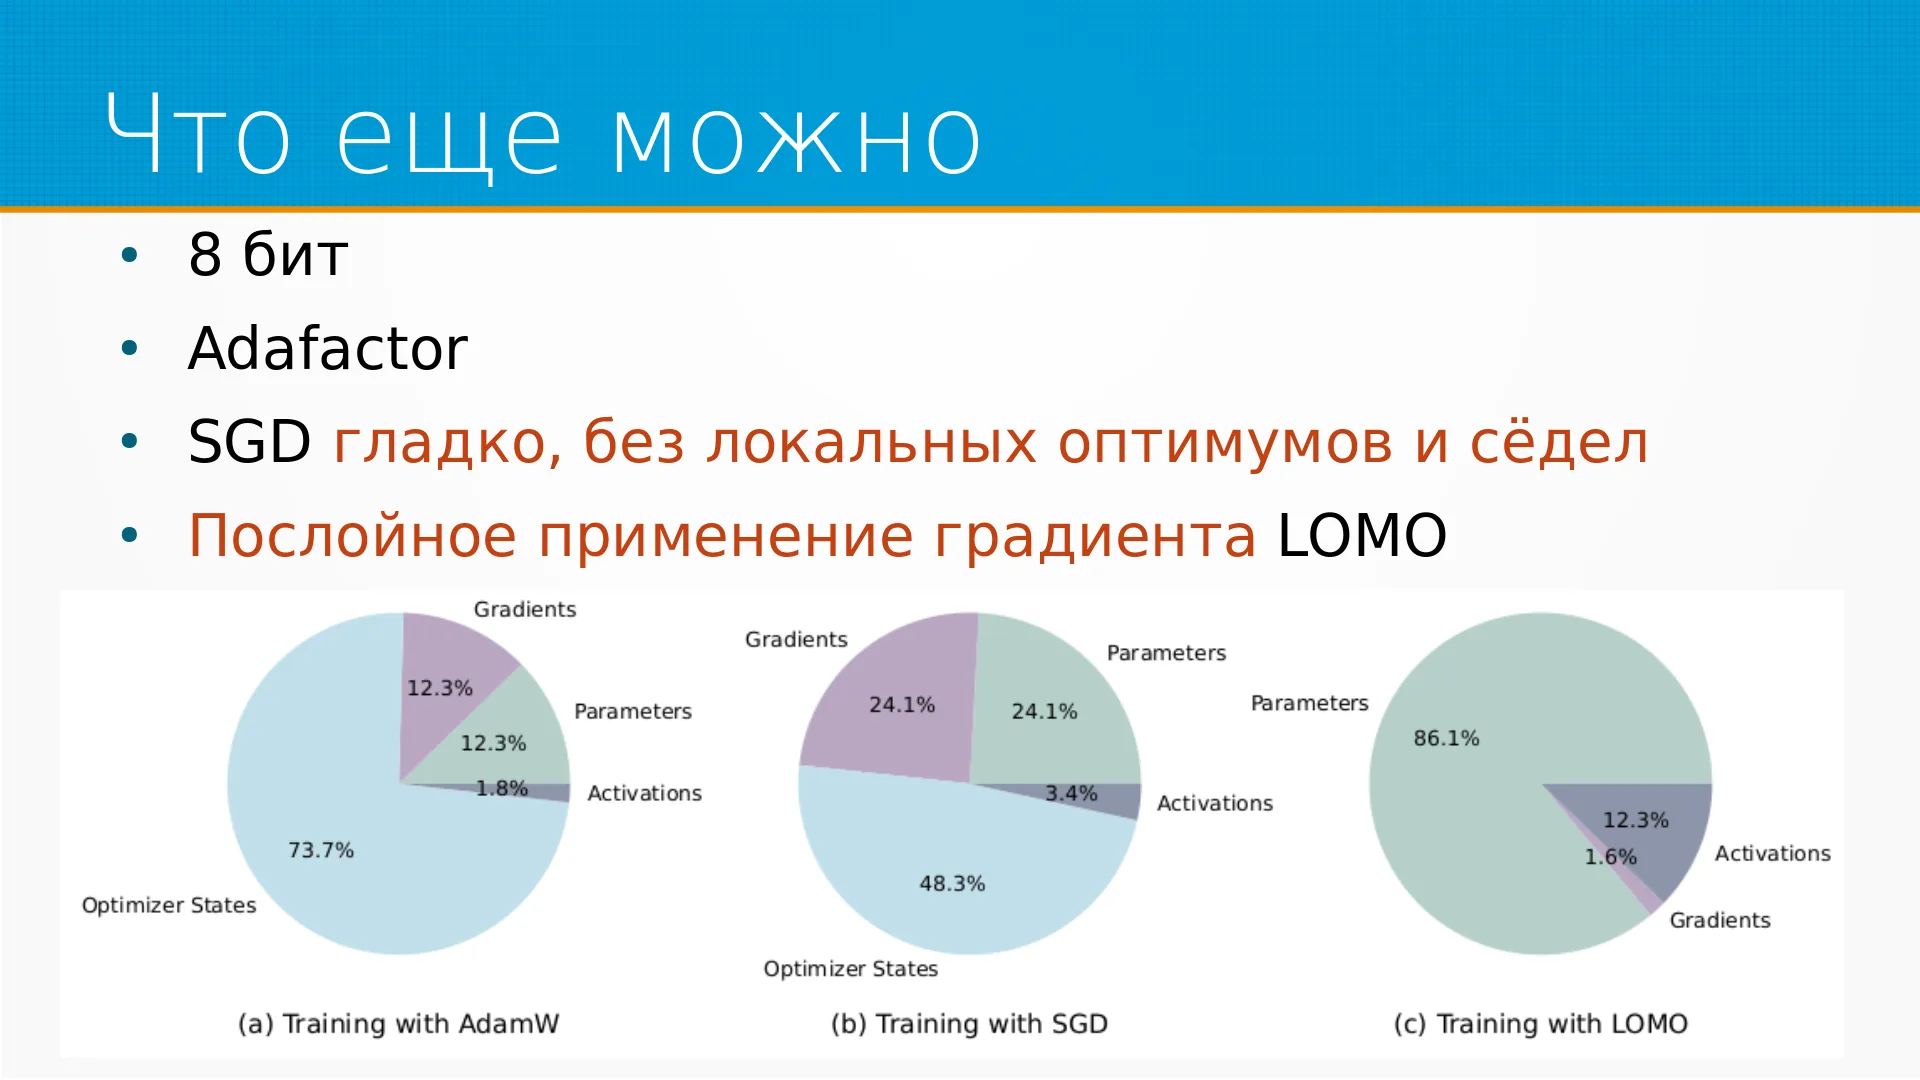
Если мы уже опустились во все тяжкие, ужимать память, что ещё можно, что обычно используют? Конечно, используют квантизацию 8 бит. Есть ещё AdaFactor, например. AdaFactor это тот же самый Adam, только у нас там сильно снижены требования к весам. Есть ещё более интересный подход. Почему, собственно, SGD не используют обычно? Потому что ему трудно сориентироваться в этом сложном пространстве. Но есть предположение, что если хорошее пространство, в котором мы оптимизируем нашу сеть, хорошее - это что оно гладкое, без каких-то таких локальных оптимумов и без седловых точек. Что для меня звучит странно, но тем не менее. Вот, то SGD там будет ничем не хуже Adam, и, может быть, даже и лучше.
И в статье про LOMO есть, а, нет, не в статье про LOMO, это статья, на самом деле, про BERT. Есть предположение, что пространство в котором у нас живут языковые модели, которые выучивают языковые модели, оно именно такое. И это объясняется свойствами языка, на котором оно учится. Если мы будем учиться на синтетических данных, у нас будет негладкие, с локальными минимумами, седловыми точками и так далее. Но сам по себе язык лежит на таком каком-то хорошем многообразии, и когда мы начинаем учить его сетками, то, в общем, всё хорошо должно бы быть. Вот, непонятно, почему тогда SGD не работает. И ещё одна хорошая идея - это про последовательность Последовательное послойное применение градиента.
Обычно как делают? Берут наш градиент, потом как-то на его основе вычисляют апдейт для весов и потом этот апдейт применяют. И таким образом у нас в памяти этот апдейт висит весь полностью, весь градиент у нас оперируется. Мы могли бы брать первый слой, провернуть с ним эту операцию, но самый не первый, а последний, самый ближний к нашему источнику градиента, к нашей разметке. Применить этот градиент, потом перейти на следующий и тоже применить. Это приведёт к тому, что мы всё время храним только маленький кусочек градиента в памяти, с ним оперируем. Здорово позволяет сэкономить память, но, правда, оставит перед нами вопросы о числовой стабильности такой математики. Вот есть подход LOMO и ссылка на статью, который говорит, что мы можем градиенты вообще почти и не хранить.
Это авторы статьи на эти штуки ссылаются, как раз говорят, что вот мы решили, что нам нужно упихать 7B ламу в одну видеокарту и пустились во все тяжкие.
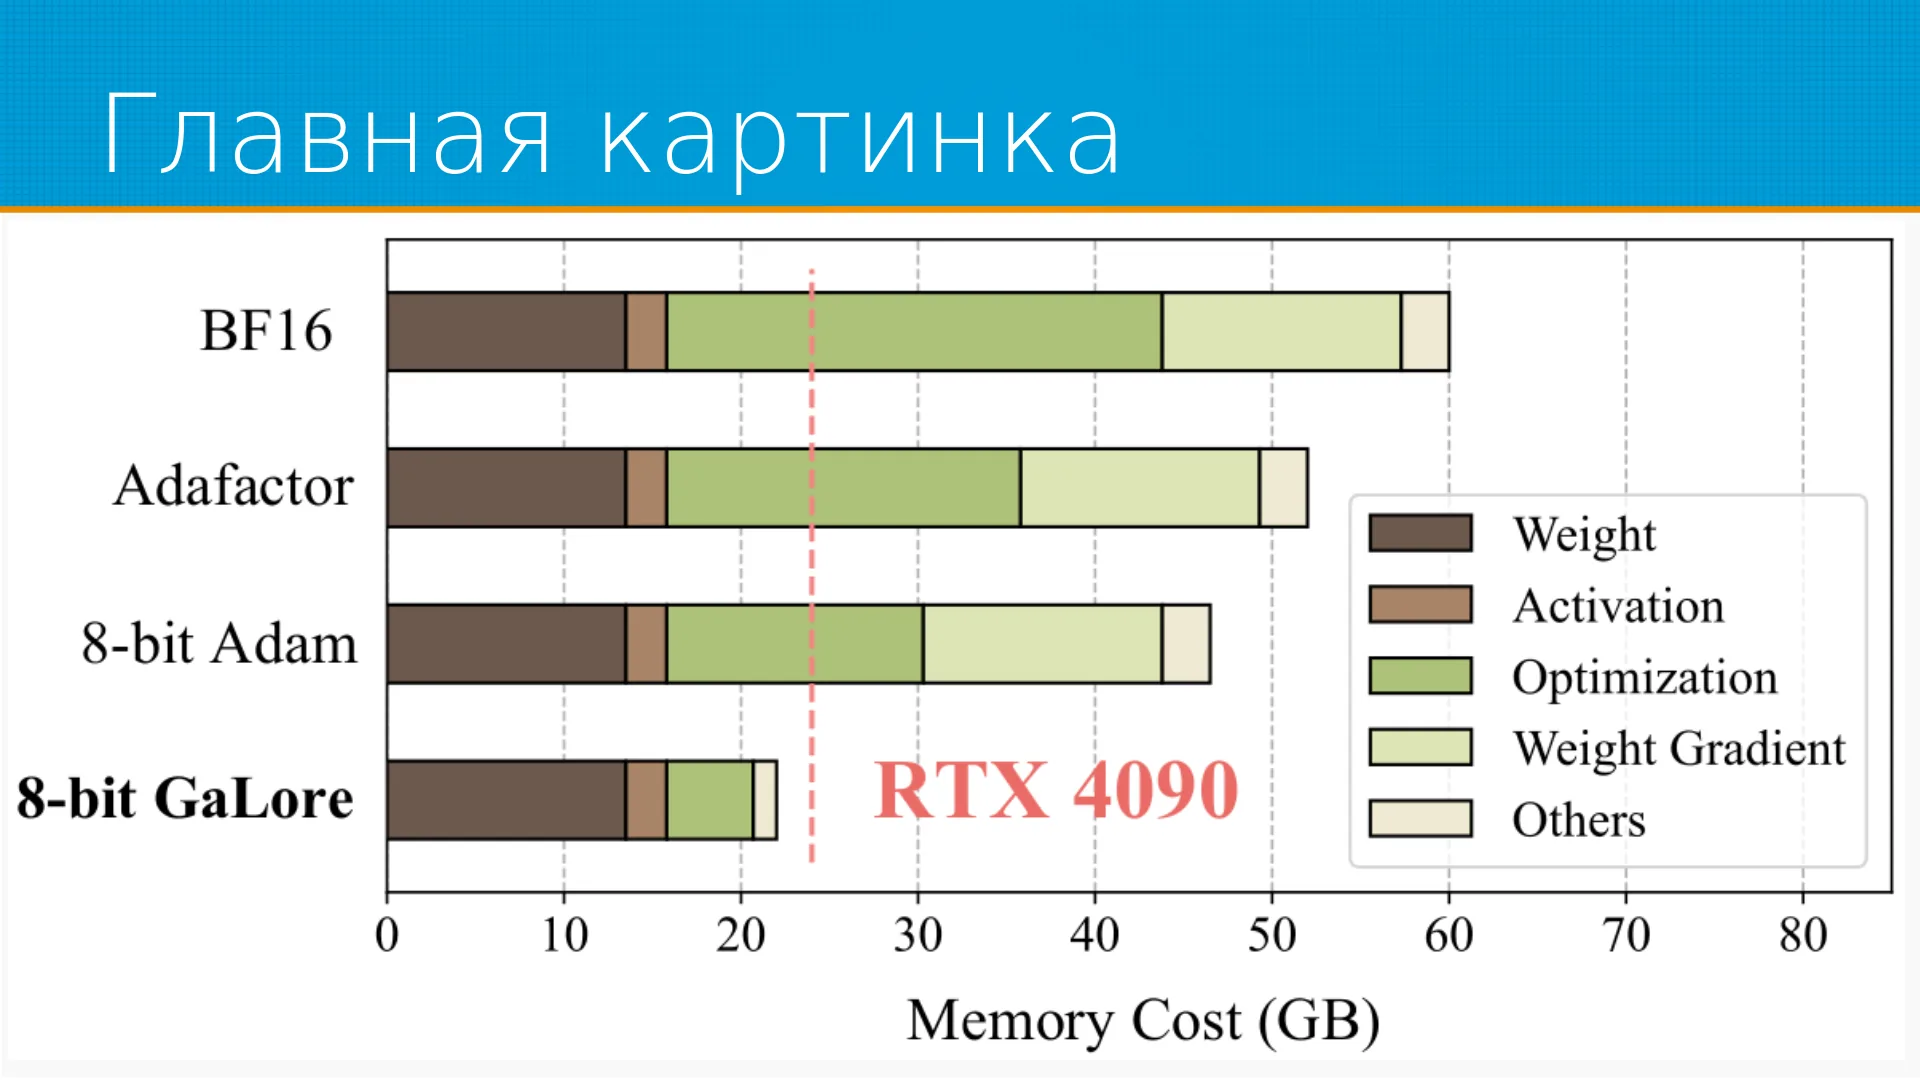
И вот что у них получилось. Если лама 7B в BF16 так занимает под 60 гигов, с адафактором 50 с небольшим, восьмибитный Адам она у нас занимает чуть больше 40. Вот, то восьмибитный GaLore, она занимает у нас 23, по-моему, с половиной или 22. И таким образом мы все можем сразу идти и доучивать ламу.
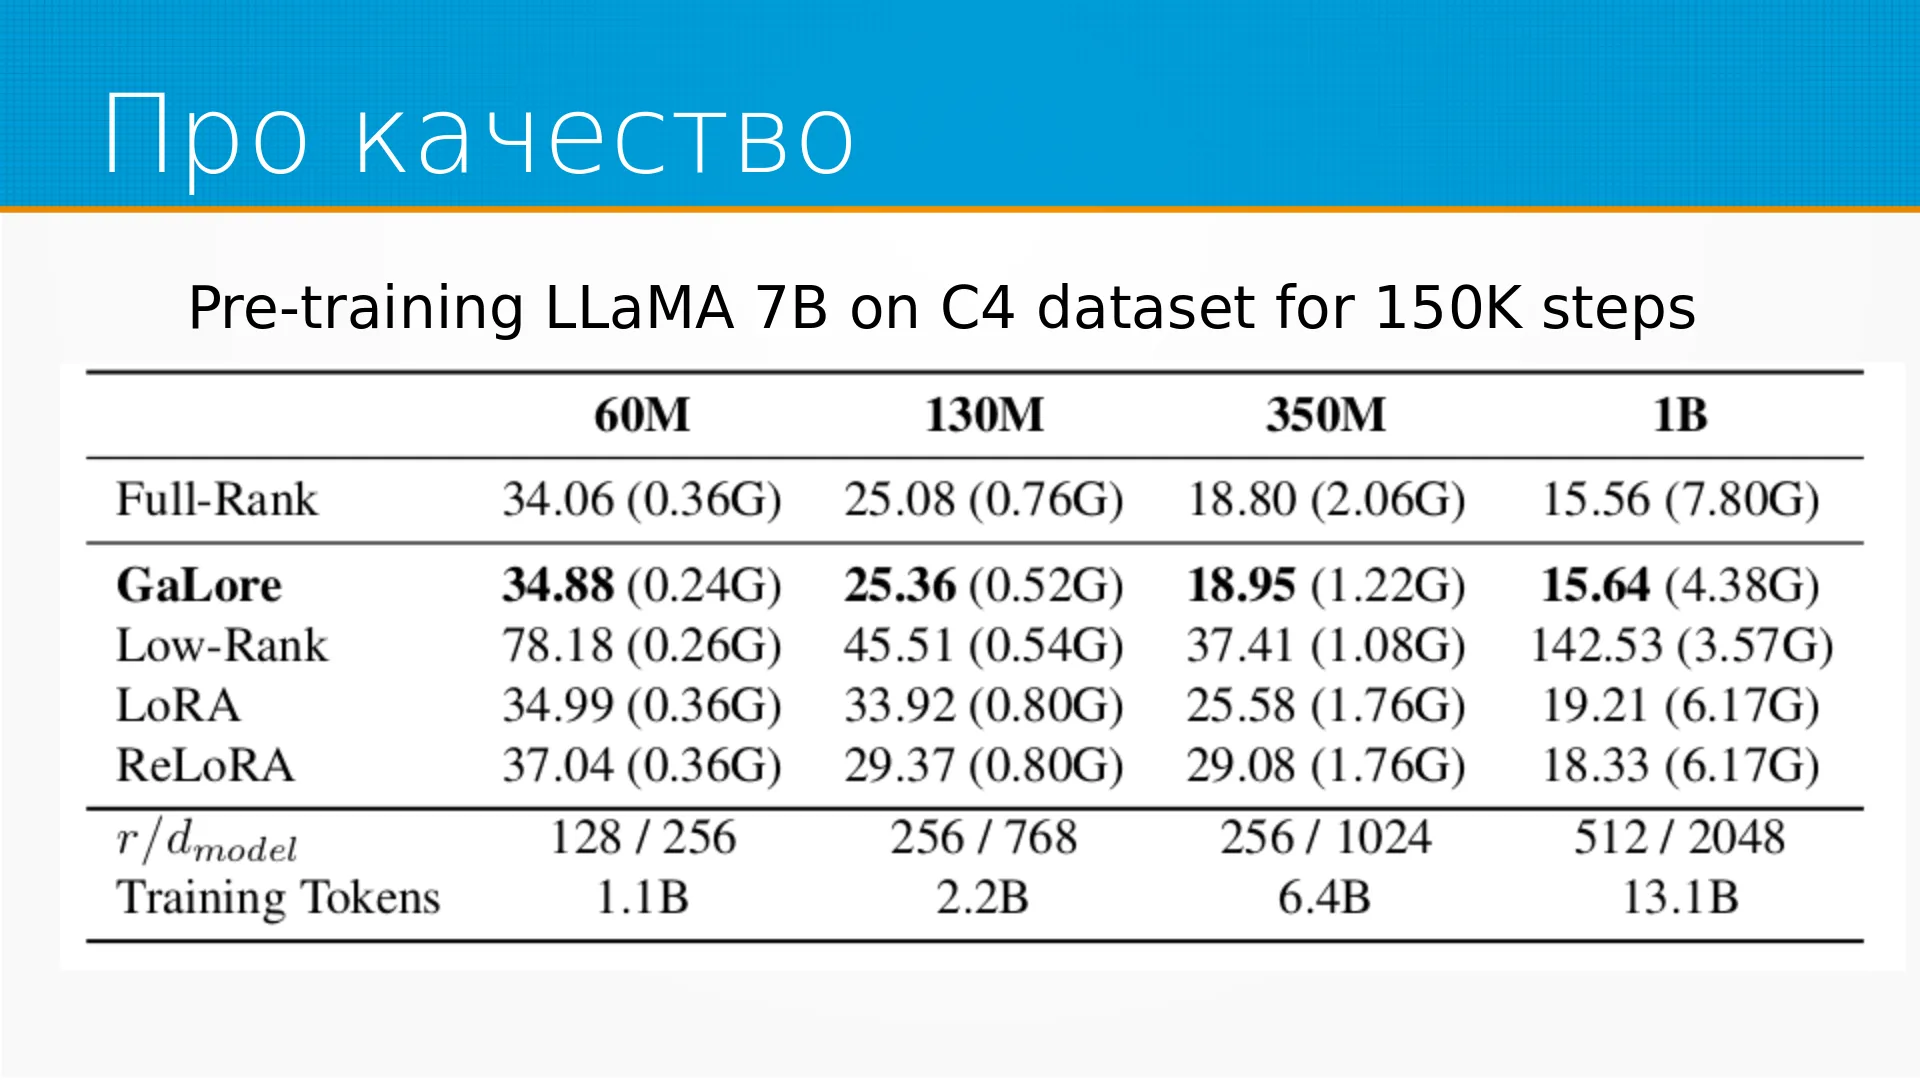
Какое будет качество? С качеством получается, что GaLore похуже, чем полноранговое обучение нормальное. Это неудивительно. Но хуже не то чтобы сильно. Вот тут у нас показывается перплексия при разных размерах сети, разном количестве токенов. И, кстати, обратите внимание, внизу там написано вот это R. R - это как раз сколько компонент градиента оставляют. 128 компонент градиента, 256 компонент градиента. Достаточно мало. И мы видим, что перплексия GaLore от полноранговой обученной сетки-то почти не отличается. Отличается не так чтобы систематически. Она здорово обгоняет LoRA и ReLoRA тоже. Это приятно. В восьмибитах всплывает ещё одна, что натворил Адам и что натворила GaLore.
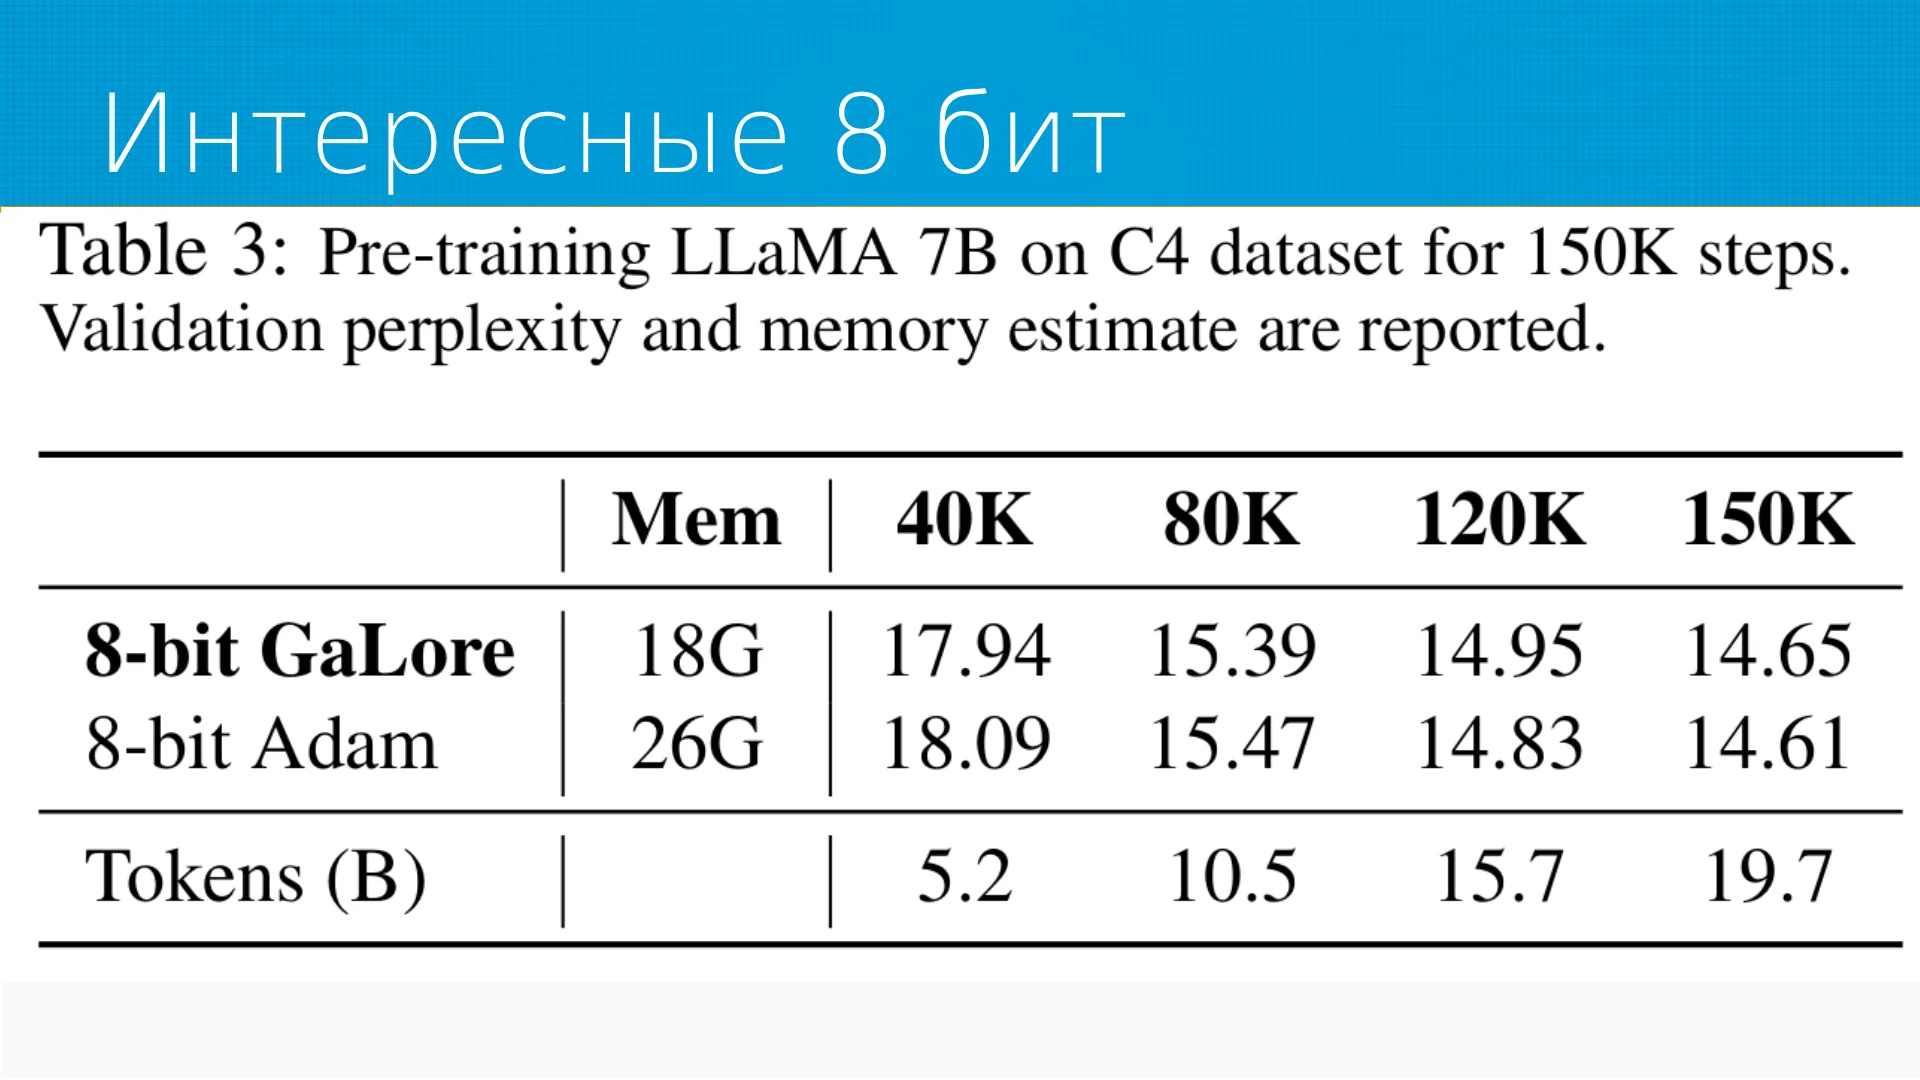
То получается, что перплексия на 40К и на 80К шагах, она даже лучше, чем у Адама. Она не просто не хуже, она лучше. И это связано с тем, возможно, что за счёт того, что мы отбрасываем некоторые паразитные кусочки градиента, в которых ничего, кроме шума нет, то есть вот эти вот компоненты маленькие. Мы просто в начале учимся эффективнее, банально. И если посмотреть, что у нас с производительностью, мы, конечно, проседаем по производительности за счёт того, что нам нужно время от времени считать эту самую.
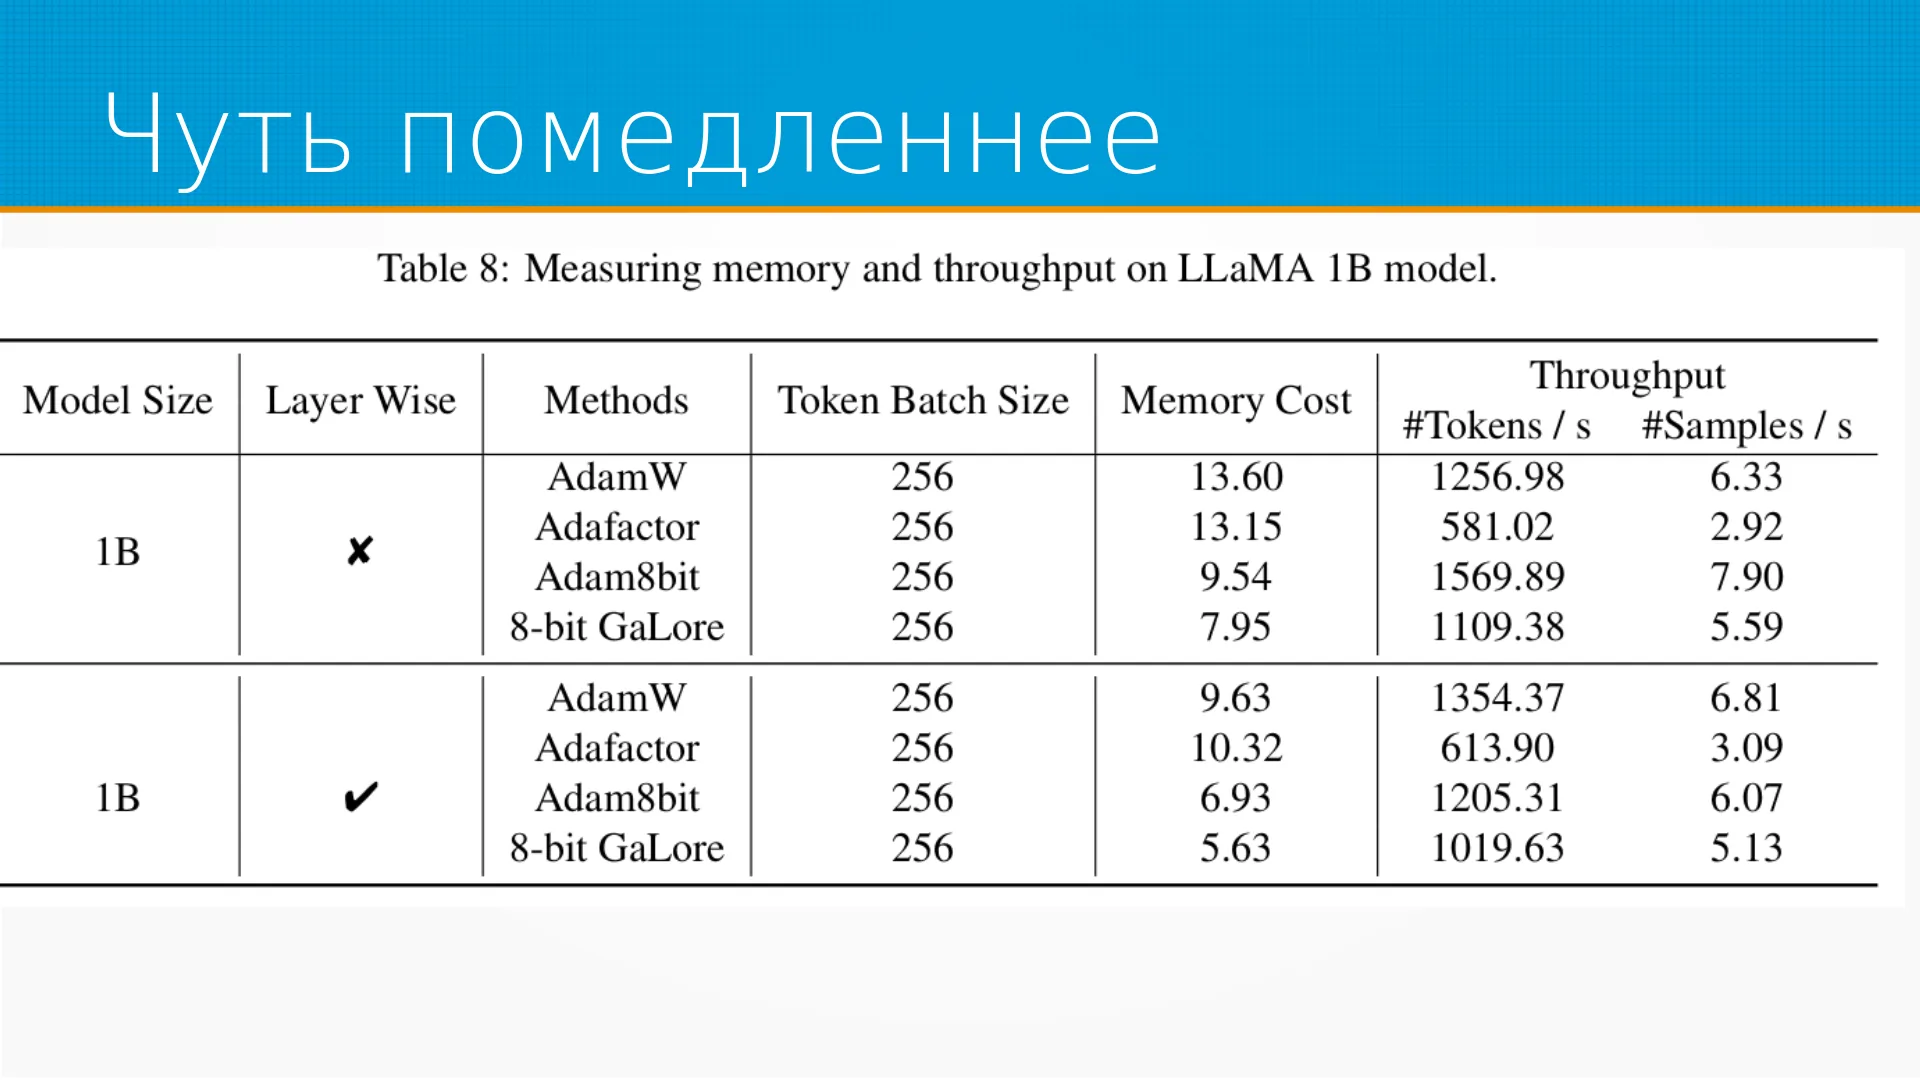
GaLore он медленнее, они в статье пишут про 10%, ну вот я тут глазом вижу 20. Вот, но тоже не то чтобы так принципиально. Если нас ограничивает больше память, чем скорость, как часто бывает, то прямо очень хороший вариант.
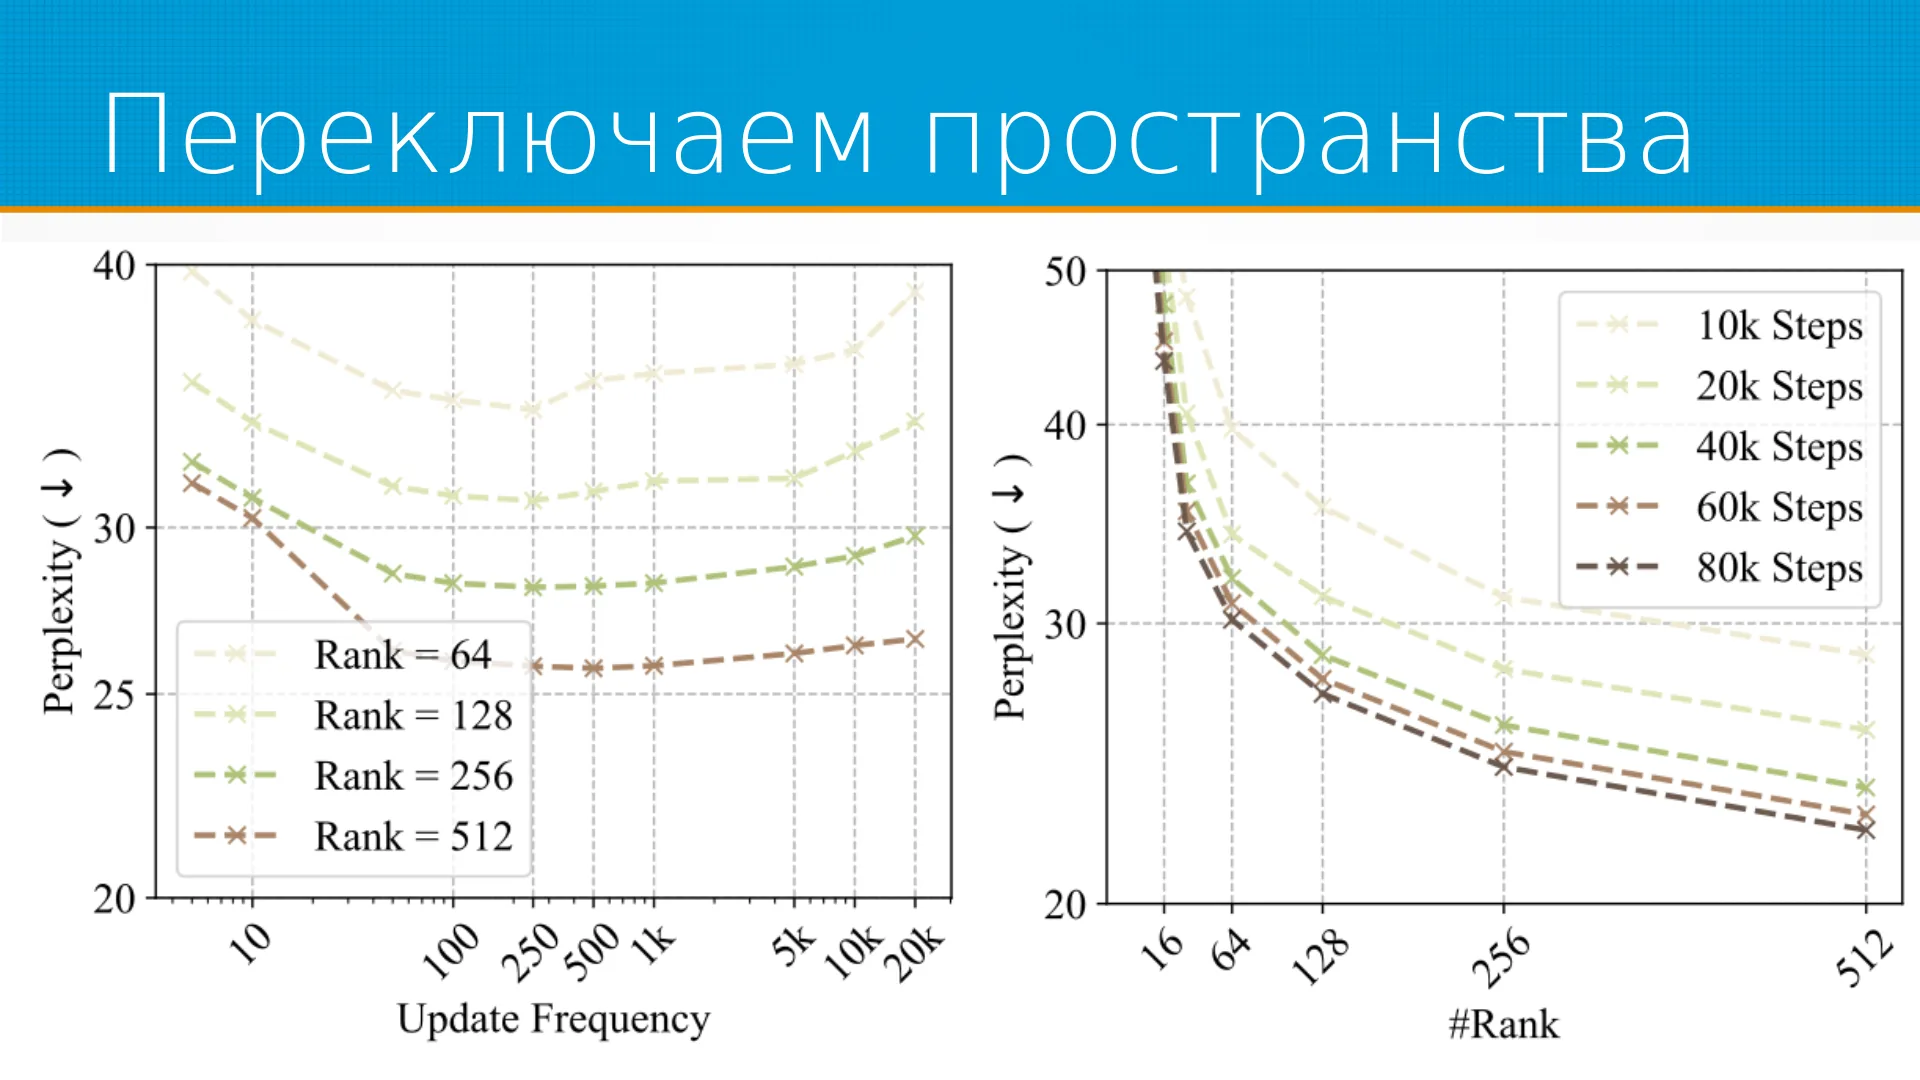
Много ли надо пространств? И часто ли их надо переключать? Они провели исследование, и у них получилось так, что примерно раз в 50 или раз в 1000, где-нибудь в этом диапазоне мы переключаем пространство, и получается примерно одно и то же. Вот здесь они исследовали, как оно себя ведёт при разной частоте переключения, при 64, 128, 256, 512. И если я правильно понял из статьи, 512 - это на самом-то деле нижняя разумная граница, то есть ниже 512 опускаться особенно смысла нет. Ранг. И с другой стороны, как у нас от ранга зависит перплексия, которую удалось достигнуть за заданное количество шагов. И видим мы, что в общем, чем больше ранг, тем лучше перплексия, но тоже она резко так меняться на 512 перестаёт.
На тысячах она почти такая же, как на 512.
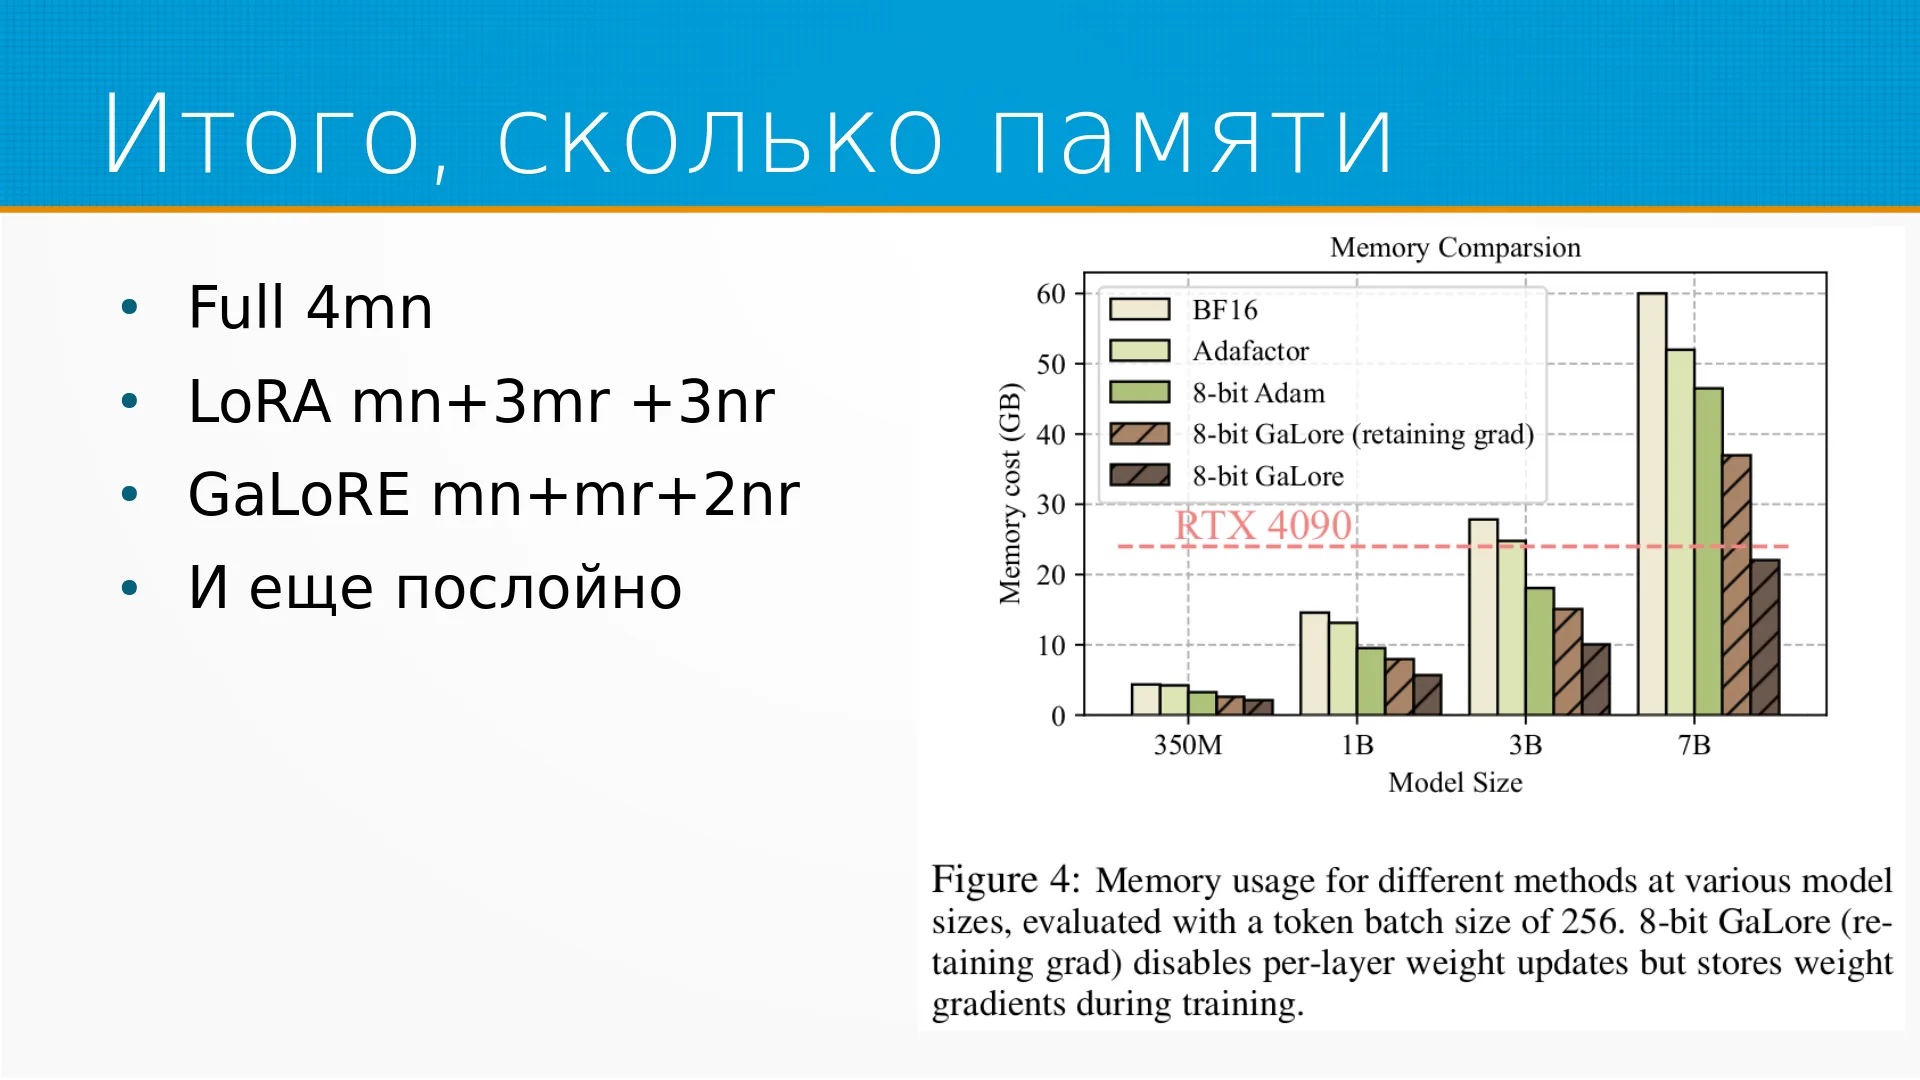
И итого, как посчитать, сколько памяти нужно. Если мы учим полноранговую просто Адамом, то нам нужно в четыре раза больше, чем у нас весов. С LoRA нам нужны веса и две матрицы. R - это ранг вот этой матрицы низкой размерности, он в LoRA такой такой же примерно смысл имеет. В GaLore нам нужно меньше, чем в LoRA. И ещё мы можем всё это дело обновлять послойно, как в LOMO. И видим, что вот если мы всю эту массу 7B вполне. Как ведут себя оптимизаторы в этих условиях? Мы говорили, что с LoRA им немножко неудобно.
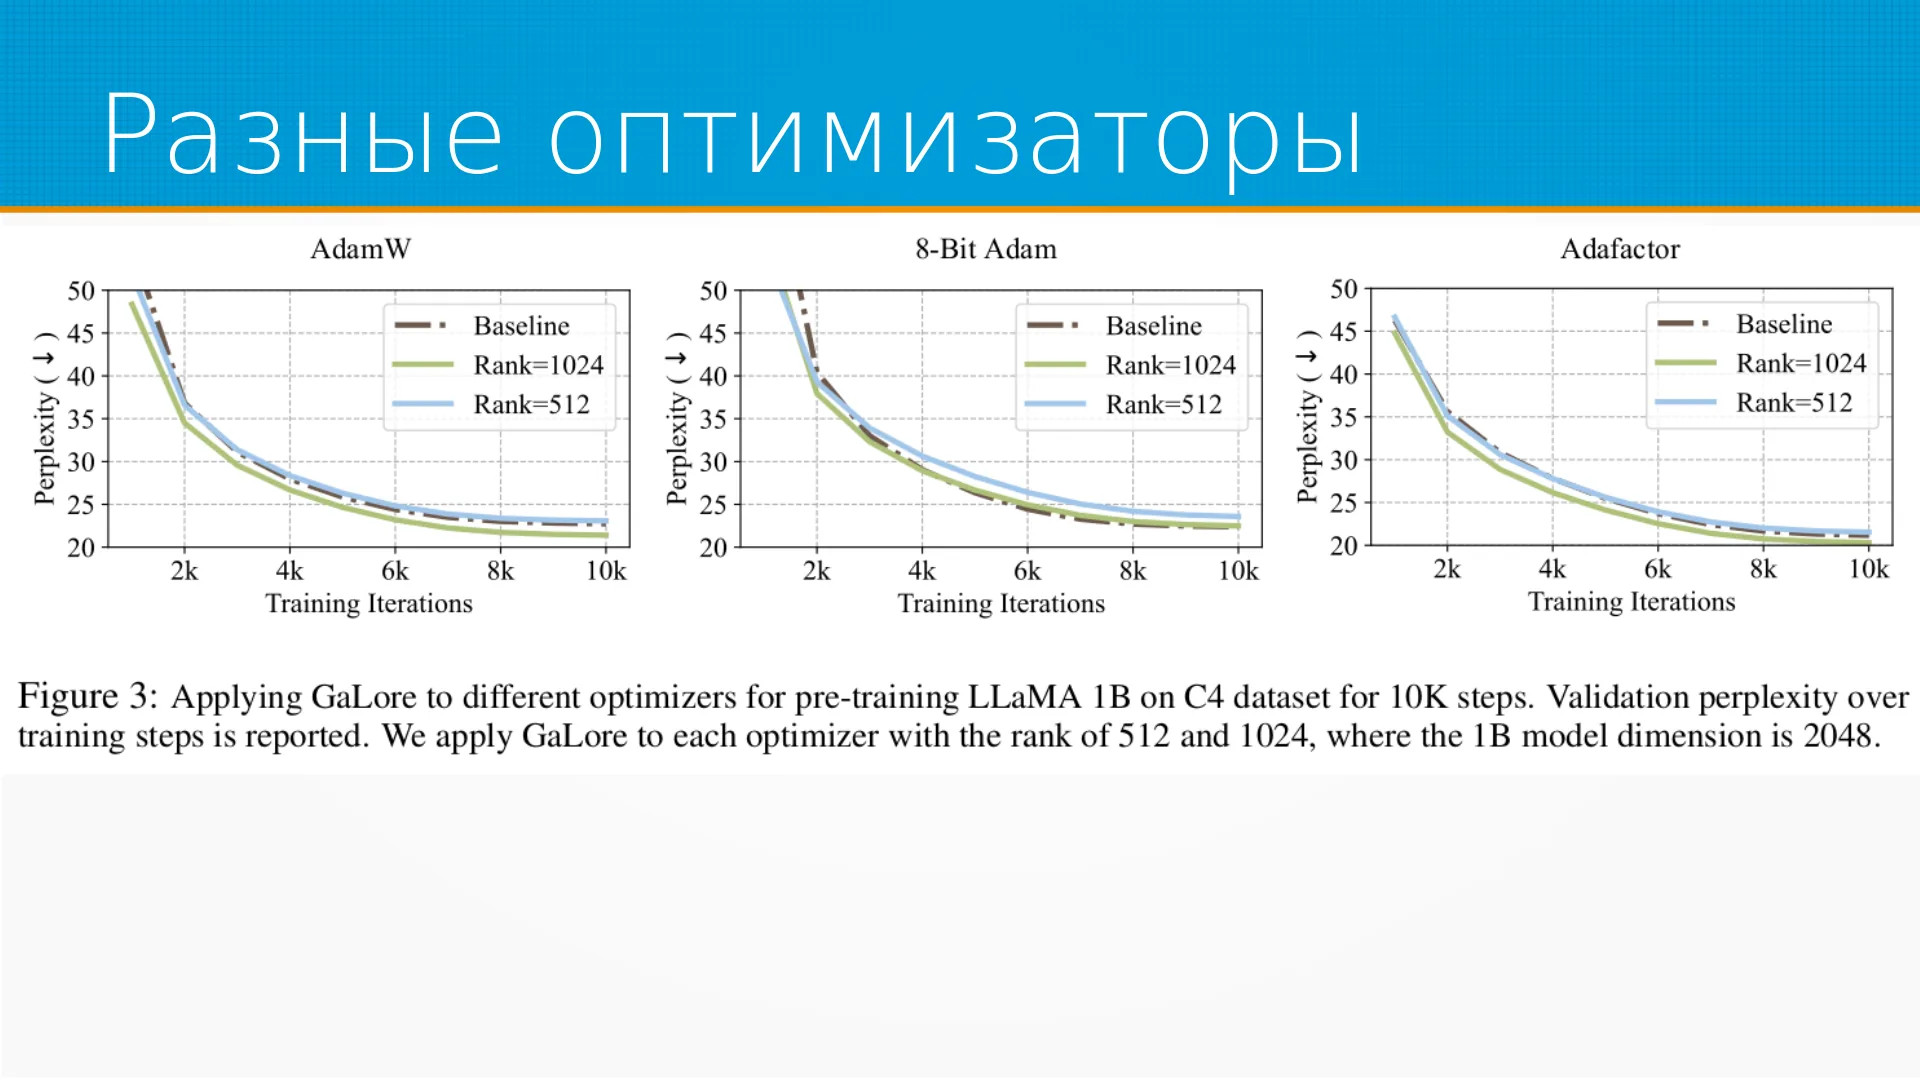
Смотрим мы, применяем AdamW, просто Адам, Адафактор. Видим, что на самом-то деле с GaLore им удобно. И ещё мы видим, что 512 низкоранговое отображение градиента, оно, конечно, проигрывает в перплексии бейзлайну. Вот, 1024, оно не проигрывает. Оно либо такое же, либо где-то чуть-чуть лучше, чуть-чуть хуже в общем, плюс-минус. Наверное, как раз в силу того, что оно выступает как такое подавление шума градиента.
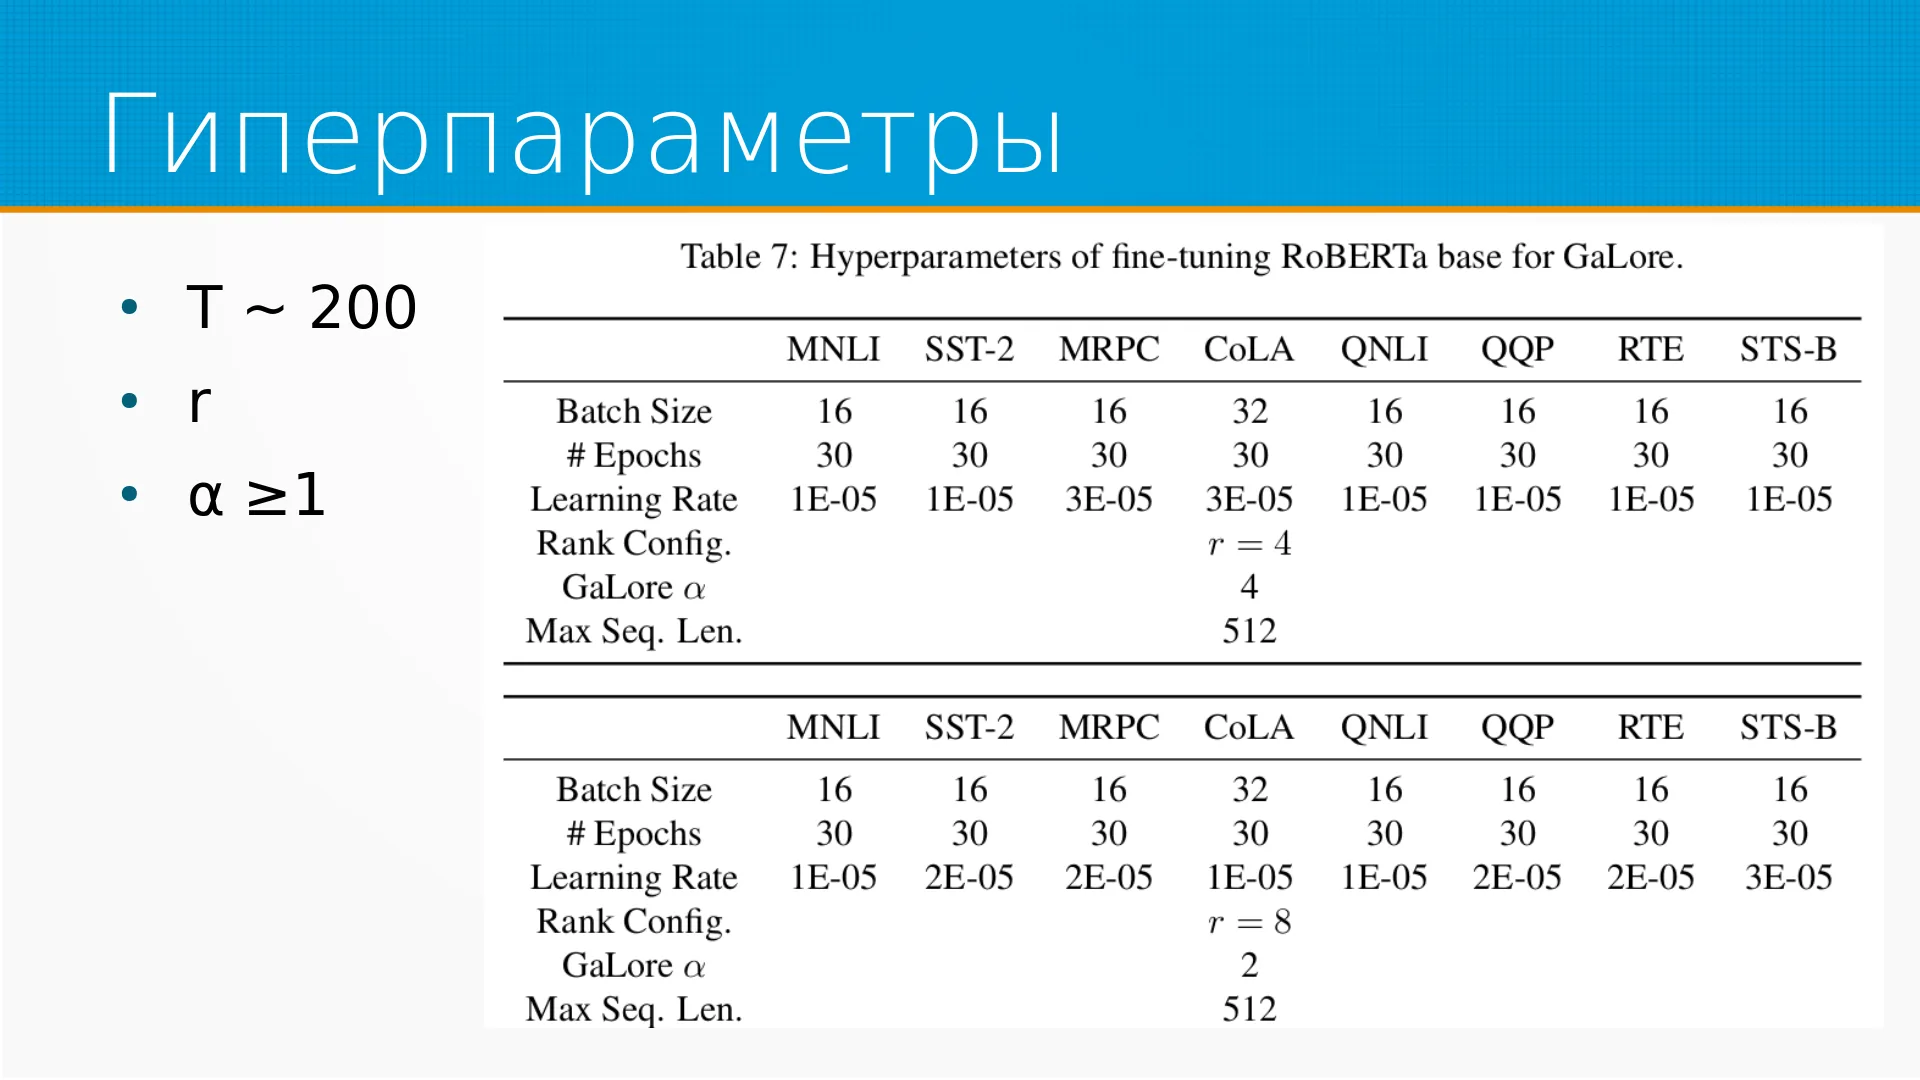
У GaLore есть три дополнительных гиперпараметра. Первый гиперпараметр - это частота обновления проектора. Они говорят, что от 50 до 1000 у них ничего серьёзно не менялось, но надо понимать, что они разминались с LoRA. В вашем случае, может быть, не так. Ещё есть параметр R - это, собственно говоря, ранг. Можно предположить, что для сетей типа LoRA 1024, да. И ещё у нас есть параметр альфа. Что это такое за альфа? Когда мы спроецировали назад наше изменение градиента, то есть то, что мы должны учить нашу сеть, мы домножаем его ещё на некоторую константу больше единицы. Почему нам нужно домножать? Потому что мы сохраняем не всю дисперсию при проекции, и, соответственно, у нас просто часть теряется.
По-хорошему, вот эта альфа должна быть примерно пропорционально тому, во сколько раз мы потеряли дисперсию при проекции низкой размерности. Это тоже подбирабельная вещь. По-хорошему, опять же, поскольку потом мы эти штуки умножаем на learning rate, а learning rate он там плюс-минус один порядок для Адама примерно всё равно, то это не должно быть очень критично. Можно сколько градиента у нас остаётся в нашей проекции и посчитать её. Это опять же, вот в статье способа подсчёта альфы я не нашёл, это просто мои размышления, глядя в их код.
И встаёт вопрос, почему так можно. Они не поленились и на трёх страницах расписали доказательства, которые я смотрел не очень внимательно, поскольку выглядит правдоподобно. Я не математик. Скорее всего, самая нижняя правая, собственно. Вот, там примерно такая фраза, если в грубом переводе с английского. Вот, дальше они отдельно доказывают, что преобразование это обратимо. Так можно всё-таки потом и что оно сходится. Тому, что естественные языки лежат на чем вот та размерность градиента, которую мы хорошем многообразии сети светлое будущее гонят.
Дмитрий: LOMO, GaLore на нём много. Что называется? И вот есть код GaLore Adam W и GaLore Projector. Там меньше 100 строк кода, что там прямо настоятельно рекомендую. Вот там что там, примерно всё.
Ведущий: Спасибо большое. Есть ли у кого-нибудь вопросы? Можно задать вслух, можно в чате. Мы подождём, я это на правах спрошу. Вы это ради интереса нашли эту статью или у вас как-то сейчас связаны проекты и вы действительно пытаетесь оптимизировать модель?
Дмитрий: Проекты связаны, проекты связаны и более того, не далее как сегодня многоуважаемый заказчик говорит: "О, говорит, а что же, говорит, мы грог-то не доучиваем?" Свежевыложенный. В 200 с чем-то Б.
Ведущий: Угу.
Дмитрий: Вот, поэтому как бы
Ведущий: Интересно.
Дмитрий: Да.
Ведущий: Ага, а и вот про гиперпараметры как раз хотела спросить, а их значения не так не взаимосвязаны, не должны быть взаимосвязаны друг с другом?
Дмитрий: По идее, альфа связана с R на D.
Ведущий: Угу.
Дмитрий: Где вот D - это, в общем, Длина последовательности. Посмотрели, и вроде бы как при файн-тюнинге плевать, не связано. Такие глупости.
Ведущий: Так, я прошу прощения, ага, у меня тут Сбер Джаз иногда интернет отваливается у него, я не знаю почему.
Дмитрий: Угу.
Ведущий: Ага, спасибо. Так, может ещё у кого-нибудь есть вопросы или комментарии?
Из зала: Можно да, вопрос задать.
Ведущий: Угу.
Из зала: Да, спасибо большое за доклад. Вот, вот как раз вот на этой таблице сейчас на слайде, если смотреть, это получается максимальный размер модели, который авторы пробовали экспериментов, это 1Б, да?
Дмитрий: Не-не-не-не, они, они учили 7Б непосредственно. Это
Из зала: Вот именно в сравнении методов дообучения, да, то есть это
Дмитрий: Они там подробно расписывают всякие методы просто они говорят, что у нас было вычислительных ресурсов не так много. Вот, поэтому мы свой вычислительный бюджет именно для табличек вот мы его сожгли, и у нас типа деньги кончились.
Из зала: Угу.
Из зала: Какие-то большие опенсорсные модели они не пробовали, да, то есть в смысле, они
Дмитрий: В смысле, это LLaMA 7B.
Из зала: Тут просто 1Б написано.
Дмитрий: Вот это я, этот самый, то есть тут Заголовок, кстати, это из их статьи же тоже. Может быть, когда так быстро статьи клепаешь и заголовки не успеваешь править. Вот такая вот история. Они учили её восьмибитную, они учили её в BF16. И они учили её также, а, на самом деле, они ещё Роберту учили, вот. Вот это конкретно я не знаю, вот какая из этих табличек. Наверное, вот так, LLaMA 1B они учили, да. Они научили с нуля Роберту. Просто говорит, Роберту с нуля доучить у нас хватило ресурсов, а LLaMA с нуля доучить у нас ресурсов не хватило. И тоже получалось хорошо, там в статье есть табличка соответствующая.
Из зала: Они с нуля обучали?
Дмитрий: По-моему, да. Сейчас я, у меня статья открыта. Так а, нет, они файн-тюнили претрейнет Роберта на GLUE. Вот, 30 эпох они, сейчас я её открою, наверное, просто расшарю эту статью. Сейчас вместо. Так. Как это, наверное, у нас вот это вот, да. Видно табличку, да? Вот они Роберту доучивали 30 эпох. И, в общем у них это их гиперпараметры, и, собственно говоря, что у них тут, а, метрики качества, я не вижу их, наверное. Где-то они были. Угу.
Из зала: Какие в итоге основные выводы статьи, то есть предлагаемый метод будет обгонять существующие?
Дмитрий: Основные выводы статьи, что да, он обгоняет. Да, он обыгрывает главный его конкурент LORA. И LORA он обыгрывает в качестве найденных оптимумов. И в памяти. Грубо говоря, если вы используете GaLore вместо LORA, вам нужно меньше памяти, и вы сойдётесь к лучшим решениям. Вот буквально так.
Из зала: Они сравнивались только на перплексии или какие-то, то есть это бенчмарки также не сравнивались только на перплексии?
Дмитрий: Не сравнивались только на перплексии. Вот, но вообще из общих соображений я предполагаю, что скорее всего так оно и есть. И я думаю, что прямо сейчас кто-нибудь сидит и пробует всё это дело. Но они, они пробовали на перплексии.
Ведущий: Мне показалось, там же были какие-то таблички с метриками по задачам.
Дмитрий: Вот, вот это вот, для маленьких, маленькие сетки они по задачкам отучили, да.
Ведущий: Ага.
Ведущий: Это Роберта?
Дмитрий: Большую LLaMA, да, большую LLaMA они по задачкам не гоняли. Просто у них они говорят, что вот мы как бы кончились ресурсы и всё. Я думаю, что эффект от GaLore будет такой же, как от LORA. Какие-то задачки, которые раньше просто не решались, теперь можно решать. Вот и всё.
Ведущий: Которые не решались?
Дмитрий: Которые не решались имеющимися у нас ресурсами.
Ведущий: Угу.
Дмитрий: Вот, то есть я не очень понимаю, где тут проблема у NVIDIA, но с другой стороны, а, когда у тебя тебе надо очень много карточек, то, в общем, всё равно экономия на них огромная. Когда речь идёт о том, чтобы там учить на кластерах из 60.000 карточек вот Возможность снизить память наполовину - это прямо огонь. Вот они говорят, что мы 65% оптимизатора просто откусили. Вот, а оптимизатор - это 3/4 от общего пространства занятого в памяти.
Ведущий: И это у них есть библиотека уже, да?
Дмитрий: Она лежит на пипе, плюс их, плюс лежит их код. На самом деле, там библиотеки особенно не надо, там я говорю, что там меньше, чем 100 строк кода в их Адаме и в их проекторе. Просто глядя в него, можно его переписать. И есть уже в LLaMA Factory это реализовано. И в трансформерах скоро будет реализовано, потому что уже pull request есть. В общем, вот так. Просто брать и делать.
Ведущий: Качественная работа.
Из зала: Вот в абстракте написано, простите.
Дмитрий: Угу.
Из зала: Вот тут в абстракте написано, а получается, они обучали фулл параметров лёрнинг, да, то есть, а, полное дообучение всех параметров или именно
Дмитрий: Да-да-да, вот, о том идёт речь, что они учили полнорангово, то есть не LORA адаптер, а именно все веса изначально. Поэтому они сходились к лучшим решениям. Не лору, а именно всю сетку.
Из зала: При этом они сравнивались с лорой, в которой дообучали только добавку. Или в лоре тоже обучали всю модель?
Дмитрий: В лоре по построению обучают только добавку.
Из зала: Угу.
Дмитрий: Вот, но, а, смотрите,
Из зала: Тогда, в принципе, логично, что у них результаты лучше получились.
Дмитрий: Логично, но при этом им надо меньше памяти, а у них больше вычислительная большая производительность, то есть больше больше они прогоняют в секунду. Смотрите, вот, если посмотреть, у них тут есть табличка в приложении, кстати, вот в доказательствах в приложении, того и того весьма вероятного низкого ранга, и вот у них здесь есть производительность. И вот смотрите, а, что у нас на самом-то деле производительность GaLore, она близка к производительности голого Адама и больше, чем производительность Адафактора. Вдвое почти в полтора раза. Они достаточно быстро работают, им надо мало памяти, они сходятся к хорошим решениям, чего мы ещё хотим.
Из зала: Угу. Получается получается
Дмитрий: Реквест в попугаях. Меньше, чем половина. Половина звучит красиво. Сейчас я его расшарю.
Из зала: Вот я, видимо, упустил этот момент, за счёт чего тогда они выигрывают в памяти? В лоре же мы все параметры обучаем, мы только в добавке, да, низкоранговые, там, 10% от общего числа.
Дмитрий: Да, смотрите, мы в лоре обучаем все добавки все параметры только в добавке, но для них всё равно мы тащим Утроенное количество оптимизатором памяти.
Из зала: В оптимизаторе мы же тоже не храним градиенты, а все
Дмитрий: В оптимизаторе мы храним первый и второй моменты обязательно. Адам хранит первый и второй моменты градиентов. Он просто так устроен.
Из зала: Угу.
Дмитрий: Откуда, собственно, утроенный размер памяти на оптимизатор. Адам, он очень хороший и очень дорогой по памяти. Оптимизатор, который занимает место больше, чем сами веса модели, это вот так вот. В чём, собственно, и замес, если бы он не был такой дорогой, никто бы не мучился. И вот собственно, как устроен Адам В, их версия. Просто вот заменяете свой Адам В на их Адам В. Мы берём, Инициализируемся и дальше а, сейчас. Если проектора у нас нет, то мы его получаем. Вся магия у нас вот построение проектора здесь. Магия построения проектора, а, такая. Мы смотрим какой именно, есть ли он у нас или нет.
Дальше мы берём и делаем СВД делаем и берём несколько верхних компонент, и всё. Очень технологично, очень хорошо. Опять же, это не полное СВД, это транкейт СВД в торче. Он считает объём памяти и там вот. Такая вот Моделька.
Из зала: Вот помимо лоры же тоже много потом выходило новых методов дообучения, а, в том числе вычислительного по времени, по памяти. Точно сейчас название не буду врать.
Дмитрий: Да, их там много, но, собственно говоря,
Из зала: С ними они сравнивались?
Дмитрий: Они сравнивались с тремя из них. Они, а на самом деле они говорят, что, во-первых, есть метод проектированных градиентов, и, в принципе, то, что они делают, это частный случай этого метода просто. Вот, то есть Project Gradient Learning или как-то там. Вот, а, что вот мы вот эту идею просто взяли и хорошо так технологично применили. Теперь, а, есть ещё такая достаточно тривиальная идея: зачем нам, в принципе, всю матрицу весов учить? Давайте мы её факторизуем и будем учить вот эти вот две половинки её. Такая матрица, а, такие веса сходятся к плохому минимуму, и в статье есть сравнения с ними. Есть лора, есть релора, а, есть целый класс этих подходов.
Есть, например, лома. С лома почему-то они его упоминают, но не сравниваются. Лома как раз, почему интересно, что они с лома не сравниваются, потому что лома очень экономичный по памяти, а, но лома на базе СГД. Вот, то есть они идеи из лома использовали у себя, но сравниваться с лома не стали. Может быть, им так некомфортно себя сравнивать с оптимизатором, который вообще памяти почти не потребляет. Выигрыш не будет так заметен. В любом случае, мне кажется, это немного, но это очень хорошая работа. Вот прямо Понравилось, что они прямо взяли и, а, сразу всё выложили, всё разложили, все ссылки дали и на пип закинули, и вот, пожалуйста, вот GaLore Torch ставите и используете.
И дальше они у них тут есть примеры того, как они запускали то, запускали это. При всей сомнительности двадцати пяти статей за январь-февраль опубликованных, а, придраться не к чему. Очень хорошо, так качественно сделанная работа.
Из зала: Это точно. Так, есть а вы ещё сами не пробовали, может быть, этот метод вот этот GaLore? На одной видеокарточке, да?
Дмитрий: Вот я прямо планирую, если честно, этим заняться. У меня сейчас какой-то крендец чисто по другим делам, и вот, как он чуть-чуть разгребётся, я пойду использовать GaLore. Вот, причём они что говорят, что, вообще-то говоря, метод придуман для LLM-ок, но он, вообще-то модель агностик, то есть сам по себе подход, он, Хмм, базируется просто на предположении, что у нас, Хмм, градиент имеет внутреннюю структуру меньшей размерности, чем мы его в памяти держим. Я думаю, что для картинок это тоже так. Я думаю, что GaLore будет работать для картинок ровно так же, как и для LLM-ок. Что тоже удобно. Потому что можно будет батчи больше делать и так далее.
Из зала: Получается, с их методом можно прямо в Кате 2 на одной там А100 обучать семимиллиардную модель?
Дмитрий: По видимости. Если есть А100-я модель, то вам не нужно больше параллелиться, скажем так. Если раньше вы там параллелились. Они ещё вот с чем сравниваются. Есть техники с выгрузкой градиента, а, и послойной выгрузкой. И они особо отмечают, что, ребята, мы добились вот этого, но мы ничего не выгружали, у нас всё в памяти находится. Потому что, если выгружать послойно градиент, то в общем, можно, конечно, и, а, меньшим количеством памяти обойтись.
Из зала: Это лома, кстати, с послойным градиентом.
Дмитрий: Нет. Лома она не так. Сейчас я лома послойно его применяет. Вот, то есть лома вот что делает. Мы прогнали фит форвард, и потом, когда мы идём назад, мы на одном слое посчитали Изменения весов, применили, стёрли. На другом посчитали, применили, стёрли, а не то, что мы по всем слоям прошли, посчитали и применили. Если мы прошли по всем слоям, посчитали, применили, у нас открываются интересные возможности для там числовой стабильности, нормализации, чего-то ещё, но вот вот так вот это. И это как раз они говорят, что вот у них тут есть, ага, что SGD можно использовать при трёх условиях, что если у вас гладкая поверхность потерь, после лекции Ветрова, кстати, я не верю в гладкие поверхности потерь. Вот, но вот Люди поопытнее мне пишут. Локальные оптимумы достаточно хороши и редкие седловые точки. Как в пространстве высокой размерности седловые точки могут быть редкими, я тоже не понимаю, потому что я представляю себе так, что почти все точки, они седловые должны быть, ну просто по теории вероятности, если у вас столько параметров, какой-нибудь, какая-нибудь производная будет не в ту сторону, у вас она получится седловая.
Вот пишут. Вот, что как раз для LLM это не так, и они базируют свои инсинуации на статье про Берт. Есть исследование, я на неё ссылался в слайдах, есть исследование того, как устроена поверхности потерь внутри Берта, и вот, что у предобученного Берта они такие хорошие, гладенькие, залюбуешься. Вот так.
Ведущий: Если больше нет особо вопросов, то я тогда предлагаю отпустить Дмитрия, чтобы он скорее успел приступить к тестированию.
Дмитрий: На самом деле, совещание ещё через 15 минут.
Ведущий: Тогда точно заканчиваем. Спасибо вам большое, что нашли время. Я думаю, что если будут вопросы, то всегда можно в чате задать.
Дмитрий: Да, можно мне стучаться. Я пришлю сейчас все материалы, Лине.
Ведущий: Всё. Спасибо большое, всем хорошего вечера.
Из зала: Спасибо.